
Grok 4.5发布:SpaceXAI与Cursor带来的工程性能提升及Agent功能
本文介绍了SpaceXAI发布的Grok 4.5及其与Cursor的集成应用。该模型在DeepSWE 1.0基准测试中获得62.0%的得分,展现了卓越的工程能力与跨学科推理水平。Grok 4.5在Agent任务中表现出色,通过“One Prompt”显著提升了工作效率,同时具备高输出效率和具有竞争力的定价策略,是值得开发者尝试的AI工具。

Grok 4.5 发布:SpaceXAI 与 Cursor 的“复仇”式反击,代码世界的规则变了
如果说大模型领域的竞争是一场没有终点的马拉松,那么 SpaceXAI 和 Cursor 在这一个月里上演的,简直是一场令人目瞪口呆的短跑冲刺。
当我看到 Grok 4.5 发布的消息时,最震撼我的不仅是它展现出的恐怖能力,更是其背后那种“被 OpenAI 和 Anthropic 戏耍后,誓要扳回一局”的决绝与行动力。作为工程师,我们太懂那种感觉了——在这个充满博弈的赛场上,只有通过产品实力的“硬碰硬”去赢下这一仗,所有的内耗与委屈才会烟消云散。
工程师眼中的“性能怪兽”
Grok 4.5 的发布并非简单的模型迭代,而是一次针对复杂工程任务的精准打击。它不仅仅是“变聪明了”,而是真正学会了如何像工程师一样思考、调试与构建。
通过对 DeepSWE 1.0 和 SWE Bench Pro 等基准测试的观察,我们可以清晰地看到它的定位:
- 工程化能力的飞跃: 在 DeepSWE 1.0 基准测试中,Grok 4.5 取得了 62.0% 的出色成绩,紧随 Fable 和 GPT 5.5 之后,证明了其在解决真实工程任务上的强大潜力。
- 不仅仅是代码: Grok 4.5 的训练数据不仅仅局限于代码库,还涵盖了高质量的 STEM 任务、研究论文及各类知识工作数据。这意味着它在处理逻辑复杂、需要跨学科推理的任务时,有着更深厚的内功。
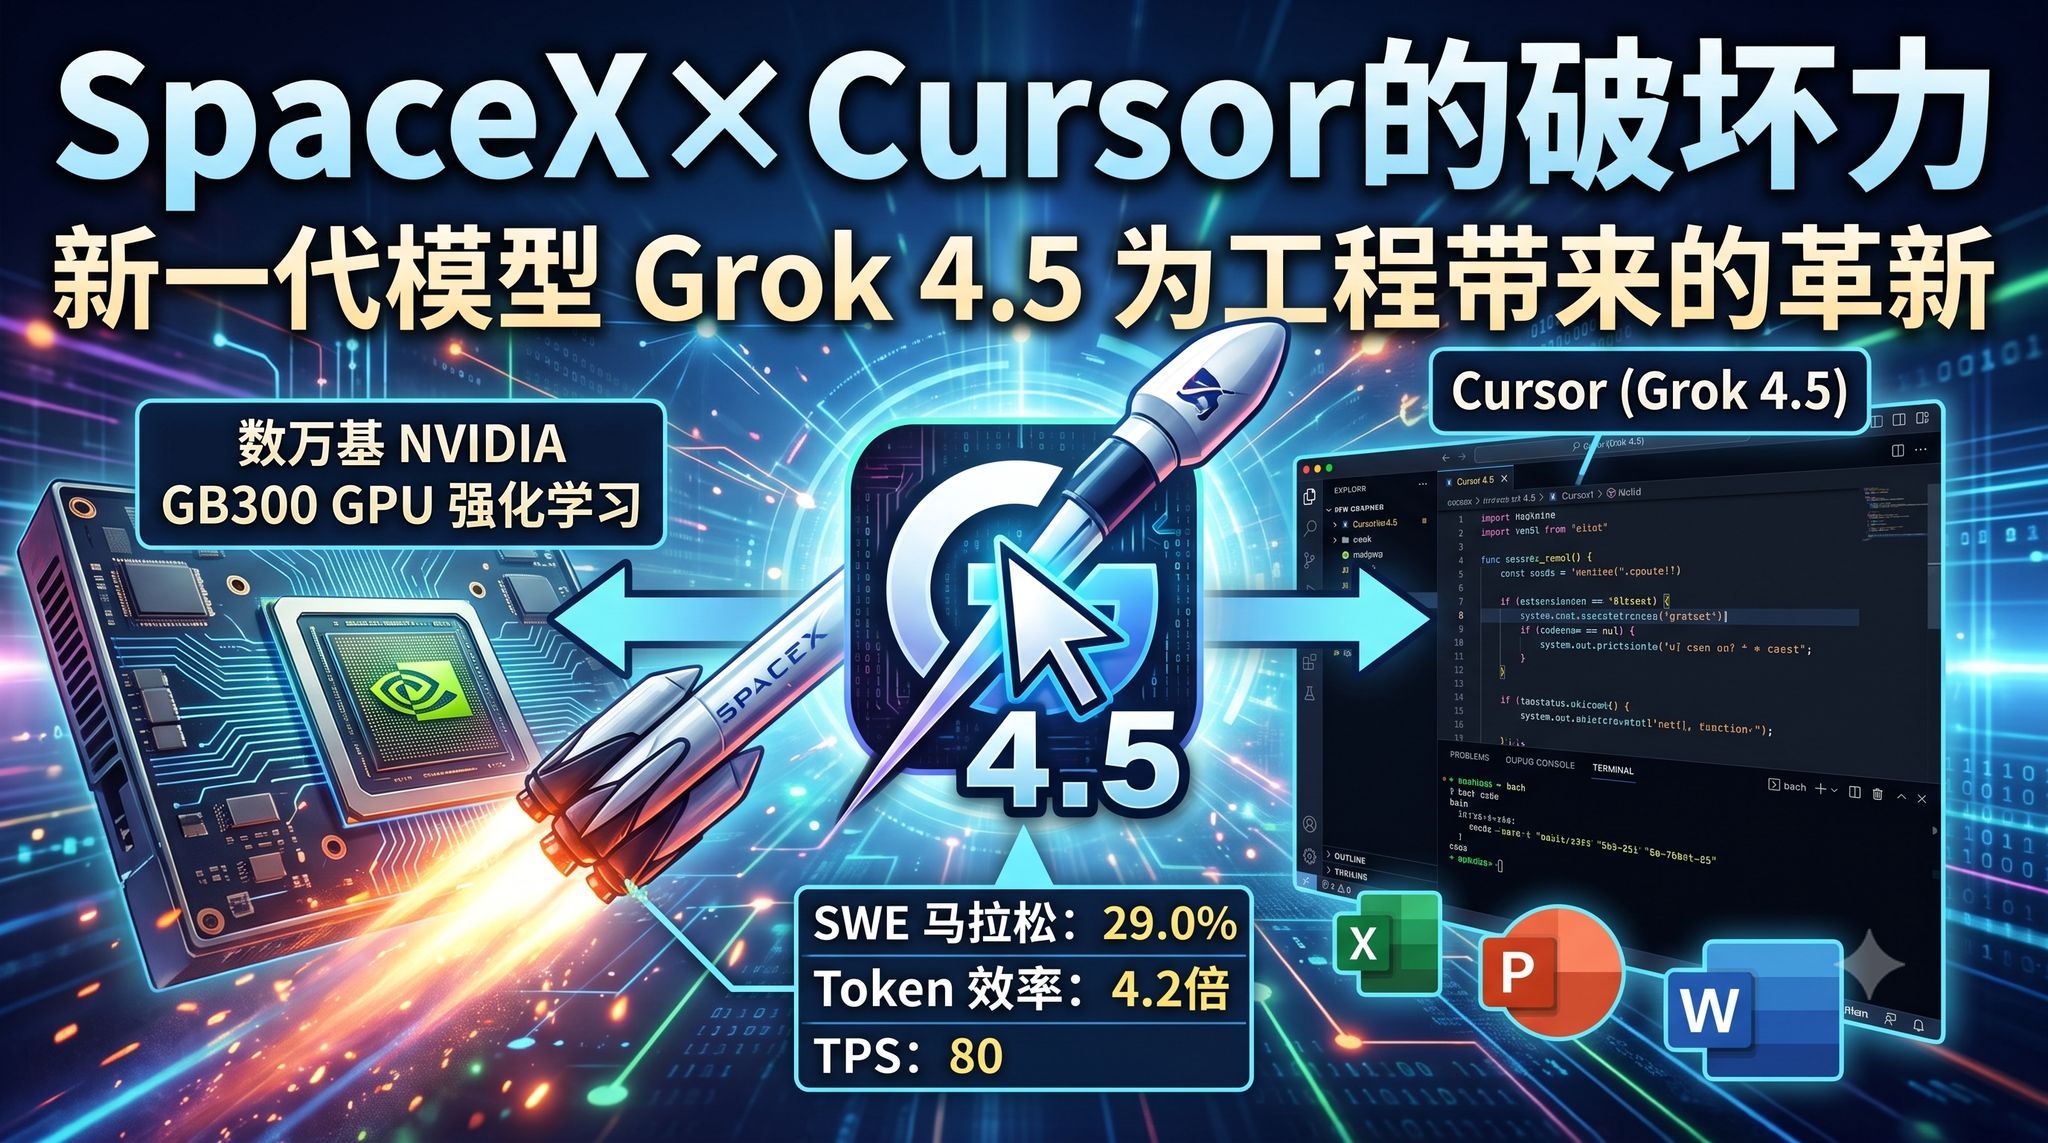
- 极致的效率: 这点尤其打动我。Grok 4.5 以 80 TPS(tokens per second)的速度运行,且在 SWE Bench Pro 任务中,其输出 token 效率是 Opus 4.8 (max) 的 4.2 倍。更少的 token 消耗意味着更快的响应速度和更低的成本。
“One Prompt”:从灵感到现实的极简路径
Grok 4.5 最让我惊喜的,是它在“Agentic Tasks”(代理任务)上的表现。在演示中,仅仅通过一个简单的 Prompt,它就能构建出复杂的 Solar System 模拟器或精美的 Q3 季度业务回顾演示文稿。
这种“从想法到成品”的能力,极大地降低了我们日常工作中的琐碎负担:
- 前端与可视化: 能够直接利用 Three.js 生成具有现代设计感的宇宙模拟 HUD,且具备交互式的时间轴控制。
- Office 自动化: 它不再仅仅是写写文档,而是能直接在 Excel 中构建涉及多页公式的复杂模型,或是在 PPT 中自动布局图形。
为什么我们应该关注这次发布?
这不仅仅是一次模型升级,它象征着一种“极客反击”的范式转移。SpaceXAI 投入了数万块 NVIDIA GB300 GPU,并针对大规模运行进行了深度的稳定性优化。这种对底层基础设施的掌控力,让它能够实现高度异步的训练,从而在处理长链路的代理任务时,表现出极高的鲁棒性。
而且,对于我们开发者来说,它的价格策略极具竞争力:$2/百万 input tokens 和 $6/百万 output tokens 的定价,配合其极高的 token 效率,让大模型在生产环境中的落地成本变得更加可控。
结语:为了那场盛大的胜利
Grok 4.5 的背后,是一个团队憋着一口气想要证明自己的决心。在这个变幻莫测的 AI 时代,我们每个人都在寻找那种“世俗意义上的成功”——不是为了证明别人错了,而是为了证明自己在正确的赛道上,拥有能够改变规则的能力。
现在,Grok 4.5 已经可以通过 Cursor 或 API 调用。无论你是想体验其代码构建能力,还是想测试它的 Agentic 工作流,这无疑是目前最值得尝试的技术工具之一。
去试用一下吧,或许在下一个 Prompt 中,你也能感受到这种“少年气”回归的快感。