
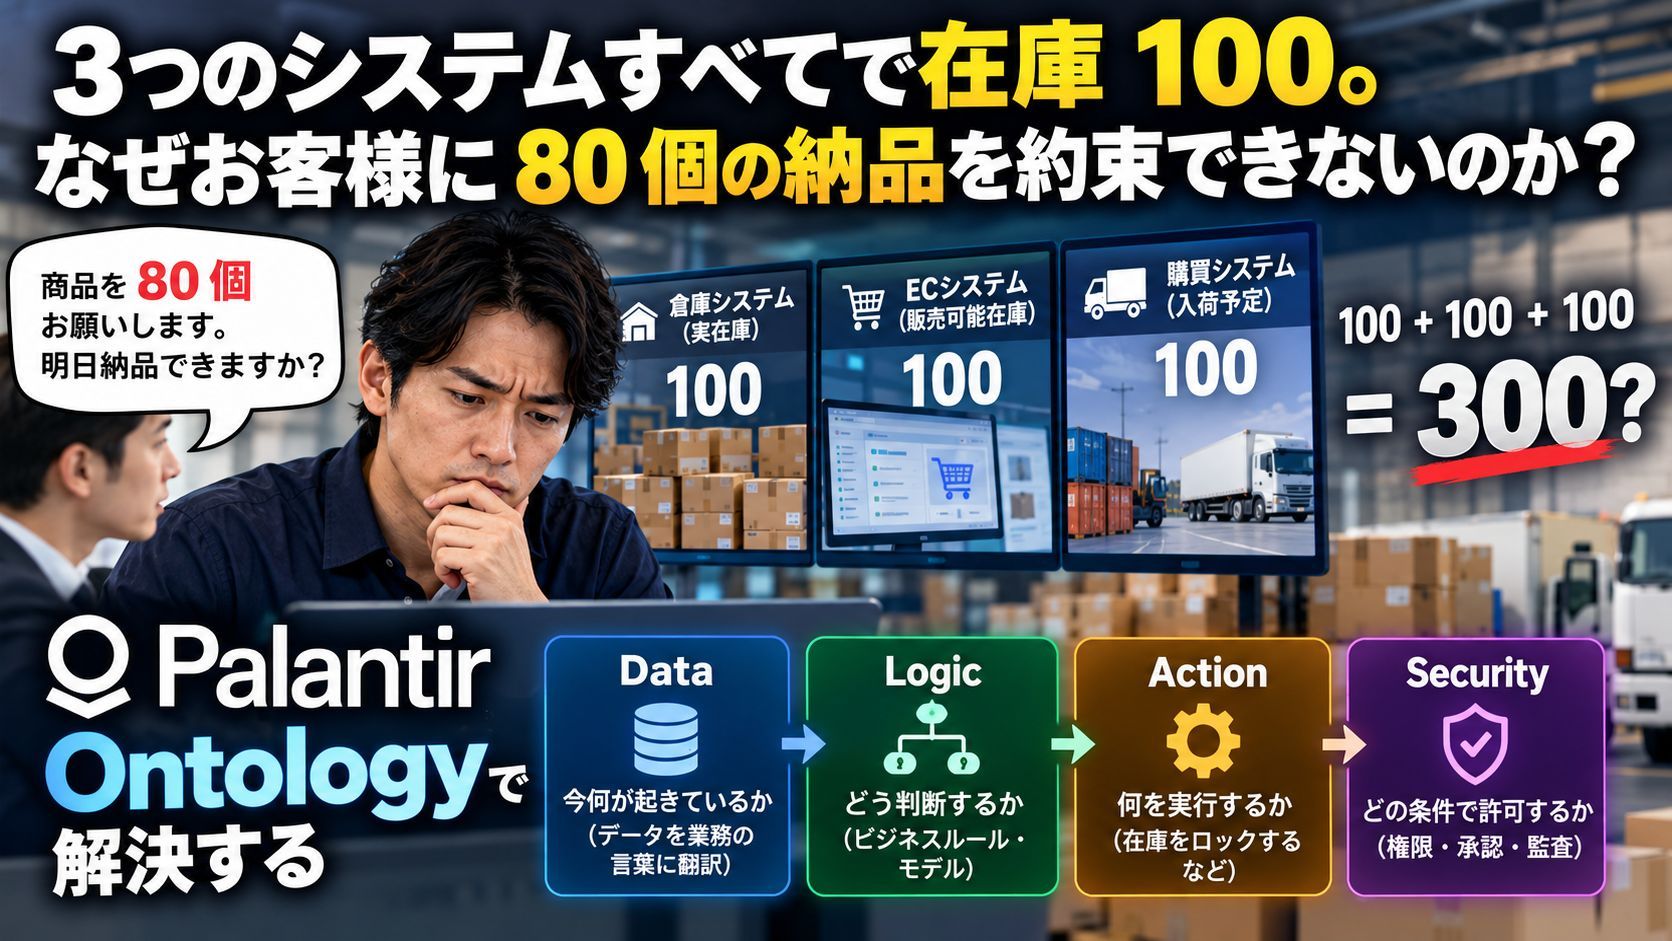
3つのシステムが在庫100でも300個は約束できない——Palantir Ontologyから学ぶエージェント時代の企業AI
倉庫・EC・購買がそれぞれ在庫100と表示しても、合計して300個を約束することはできません。Palantirは業務判断をData・Logic・Action・Securityに分解し、Object・Property・Linkで業務世界を記述します。本記事は在庫の例でOntologyの核心を解説し、大規模言語モデル時代に同じ理念をskillsやMCPで実現し、agentを先に作り共通部分を育てる道筋を提案します。

3つのシステムが在庫100と表示しても、なぜ顧客に80個の納品を約束できないのか
ある顧客がこう聞いてきました。「80個の商品が欲しい。明日納品できるか」
あなたは3つのシステムをそれぞれ確認します。倉庫管理システムは実在庫100個、ECシステムは販売可能在庫100個、購買システムは輸送中100個と表示しています。100+100+100で300。ならば最大300個納品できるのか。
明らかに違います。
倉庫にある100個のうち、一部はすでに他の受注で押さえられているかもしれませんし、一部はまだ入庫やピッキングが完了していないかもしれません。ECシステムの100個は複数の倉庫に分散していて、1件の注文としてまとめられないかもしれません。購買システムに100個があるのは確かでも、明日には届かない可能性があります。
つまり、データを検索できることは、そのデータが業務上いったい何を意味するのかを分かっていることにはなりません。これがまさに、PalantirのOntologyが解こうとした問題です。
Palantirは実際の業務判断を4つに分解する
Palantirの枠組みでは、1つの実際の業務判断は4つの部分に分けられます。
- Data:今何が起きているのか
- Logic:どう判断すべきか
- Action:次に何をするのか
- Security:どのような条件なら実行を許すのか
在庫の例で、1つずつ見ていきます。
Data:テーブルを寄せ集めるのではなく、データを業務の世界へ翻訳する
Palantirが言うDataは、データベースのいくつかのテーブルを単純に結合することではありません。システムの中にあるデータを、業務の世界の言葉に翻訳することです。
ここで使われるのが、Object、Property、Linkという最も基本的なモデリング要素です。かみ砕いて言えば、こうなります。
- Object:これは何か
- Property:これにはどんな特徴があり、今どんな状態か
- Link:これと他のものはどんな関係か
たとえば注文は1つのObjectになれます。個々の注文には、注文ステータス、金額、作成日時といったPropertyがあります。商品も1つのObjectで、商品名、SKU、カテゴリ、価格といったPropertyを持てます。そして注文と商品の間にはLink、つまり関係があります。この注文がどの商品を含むのか、という関係です。1つの注文は多くの商品を含めますし、1つの商品が多くの注文に現れることもあります。
Palantirは公式に、Object、Property、LinkをOntologyのSemantic Elements、つまり業務の世界を記述するための意味要素と呼んでいます。
ここまで聞くと、多くの人の第一反応は私と同じでしょう。これは知識グラフではないのか、と。もしOntologyがオブジェクト、属性、関係の定義だけなら、確かに知識グラフやセマンティックレイヤー、あるいはドメインモデリングと非常によく似ています。しかしPalantirはもう一歩先へ進みます。
Logic:事実を「知る」から「判断する」へ
在庫の話に戻ります。ここであなたはすでに、倉庫に実在庫が100個あり、そのうち20個はすでに押さえられ、10個は引当・凍結され、さらに輸送中が100個あるが届くのは明後日だと知っています。業務の世界は読めるようになりました。
しかし上司が聞いているのはこうです。「明日80個納品できるのか」
つまり、事実を知っているだけでは足りません。業務上の判断ができなければならないのです。ここでPalantirのより核心的な層に入ります。世界を記述するだけでなく、企業がその世界の中で意思決定できるようにする。これがLogicです。
たとえば企業内部には1つのルールがあります。明日約束できる在庫は、実在庫から引当と凍結を引き、さらに明日までに届く在庫を足したものだ、というルールです。これで計算すると、100 − 20 − 10 に 0 を足して70になります。顧客は80個を求めているので、約束できません。
Palantirでは、このLogicを関数、ルール、モデルなどで実装できます。たとえば約束可能数量を計算する関数を書けば、在庫、引当、輸送中の状態、入荷時間を入力し、納品可能な数量を出力できます。仮に顧客が求めたのが60個なら、システムは受けられる判断を下せます。
Action:「できます」と答えるだけでは足りない、業務状態を実際に変える
しかしAIが「できます」と答えるだけなら、本質的にはまだQ&Aシステムです。企業が本当に必要としているのは、その60個の在庫を実際に押さえることです。
Palantirでは、このように業務状態を実際に変える能力をActionと呼びます。在庫を押さえることもActionですし、返金もActionです。これはOntologyと単なる知識グラフの重要な違いの1つです。Ontologyは、世界が今どうなっているかを機械に伝えるだけでなく、機械が本当に世界を変えることを許します。
Security:実行できるようになった後、境界そのものが業務ロジックになる
AIが実際に在庫を押さえ、返金し、注文をキャンセルできるようになると、すぐ次の問題が来ます。
60個の在庫は自動で押さえてよいとして、6000個ならどうか。100円の返金は自動で実行してよいとして、10万円ならどうか。どの操作をAIが直接実行でき、どれが人の確認を必要とし、どれが必ず上長の承認を必要とするのか。
これがSecurityです。ですからSecurityは、最後に権限設定を1つ足せば済む話ではありません。AIが実際に操作を実行し始めた後では、誰ができるのか、どんな条件ならできるのか、承認が必要かどうかは、それ自体が業務ロジックの一部なのです。
Palantirはそれを具体的に何にしたのか
ここまでがOntologyの核心的な考え方です。ではPalantirは、それを具体的に何にしたのでしょうか。
公式には、Ontologyのシステムをlanguage、engine、toolchainの3つに分けています。languageは業務の世界を定義し、engineはそれらのオブジェクトを照会・変更できるようにし、toolchainは開発者のアプリケーションとagentがこのOntologyを実際に使えるようにします。ですから正確に言えば、PalantirのOntologyは静的な業務モデルではなく、業務モデルと実行可能な状態を組み合わせたものなのです。
よく耳にするFoundry、AIP、Apolloについては、それほど複雑に考える必要はありません。Foundryはどちらかといえばデータと運用、AIPは大規模言語モデルとagentのプラットフォーム、Apolloはプラットフォームのデプロイと継続的デリバリーを担います。Ontologyは4つ目のプラットフォームではなく、アーキテクチャ全体の核心システムであり、Palantirは公式にそれをアーキテクチャ全体のheartと呼んでいます。
ほとんどの企業にとっては、ここまで理解すれば十分です。各プラットフォームの内部実装を細かく追う必要はありません。そもそも私たちがPalantirの技術体系をそのまま複製することはないからです。本当に面白いのは次の一歩、大規模言語モデルの時代に何を参考にできるかです。
大規模言語モデルの時代、何を参考にできるのか
以前、企業にはERP、CRM、WMS、OAなど多くのシステムがあり、それらは分断されていました。それでも当時は、なぜそれほど深刻に感じなかったのか。なぜOntologyが必要だと思わなかったのか。
それは、間に「人」というとても重要なものがいたからです。何年もサプライチェーンを担当してきた責任者は、3つのシステムに在庫100と書いてあるからといって、そのまま300個を約束したりはしません。どの数字は信じられて、どの数字は割り引いて見るべきかを知っています。大規模言語モデルはagentに推論能力を与えましたが、企業はそのagentに、自分が推論しているのはどんな世界なのかを教えなければなりません。
PalantirのOntologyは大規模言語モデルの前に生まれました。それが表しているのは、非常に典型的な明示的モデリングの思考です。まず業務の実態を明確に定義し、そのモデルの上でソフトウェアとAIを動かす。
しかし今日は違います。Claudeに代表される新しい世代のagent harnessは、自然言語理解、推論、ツール選択、コード実行、コンテキスト管理という強い能力をすでに備えています。さらに私たちにはskills、ナレッジベース、MCPがあります。かつて事前に構造化し、工学化し、明示的にモデリングしなければならなかった多くのものは、今や実行時にagentへ理解と組み合わせを任せられます。
ですから、今日ゼロから企業のagentを作るなら、参考にすべきはPalantirが問題を解く理念であり、元の実装方法をそのまま真似ることではありません。
Data:agentには注文ステータス、顧客情報、商品、物流といったデータが必要です。単純な場面では、それらを完全にobject、property、linkとして作り込む必要は必ずしもありません。toolやMCPを通じてERP、CRMなどのシステムに直接問い合わせ、schemaとcontextでモデルにこれらのデータが何を意味するのかを伝えられます。
Logic:判断の余地がある多くのフローは、skillの中に入れるか、ツールにできます。
Action:さらに直接的です。返金、在庫の確保、注文のキャンセルは、agent harnessの中では通常toolです。基盤側でAPIを直接呼んでもよいですし、MCPを通じてagentに公開してもかまいません。
Security:この点はagentの時代に、以前よりもむしろ重要です。100円の返金は自動実行してよく、1万円は人の確認が必要で、10万円ならそもそもその権限をagentに渡すべきではありません。そしてこれらはpromptやskillに書いてモデルの自覚に頼るべきものではありません。本当の境界は、tool権限、API権限、承認、監査に置かれるべきです。
Ontologyを先に作ってからAgentを作る、のではない
企業はPalantirを研究した後、「私たちも企業のOntologyを作ろう」と慌てて着手すべきではありません。
今、agentが1つで業務シナリオも1つしかないなら、skillとMCPを使って、まず業務を動かしてください。最初からOntologyのために多くの抽象化を前倒しで行う必要はありません。
しかしagentが増えていくにつれて、徐々に気づくはずです。カスタマーサポートのagentと営業のagentが同じorderを使っているのに、双方のorderの定義が違うかもしれない。同じ文が3つのskillにそれぞれ書かれている。異なるMCPが返すcustomerの構造がまったく違うかもしれない。十数のagentが返金、注文作成、在庫確保を必要としているのに、どのagentも自前でツールを1セット包んでいる。
この段階になって初めて、本当に重複しているものを取り出すべきです。複数のagentが繰り返し使うcustomer、order、productなら、それらの業務概念を少しずつ統一していく。複数のskillが繰り返し使う確定的な判断なら、共通のコードやツールとして抽象化する。複数のagentが同じ業務アクションを必要とするなら、共通のbusiness actionとして蓄積する。
つまり、Ontologyを先に建設してからagentを作るのではなく、まずagentを作り、agentが増え業務が複雑になった後に、本当に安定と再利用が必要なものを徐々に沈殿させていくのです。
この2つのパラダイムを比べると、PalantirはどちらかといえばOntologyを先に作ってからアプリケーションを作ります。しかしagentの時代は、むしろagentを先に作り、Ontologyを複雑さとともにゆっくり育てていくものです。
これこそが、今日Palantir Ontologyを改めて研究する最も価値のある点だと私は思います。私たちは過去に戻ってすべての業務をモデリングし直すのではありません。それを通して、1つの問いを改めて点検するのです。agentが本当に企業の運営に入り込んだ後、企業AIは大規模言語モデルにツールを山ほど載せただけでは済まない。私たちは依然としてagentに、十分に明確な業務の世界、判断と行動の能力、そして安全境界を与える必要があるのです。