
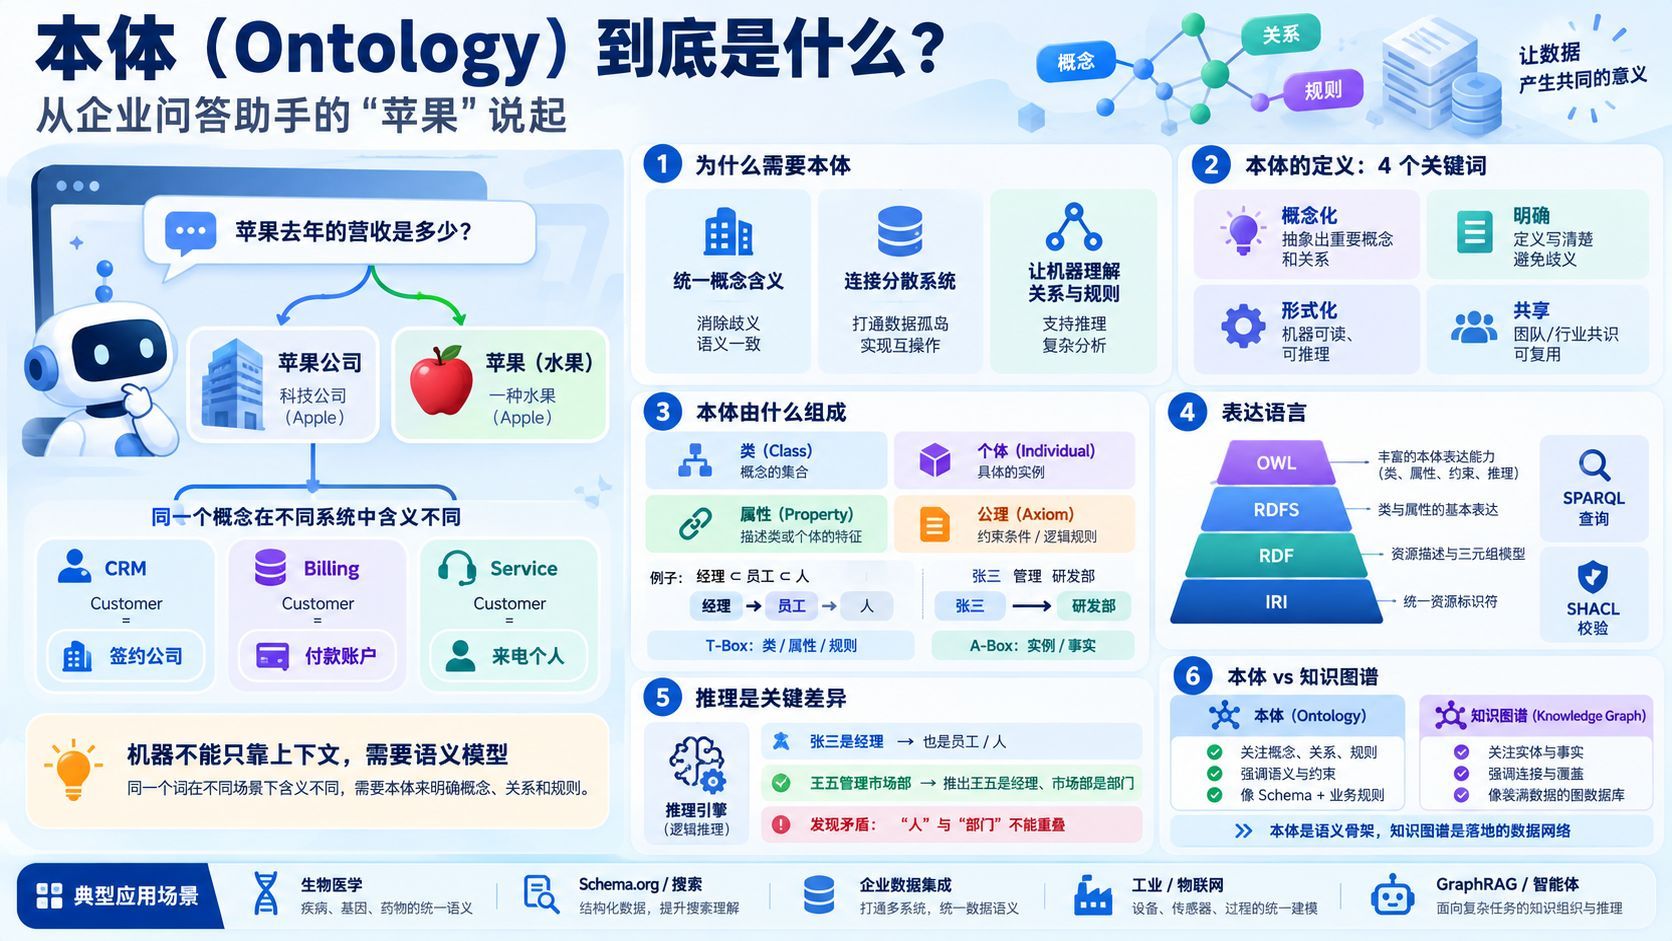
本体(Ontology)到底是什么:从企业问答助手的“苹果”说起
要让企业问答助手分清“苹果”是公司还是水果,并理解三张都叫 Customer 的表,机器需要的不是上下文,而是一个明确的语义模型——本体。本文从哲学起源讲到 Gruber 与 Studer 的定义,拆解类、个体、属性与公理,介绍 RDF、RDFS、OWL 及推理机的作用,梳理生物医学、Schema.org、企业集成、工业物联网和大模型时代的典型应用,并说明本体与知识图谱的区别以及动手构建的方法与常见错误。

本体(Ontology)到底是什么:从一个企业问答助手的"苹果"说起
假设你在做一个企业问答助手。用户问:"苹果去年的营收是多少?"
系统要正确回答,得先弄清一件事:这里的"苹果"是一家公司,不是一种水果。它还要处理一个更隐蔽的麻烦——数据分散在多个系统里,而它们对同一个词的理解并不一致。CRM 里的"客户"指的是签过合同的公司,计费系统里的"客户"是一个付款账户,客服系统里的"客户"又是打过电话的个人。三张表都叫 Customer,含义各不相同。
人可以靠上下文分辨这些差异,机器做不到。要让机器知道一个东西是什么、和什么有关、要遵守哪些规则,就需要一个明确的、形式化的语义模型。这就是本体。
从哲学到人工智能
Ontology 这个词来自哲学,中文译作"本体论",研究的是存在本身:世界上有哪些事物、它们怎样分类、彼此是什么关系。这个传统可以一直追溯到亚里士多德的范畴理论。
上世纪 90 年代,人工智能领域借用了这个词。1993 年,Tom Gruber 给出了一个被广泛引用的定义:本体是对概念化的明确规范说明。1998 年,Studer 等人把它补充为:对共享概念化的形式化、明确的规范说明。
这个定义里有四个关键词:
- 概念化:对某个领域做抽象,挑出重要的概念和关系。
- 明确:概念、关系和约束都要写出来,而不是藏在代码里或者某个人的脑子里。
- 形式化:用有严格语义的语言来描述,机器能读取,也能据此推理。
- 共享:它代表一个团队、一个行业乃至一个社区的共识,而不是某个系统的私有约定。
如果你熟悉面向对象或者数据库,可以先这样理解:本体有点像类图或 ER 模型,规定了有哪些类型、属性和关系。不同的是,本体里的每条声明都有逻辑语义,机器能推出没有直接写出来的结论,而且这套定义可以跨系统复用。
本体由什么组成
用一个具体例子来看本体的构成。领域是一家公司,里面有人、员工、经理、组织和部门。
第一类是类(class),也叫概念。类可以组成层次:经理是一种员工,员工是一种人。这种"是一种"的关系叫子类关系(subclass of)。
第二类是个体(individual),也叫实例,指具体的事物。张三是一个经理,研发部是一个部门。个体和类之间用类型关系(type)连接。
第三类是属性。 对象属性连接两个个体,比如"张三管理研发部""李四就职于研发部";数据属性把个体和一个具体的值连起来,比如"李四的入职日期是 2021 年 3 月 1 日"。
第四类是公理,也就是约束和规则。比如"管理"这个属性的定义域是经理、值域是部门;每个员工至少就职于一个部门;人和部门互不相交——一个东西不可能既是人又是部门。
类和属性的定义加上公理,构成本体的数据层,在描述逻辑里叫 T-Box;具体的个体和事实构成断言层,叫 A-Box。记住这两个词,讲知识图谱时还会用到。
用什么语言表达
本体需要一种标准语言来表达。W3C 在语义网项目里制定了一整套标准,通常被画成一个分层的蛋糕。从下往上看:
最底层是 IRI,给每个事物一个全局唯一的标识。两个系统只要使用同一个 IRI,说的就是同一个东西,这是跨系统数据集成的基础。
往上是 RDF。RDF 把所有知识都表示成三元组——主语、谓语、宾语。"张三管理研发部"就是一个三元组,许多三元组连在一起就成了一张图。
RDFS 在 RDF 上加入了最基本的模式词汇:类、子类、属性的定义域和值域。用它已经可以描述一个简单的类层次。
OWL(Web 本体语言)以描述逻辑为理论基础,表达能力更强。它可以声明互斥的类、基数限制、逆属性和传递属性,还能用已有的类组合出新的类。
下面这段用特殊语法写的本体,前两行定义员工和经理两个类以及它们的子类关系,中间定义"管理"这个属性的定义域和值域,最后两行是关于张三的事实。
查询用 SPARQL,写法像 SQL,匹配的是图模式;数据校验用 SHACL,可以检查"每个员工必须有入职日期"这类约束。
这里有一个工程师很容易踩的坑:OWL 采用开放世界假设。在数据库里查不到一条记录,往往就认为它不成立;但在 OWL 里,没有写出来的只是未知,不等于假。例如本体规定每个员工至少就职于一个部门,而李四的数据里没有部门——数据库的约束会直接报错,OWL 推理机却会认为李四一定从属于某个部门,只是暂时不知道是哪个。要检查数据是否完整,应该用 SHACL,它按封闭世界的方式来验证。
推理:本体和普通数据模型最大的区别
推理机读取本体和数据,按照逻辑规则自动推出隐含的事实。常见的有几种。
第一种是沿着类层次推理。 张三是经理,经理是员工的子类,员工又是人的子类,所以推理机可以得出张三也是员工、也是人。
第二种来自定义域和值域。 假设数据里只写了一句"王五管理市场部",没有说王五是什么。因为"管理"的定义域是经理、值域是部门,推理机会推出王五是经理、市场部是部门。
第三种来自属性的特征。 "下属"可以声明为传递属性:测试组下属于研发部,研发部下属技术中心,那么测试组也下属于技术中心。"管理"和"被管理"可以声明为互逆属性,只写一个方向,另一个方向自动成立。
推理机还能检查一致性。如果有人把研发部同时标成"人",而本体声明人和部门互不相交,推理机就会报告矛盾。这相当于在逻辑层面给数据跑了一遍单元测试。
常用的推理机有 HermiT、Pellet 和 ELK。要注意表达能力越强,推理的计算代价越高。所以 OWL 2 定义了 EL、QL、RL 三个子语言,在表达力和性能之间做取舍:EL 适合大型医学术语库,QL 适合在关系数据库上做查询改写,RL 适合用规则引擎实现。
本体真正落地的五类场景
第一类是生物医学,这是本体应用最成熟的领域。基因本体(Gene Ontology)用统一的术语描述基因的功能,分成分子功能、生物过程、细胞组分三个分支,全世界的研究者都用它来标注数据。临床术语体系 SNOMED CT 包含超过 35 万个概念,用于电子病历编码,它的逻辑定义就是用 OWL 表达的。
第二类是 Schema.org。它由 Google、微软、雅虎和 Yandex 在 2011 年共同发起,定义了产品、组织、事件、菜谱等数百种类型。网站把这些标注嵌进网页,搜索引擎就能读懂页面内容,展示出价格、评分这样的富结果。
第三类是企业数据集成。金融业有 FIBO,用统一的金融业务本体定义合同、证券、交易对手等概念。Palantir 这样的数据平台则把本体当作语义层:把散落在各个系统里的数据映射成订单、客户、设备这样的业务对象和它们之间的关系,再在上面构建分析和应用。
第四类是工业和物联网。在数字孪生里,本体描述设备、传感器和空间位置之间的关系。W3C 的 SOSA 和 SSN 本体专门描述传感器和观测,Brick Schema 则用来描绘楼宇里的设备和测点。
第五类是大模型时代的新用法。 一是用本体约束信息抽取,让大模型按照预先定义的类和关系从文本里抽取三元组,结果更规范;二是 GraphRAG,本体决定了知识图谱的结构,帮助检索出更相关的上下文;三是给智能体提供语义层,让它准确理解业务概念和可执行的操作,降低出错的概率。
本体和知识图谱到底有什么区别
2012 年 Google 推出知识图谱,口号是 "Things, not Strings"——要识别的是事物,而不只是字符串。从那以后,知识图谱这个词流行起来。它的核心是一张由实体和关系构成的大图,比如"达芬奇创作了蒙娜丽莎""蒙娜丽莎收藏于卢浮宫"。
用前面的术语来说,本体主要是 T-Box,定义有哪些类、哪些关系、要遵守哪些规则;知识图谱以 A-Box 为主,是大量具体的实体和事实,通常还带着一个模式层,而这个模式层往往就是一个本体。
打个工程上的比方:本体像数据库的 schema,再加上约束和业务规则;知识图谱像是按照这个 schema 挂满了数据的数据库。也可以说,本体是城市的规划图,知识图谱是建成以后的城市。
具体看几个维度:
- 关注点:本体关心概念和语义是否准确,知识图谱关心事实是否全面、连接是否丰富。
- 规模:本体通常有几十到几万个类,大型知识图谱的事实可以达到数十亿条。
- 构建方式:本体一般由领域专家自顶向下设计,强调共识;知识图谱更多是从数据库、网页和文本中自底向上抽取,强调覆盖率和自动化。
- 技术:本体用 RDFS、OWL 和推理机;知识图谱可以存放在 RDF 三元组库里,也常用 Neo4j 这样的属性图数据库,后者通常没有形式化语义。
两者并不对立。DBpedia 就是一个好例子:它从维基百科里抽取了海量实体,这是知识图谱;它同时维护着一个 DBpedia 本体,定义了人物、地点、作品等几百个类,这是本体。本体给知识图谱提供语义和约束,知识图谱让本体落到真实的数据上。
选型时可以这样判断:如果需要跨系统统一语义、做一致性校验或逻辑推理,本体是重点;如果目标是问答、推荐、搜索,或者给大模型做检索增强,可以先建知识图谱,再按需要加强它的本体层。
怎样动手构建一个本体
常见的做法是从能力问题开始:先列出这个本体需要回答的问题,比如"某个项目涉及哪些部门的员工",用这些问题来划定范围。然后尽量复用已有的本体,比如 Schema.org、FOAF、FIBO,不要重复造轮子。接着整理术语、搭建类层次、定义属性和约束、录入实例,最后用推理机和 SHACL 验证,再回到能力问题上迭代。
工具方面,建模可以用斯坦福大学的 Protégé,编程可以用 Python 的 RDFLib 或者 Java 的 Apache Jena,存储和查询可以用 GraphDB、Stardog 或 Amazon Neptune。现在也可以先让大模型起草术语和类层次,再由领域专家审核。
新手常犯三个错误:
- 把部分当成子类。 比如把发动机建模成汽车的子类,其实发动机是汽车的组成部分。
- 混淆类和实例。 研发部是部门的一个实例,而不是部门的子类。
- 过度建模。 一开始就追求大而全。
小结
本体是对共享概念化的形式化、明确的规范说明,由类、个体、属性和公理组成,用 RDF、RDFS 和 OWL 表达,用推理机推出隐含的知识。知识图谱是承载海量事实的图,本体是它的语义骨架。理解了本体,再去看知识图谱和企业语义层,就能看清它们背后共通的那套逻辑。