
オントロジー(Ontology)とは何か:Q&Aアシスタントの「アップル」から理解する
Q&Aアシスタントが「アップル」を企業か果物か判別し、同じCustomerという名前の3つのテーブルの意味の違いを扱うには、明確で形式化された意味モデルが必要になる。それがオントロジーだ。哲学に由来する概念が1990年代にAIへ取り込まれ、クラス・個体・プロパティ・公理で構成され、RDFやOWLで表現される。推論による暗黙知の導出、生物医学やSchema.orgでの応用、知識グラフとの違い、構築手順と初心者の誤りまでを解説する。

オントロジー(Ontology)とは何か:企業向けQ&Aアシスタントの「アップル」から考える
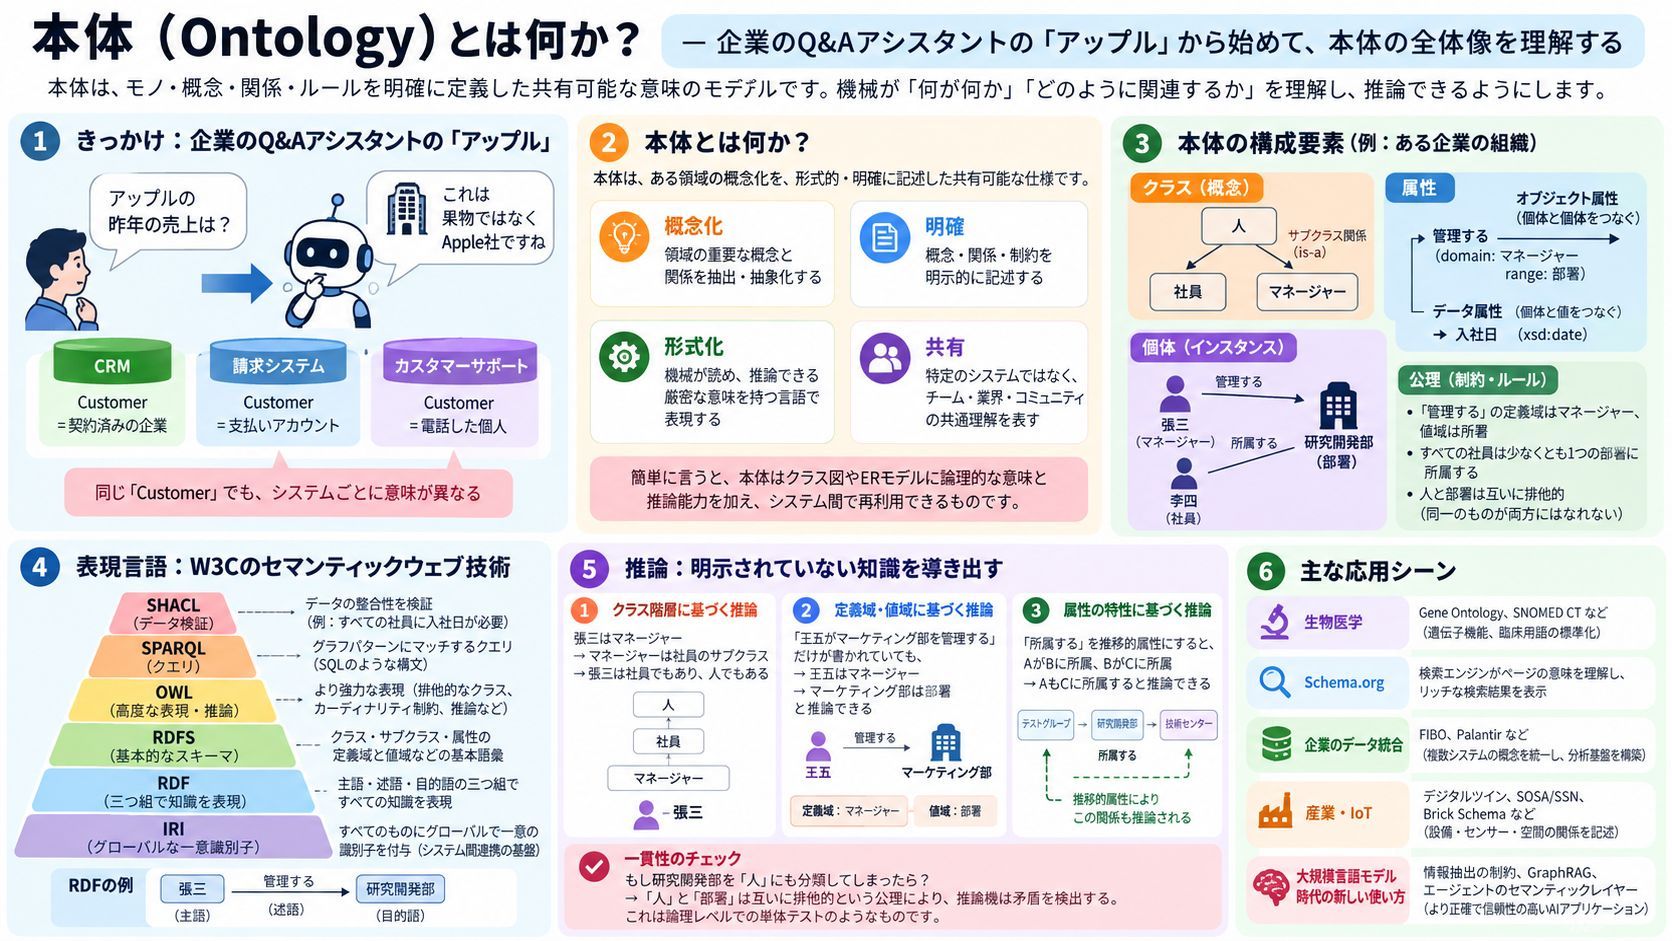
企業向けのQ&Aアシスタントを作っているとします。ユーザーが「アップル(Apple)の昨年の売上はいくらですか」と質問しました。
システムが正しく答えるには、まずこの「アップル」が企業であって果物ではないことを把握しなければなりません。さらに厄介な問題があります。データが複数のシステムに分散していて、同じ言葉の意味が一致していないのです。CRMの「顧客」は契約を結んだ企業、課金システムの「顧客」は支払いアカウント、カスタマーサポートシステムの「顧客」は電話をかけてきた個人を指します。3つのテーブルはどれも Customer という名前ですが、意味はそれぞれ異なります。
人間は文脈からこれらの違いを判断できますが、機械にはできません。あるものが何であるか、何と関係しているか、どんなルールに従うのかを機械に理解させるには、明確で形式化された意味モデルが必要です。それがオントロジーです。
哲学から人工知能へ
Ontology という言葉は哲学に由来し、中国語では「本体論(存在論)」と訳されます。研究対象は存在そのものです。世界にはどんな事物があり、それらはどう分類され、互いにどんな関係にあるのか。この伝統はアリストテレスの範疇論までさかのぼることができます。
1990年代になると、人工知能の分野がこの言葉を借用しました。1993年、Tom Gruber は広く引用される定義を示します。オントロジーとは「概念化の明示的な仕様である」と。1998年には Studer らがこれを補い、「共有された概念化の、形式的で明示的な仕様」としました。
この定義には4つのキーワードがあります。
- 概念化:ある領域を抽象化し、重要な概念と関係を選び出すこと。
- 明示的:概念・関係・制約を、コードや誰かの頭の中に隠さず、すべて書き出すこと。
- 形式的:厳密な意味論を持つ言語で記述し、機械が読み取れるだけでなく、それに基づいて推論できること。
- 共有:特定システムの私的な取り決めではなく、チームや業界、コミュニティの合意を表すこと。
オブジェクト指向やデータベースに馴染みがあるなら、まずはこう考えるとよいでしょう。オントロジーはクラス図やERモデルに少し似ていて、どんな型・属性・関係があるかを定めます。違いは、オントロジーでは一つ一つの宣言に論理的な意味論があり、機械が直接書かれていない結論を導き出せること、そしてその定義をシステムをまたいで再利用できることです。
オントロジーは何でできているか
具体的な例で構成要素を見てみましょう。領域は1つの企業で、そこには人、従業員、マネージャー、組織、部門があります。
1つ目はクラス(class)で、概念とも呼ばれます。クラスは階層を作れます。マネージャーは従業員の一種であり、従業員は人の一種です。この「〜の一種である」という関係をサブクラス関係(subclass of)と呼びます。
2つ目は個体(individual)で、インスタンスとも呼ばれ、具体的な事物を指します。張三はマネージャーであり、研究開発部は部門です。個体とクラスの間は型(type)の関係で結ばれます。
3つ目はプロパティです。 オブジェクトプロパティは2つの個体をつなぎます。たとえば「張三が研究開発部を管理する」「李四が研究開発部に所属する」といった具合です。データプロパティは個体と具体的な値をつなぎます。たとえば「李四の入社日は2021年3月1日である」という関係です。
4つ目は公理、つまり制約とルールです。たとえば「管理する」というプロパティの定義域はマネージャー、値域は部門であること。すべての従業員は少なくとも1つの部門に所属すること。人と部門は互いに素(disjoint)であり、1つのものが人でもあり部門でもあることはありえないこと。
クラスとプロパティの定義に公理を加えたものが、オントロジーのデータ層であり、記述論理では T-Box と呼ばれます。具体的な個体と事実はアサーション層を構成し、A-Box と呼ばれます。この2つの言葉は覚えておいてください。知識グラフの話で再び登場します。
どんな言語で表現するか
オントロジーを表現するには標準言語が必要です。W3CはセマンティックWebのプロジェクトで一連の標準を策定しており、それは通常、層状のケーキとして描かれます。下から順に見ていきましょう。
最下層は IRI で、すべての事物にグローバルに一意な識別子を与えます。2つのシステムが同じIRIを使っていれば、それは同じものを指します。これがシステムをまたいだデータ統合の基盤です。
その上は RDF です。RDFはすべての知識を主語・述語・目的語の三つ組(トリプル)として表します。「張三が研究開発部を管理する」は1つのトリプルであり、多くのトリプルがつながると1枚のグラフになります。
RDFS はRDFに最小限のスキーマ語彙を加えます。クラス、サブクラス、プロパティの定義域と値域です。これだけでも簡単なクラス階層を記述できます。
OWL(Web Ontology Language)は記述論理を理論的基盤とし、表現力がより高くなります。互いに素なクラス、基数制限、逆プロパティ、推移プロパティを宣言でき、既存のクラスを組み合わせて新しいクラスを作れます。
以下は特殊な構文で書かれたオントロジーです。最初の2行で従業員とマネージャーという2つのクラス、およびそのサブクラス関係を定義し、中間で「管理する」というプロパティの定義域と値域を定義し、最後の2行は張三に関する事実です。
クエリには SPARQL を使います。SQLに似た書き方で、グラフパターンをマッチさせます。データ検証には SHACL を使い、「すべての従業員に入社日があること」といった制約をチェックできます。
ここにエンジニアがはまりやすい落とし穴があります。OWLは開放世界仮説を採用しています。データベースではレコードが見つからなければ成り立たないとみなすことが多いのですが、OWLでは書かれていないものは単に未知であって、偽ではありません。たとえば、オントロジーがすべての従業員は少なくとも1つの部門に所属すると定めているのに、李四のデータに部門がないとします。データベースの制約ならエラーになりますが、OWLの推論機は李四が必ずどこかの部門に所属しているとみなし、ただ今はそれがどこか分からないだけだと考えます。データが完全かどうかを確認したいときは、閉世界の考え方で検証するSHACLを使うべきです。
推論:オントロジーと通常のデータモデルの最大の違い
推論機はオントロジーとデータを読み込み、論理規則に従って暗黙の事実を自動的に導き出します。よくあるパターンをいくつか挙げます。
1つ目はクラス階層に沿った推論です。 張三はマネージャーで、マネージャーは従業員のサブクラス、従業員は人のサブクラスです。したがって推論機は、張三は従業員でもあり人でもあると結論できます。
2つ目は定義域と値域による推論です。 データに「王五がマーケティング部を管理する」とだけ書かれていて、王五が何者か書かれていないとします。「管理する」の定義域はマネージャー、値域は部門なので、推論機は王五がマネージャーであり、マーケティング部が部門であると導きます。
3つ目はプロパティの特徴による推論です。 「部下である」を推移プロパティとして宣言できます。テストグループが研究開発部の部下で、研究開発部が技術センターの部下なら、テストグループも技術センターの部下になります。「管理する」と「管理される」は逆プロパティとして宣言でき、片方向だけ書けばもう片方向は自動的に成り立ちます。
推論機は一貫性のチェックもできます。誰かが研究開発部を同時に「人」とラベル付けしたのに、オントロジーが人と部門は互いに素だと宣言していれば、推論機は矛盾を報告します。これは論理のレベルでデータに単体テストを1回走らせたようなものです。
よく使われる推論機には HermiT、Pellet、ELK があります。表現力が高いほど推論の計算コストも高くなる点に注意してください。そのため OWL 2 は EL、QL、RL という3つのサブ言語を定義し、表現力と性能の間でトレードオフを取ります。ELは大規模な医学术語体系に、QLはリレーショナルデータベース上でのクエリ書き換えに、RLはルールエンジンによる実装に適しています。
オントロジーが実際に定着している5つの領域
1つ目は生物医学で、オントロジーが最も成熟して応用されている分野です。ジーンオントロジー(Gene Ontology)は遺伝子の機能を統一した用語で記述し、分子機能・生物学的プロセス・細胞構成要素という3つの分支に分かれています。世界中の研究者がデータのアノテーションに使っています。臨床用語体系の SNOMED CT は35万を超える概念を含み、電子カルテのコーディングに使われており、その論理定義はOWLで表現されています。
2つ目は Schema.org です。Google、Microsoft、Yahoo、Yandex が2011年に共同で立ち上げ、製品、組織、イベント、レシピなど数百種類の型を定義しました。サイトがこれらの注釈をページに埋め込むと、検索エンジンがページの内容を理解し、価格や評価といったリッチリザルトを表示できます。
3つ目は企業のデータ統合です。金融業界には FIBO があり、金融業務のオントロジーで契約、証券、取引相手といった概念を統一的に定義します。Palantir のようなデータプラットフォームはオントロジーをセマンティック層として使います。各システムに散在するデータを、注文、顧客、設備といった業務オブジェクトとその関係にマッピングし、その上で分析やアプリケーションを構築するのです。
4つ目は産業とIoTです。デジタルツインでは、オントロジーが設備、センサー、空間的な位置の関係を記述します。W3Cの SOSA と SSN はセンサーと観測を専門に記述するオントロジーで、Brick Schema はビル内の設備と測点を描くために使われます。
5つ目は大規模言語モデル時代の新しい使い方です。 1つはオントロジーで情報抽出を制約する方法で、あらかじめ定義したクラスと関係に従って大規模言語モデルにテキストからトリプルを抽出させ、結果をより規範的にします。2つ目は GraphRAG で、オントロジーが知識グラフの構造を決め、より関連性の高い文脈を検索できるようにします。3つ目はエージェントにセマンティック層を提供する方法で、業務概念と実行可能な操作を正確に理解させ、エラーの確率を下げます。
オントロジーと知識グラフは何が違うのか
2012年、Googleは知識グラフを発表し、「Things, not Strings」をスローガンに掲げました。文字列ではなく事物を識別するという意味です。それ以来、知識グラフという言葉が広まりました。その中核は、実体と関係からなる大きなグラフです。たとえば「ダ・ヴィンチがモナ・リザを制作した」「モナ・リザはルーヴル美術館に所蔵されている」といった関係です。
先ほどの用語で言えば、オントロジーは主に T-Box であり、どんなクラス、どんな関係、どんなルールに従うかを定義します。知識グラフは A-Box が中心で、大量の具体的な実体と事実であり、通常はスキーマ層も伴います。そしてこのスキーマ層は多くの場合、まさにオントロジーです。
エンジニアリングにたとえるなら、オントロジーはデータベースのスキーマに制約と業務ルールを加えたもの、知識グラフはそのスキーマに従ってデータを詰め込んだデータベースです。あるいは、オントロジーは都市の計画図、知識グラフは完成した後の都市だと言えます。
いくつかの次元で見てみましょう。
- 関心:オントロジーは概念と意味が正確かどうかを重視し、知識グラフは事実が網羅的でつながりが豊かかどうかを重視します。
- 規模:オントロジーは通常、数十から数万のクラスを持ちますが、大規模な知識グラフの事実は数十億件に達することがあります。
- 構築方法:オントロジーは一般に領域の専門家がトップダウンで設計し、合意を重視します。知識グラフはデータベース、Webページ、テキストからのボトムアップ抽出が中心で、カバレッジと自動化を重視します。
- 技術:オントロジーは RDFS、OWL、推論機を使います。知識グラフはRDFトリプルストアに置くこともできますし、Neo4j のようなプロパティグラフデータベースもよく使われます。後者は通常、形式的な意味論を持ちません。
両者は対立するものではありません。DBpedia はよい例です。ウィキペディアから膨大な実体を抽出しており、これは知識グラフです。同時に DBpedia オントロジーを維持し、人物、場所、作品など数百のクラスを定義しています。これがオントロジーです。オントロジーは知識グラフに意味論と制約を与え、知識グラフはオントロジーを実データの上に定着させます。
選定はこう判断できます。システムをまたいで意味を統一したい、一貫性の検証や論理推論をしたいなら、オントロジーが重点になります。目的がQ&A、推薦、検索、あるいは大規模言語モデルの検索拡張なら、まず知識グラフを作り、必要に応じてそのオントロジー層を強化していけばよいでしょう。
オントロジーをどう作り始めるか
よくある進め方は、コンピテンシー質問から始めるものです。まずそのオントロジーが答えるべき問いを列挙します。たとえば「あるプロジェクトにはどの部門の従業員が関わっているか」といった問いで範囲を定めます。次に既存のオントロジーをできるだけ再利用します。Schema.org、FOAF、FIBO などで、車輪の再発明は避けます。続いて用語を整理し、クラス階層を組み立て、プロパティと制約を定義し、インスタンスを登録します。最後に推論機と SHACL で検証し、コンピテンシー質問に戻って反復します。
ツールについては、モデリングにはスタンフォード大学の Protégé、プログラミングには Python の RDFLib や Java の Apache Jena、保存とクエリには GraphDB、Stardog、Amazon Neptune が使えます。今は、大規模言語モデルに用語とクラス階層の草案を作らせ、それを領域の専門家がレビューするという進め方もできます。
初心者がよくやる3つの間違いがあります。
- 部分をサブクラスにしてしまう。 たとえばエンジンを自動車のサブクラスとしてモデリングしてしまいますが、エンジンは自動車の構成部品です。
- クラスとインスタンスを混同する。 研究開発部は部門のインスタンスであり、部門のサブクラスではありません。
- 過剰にモデリングする。 最初から大きく網羅的にしようとしてしまいます。
まとめ
オントロジーとは、共有された概念化の形式的で明示的な仕様であり、クラス、個体、プロパティ、公理から構成され、RDF、RDFS、OWL で表現し、推論機で暗黙の知識を導き出します。知識グラフは大量の事実を担うグラフであり、オントロジーはその意味論的な骨格です。オントロジーを理解すれば、知識グラフや企業のセマンティック層を見たときに、その背後にある共通の論理が見えてくるはずです。