
给 AI Agent 补上业务语义层:本体、OBDA 与 MCP 落地实践
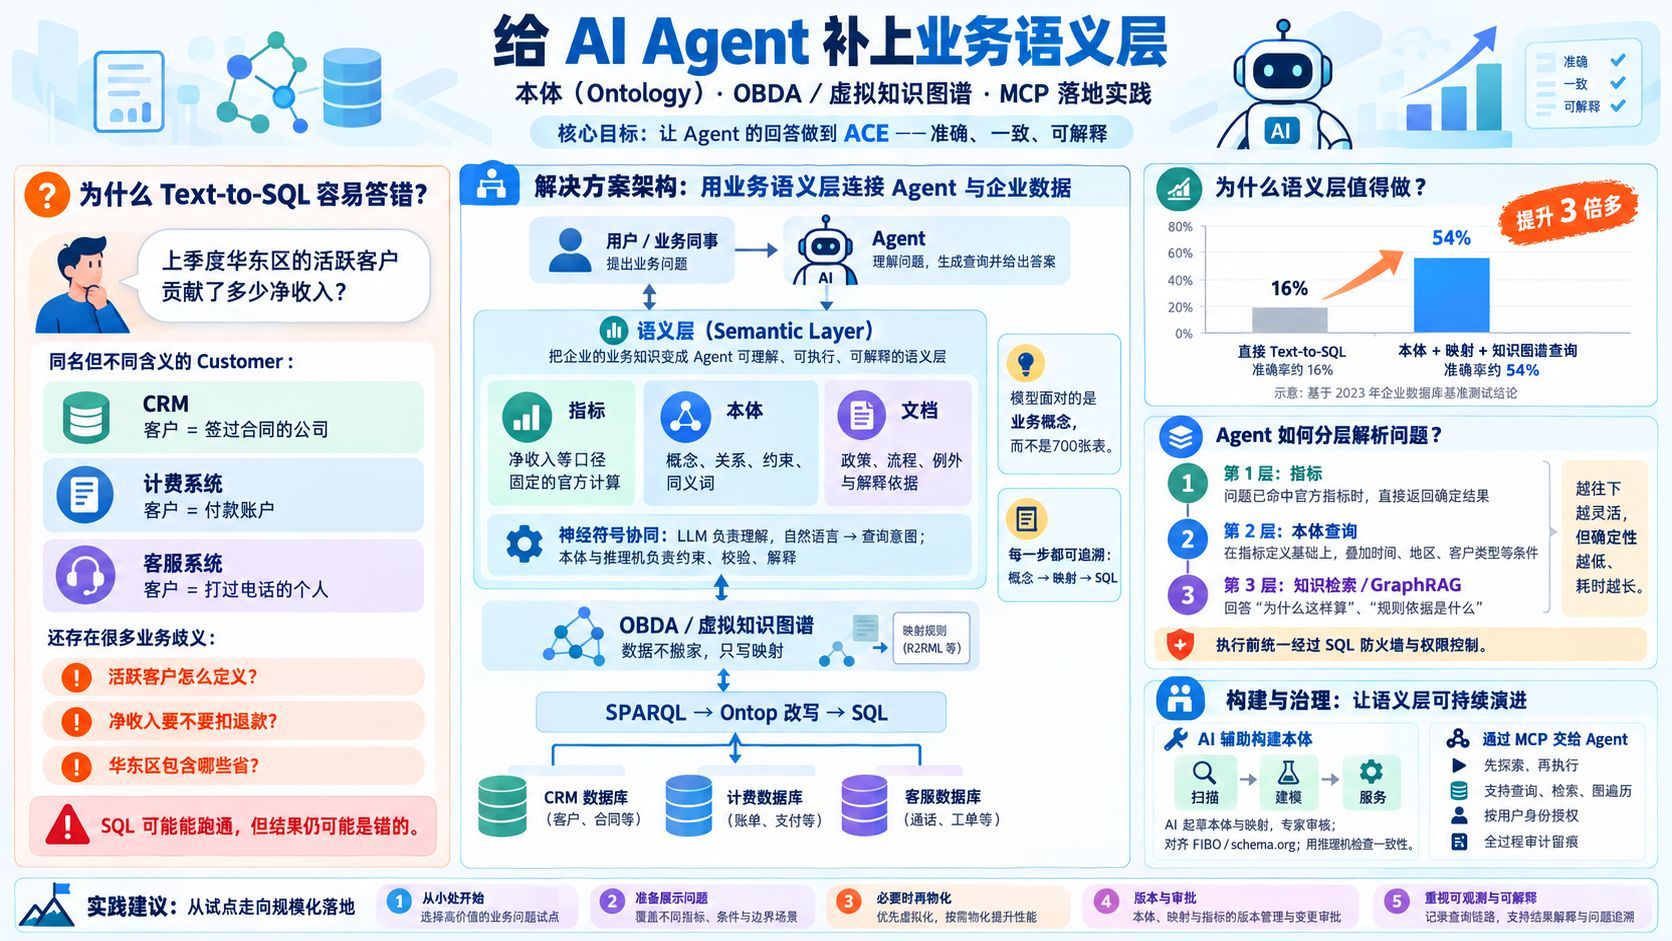
把表结构塞进提示词,并不能让 AI Agent 理解业务含义,它照样会给出看起来很专业、实际却算错的数字。本文以保险业基准测试中 GPT-4 执行准确率从约 16% 提升到约 54% 为例,讲清由指标、本体和文档组成的语义层,如何通过 OBDA(虚拟知识图谱)把本体直接映射到现有数据,并用分层解析兼顾确定性与灵活性。文章还介绍了用 AWS Context Ontology Accelerator 让 AI 起草本体、专家审核,以及 MCP 与身份感知的治理和五条实践建议。

给 AI Agent 补上业务语义层:本体、OBDA 与 MCP 落地实践
数据团队把表结构塞进提示词,让大模型直接写 SQL——这是今天最常见、也最危险的做法。因为业务含义从来不在 schema 里。
一个看起来很专业的错误数字
设想一个数据分析 Agent,同时接入了 CRM、计费系统和客服系统。业务同事问它:
上季度华东区的活跃客户贡献了多少净收入?
Agent 很快给出一个数字,格式专业、口径清晰。但它可能用错了客户表,把退款也算进了收入,"活跃客户"的定义还是自己猜的。更麻烦的是,没人说得清这个数字是怎么算出来的。
问题出在三个系统各有一张叫 Customer 的表,含义却完全不同:
- CRM 里的客户,是签过合同的公司;
- 计费系统里的顾客,是一个付款账户;
- 客服系统里的买家,是打过电话的个人。
同一个词,三种业务实体。模型只看到表名和列名,看不到这层区别。
把表结构塞进提示词,为什么不够
今天常见的做法,是把数据库的表结构放进提示词,让大模型直接读表名、列名和外键。模型确实"看得到"表结构,但看不到那些真正决定答案对不对的知识:
- "活跃客户"是指最近 90 天下过单,还是有一份有效合同?
- 净收入要不要扣除退款?
- 华东区到底包括哪几个省?
这些知识散落在指标文档、Wiki 和数据团队的脑子里,有的根本没写下来。模型只能猜。猜错了,SQL 照样能跑通,结果照样能返回——这类错误最危险,因为它看起来是对的。
那把所有文档都塞进提示词行不行?上下文窗口再大,也装不下几百个系统的说明;而且同一个词的几种定义放在一起,模型反而更容易混淆。
一个三倍多的差距
2023 年,Juan Sequeda 等人在一个保险业的企业数据库上做过一项基准测试。让 GPT-4 直接把问题翻译成 SQL,执行准确率只有约 16%;先用本体和映射把数据表示成知识图谱,再让 GPT-4 生成 SPARQL 来查询,准确率提高到约 54%,是原来的三倍多。
对 Agent 来说,要求还更高:它不只回答问题,还要据此采取行动。我们希望它的决策做到三点——准确、一致、可解释,有人把它概括为 ACE 原则。
解法是在数据和 Agent 之间加一层语义层,把业务含义写成机器能读的形式。Agent 先问语义层,再去碰数据。
"语义层"这个词并不新。BI 工具里早就有语义层,主要管指标口径和维度,让每张报表里的收入都按同一种方法计算。Agent 的语义层在此基础上更进一步:要让模型理解概念、关系和规则,并能据此推理。
一个完整的 Agent 语义层,通常包含三种上下文:指标、本体和文档。三者分工明确:
- 指标:像"净收入"这种每次都必须算得一模一样的计算;
- 本体:描述概念、关系、约束以及字段的业务含义;
- 文档:政策、流程、例外情况这类文字,比如收入确认政策,说明规则背后的原因,让回答可以引用依据。
三者互相补充,而不是互相替代。这背后是一种神经符号的思路:大模型负责理解自然语言、提出候选答案;本体和推理机负责用确定的逻辑去约束、校验和解释。一个灵活,一个可靠。
本体怎样让 Agent 查对数据:OBDA 与虚拟知识图谱
关键技术叫虚拟知识图谱(Virtual Knowledge Graph),也叫基于本体的数据访问(OBDA)。
思路是:数据留在原来的数据库里,不搬家;我们只写一份映射,说明本体里的每个概念和关系对应哪张表、哪些列。查询时,系统把针对本体的查询自动改写成针对数据库的 SQL。
回到客户的例子。本体里定义一个类"签约客户",映射到 CRM 的 Accounts 表;再定义一个类"付款账户",映射到计费系统的 Billing Accounts 表;两者之间用关系"拥有账户"连起来,它对应两张表之间的关联键。这种映射有 W3C 标准,叫 R2RML。
有了它,客户在 CRM 和计费系统里到底指什么,不再藏在某个工程师写的 SQL 里,而是变成一条明确、可以审查的声明。本体里不只有类和关系,还可以给每个概念写上描述、同义词和业务术语——用户说"客户""甲方"还是"签约方",都能对应到同一个概念上。
完整流程是:Agent 拿到自然语言问题,针对本体生成 SPARQL;开源引擎 Ontop 根据映射把 SPARQL 改写成 SQL;SQL 在原数据库上执行。模型只需要面对一套干净的概念,不用直接面对 700 张表。
举个例子,查询华东区的签约客户,用 SPARQL 写只要三行:找出所有签约客户,取出他的所属区域,筛选出华东。改写出来的 SQL 却需要关联三张表,还要把省份翻译成区域编码。
这样做有两个好处:一是模型更容易写对,因为它看到的是"签约客户""拥有账户"这样的业务语言,而不是一堆缩写的列名;二是每一步都能追溯——问题用了哪些概念、概念映射到哪些表、最后执行的是哪条 SQL。
分层解析:先精确,后灵活
有了指标、本体和文档,Agent 收到一个问题该用哪一种?一种实用的设计是分层解析:先用最精确的方法,解决不了再交给下一层。
第一层是指标。如果问题正好就是一个已定义的指标,比如"总的净收入是多少",系统直接执行这个指标预先写好的 SQL,结果是确定的,谁来问得到的都是同一个数字。但我们的问题多了"上季度""华东区""活跃客户"几个限定,指标的 SQL 是固定的,加不进这些条件,只会返回一个没有过滤的总数——所以交给第二层。
第二层是基于本体生成结构化查询。这一层并不会丢掉指标:净收入的官方定义会一起交给模型,模型在这个定义的基础上加上时间、地区和活跃客户的条件,再通过虚拟知识图谱生成 SQL。口径来自指标,概念来自本体。
本体还能在执行前做一次检查。比如本体规定,"拥有账户"这个关系的主体必须是签约客户;如果生成的查询把客服系统里的个人当成签约客户去关联,就违反了这条约束,可以在执行之前拦下来。
第三层是知识检索。如果用户问"为什么退款要从收入里扣除",答案不在任何一张表里,而在收入确认政策这样的文档里。系统在知识图谱和文档中做检索与图遍历,再由大模型综合出答案,并附上出处——这就是上一期提到的 GraphRAG。
三层之间可以逐级回落:越往下越灵活,但确定性越低,耗时也越长。不管走哪一层,生成的 SQL 在执行之前都要经过一道 SQL 防火墙:只允许查询语句,并按用户的权限限制能访问的表和列。
用 AI 构建本体,由专家把关
道理都懂,可本体从哪里来?传统做法要靠知识工程师和业务专家一起,花几个月梳理概念、编写映射,这是很多团队望而却步的原因。
大模型改变了这件事。现在可以让 AI 先读数据目录里的表结构、注释和样例数据,起草本体和映射,再交给专家审核。
AWS 开源的 Context Ontology Accelerator 就是这样一个工具,流程分三步:
- 扫描:连接数据源,发现表结构,补充元数据,也可以导入非结构化文档;
- 建模:归纳出本体,定义指标,构建统一的语义图;
- 服务:通过查询和图遍历,把上下文交给 Agent。
归纳本体时,可以用一种"生成加评审"的方法:按外键依赖的顺序处理表,先检索已有本体中相关的概念,让一个模型生成本体片段,再让另一个模型评审和修正,最后合并进核心本体。
还有一步叫对齐(grounding):把新生成的类对齐到 FIBO、schema.org 这样的已有本体上,避免同一个概念重复出现。这一步不能只看名字——保险业里的 Policy 是保单,而在别的领域本体里,Policy 可能指政策规范,同名不同义,要靠语义判断区分开。
生成的本体还要经过验证:用 HermiT 这样的推理机检查逻辑一致性,再检查质量指标和常见的建模错误,最后由领域专家逐条审查、修改、批准,才能进入生产。
AI 起草、人来把关。专家修改过的描述和同义词会替换掉 AI 生成的版本,旧版本作为历史保留下来。这样模型看到的永远只有一个定义,而不是两个互相打架的说法。
这套加速器部署在你自己的 AWS 账户里:Amazon Neptune 存储语义图,OpenSearch 做向量检索,Amazon Bedrock 提供模型;本体按 W3C 标准格式保存,也可以拿到其他工具里使用。
把语义层交给 Agent:MCP 与身份感知的治理
本体建好了,怎么交给 Agent?现在最通用的方式是 MCP(模型上下文协议)。语义层把自己的能力包装成一组工具,任何支持 MCP 的 Agent 都能发现和调用。
以 Context Ontology Accelerator 为例,它提供 6 个工具:2 个用来探索——列出有哪些指标,描述本体里的类、属性和数据表;4 个用来执行端到端的自然语言查询——翻译成 SPARQL、检索文档片段,以及在语义图上遍历实体关系。
一个好用的模式是"先探索,再执行":Agent 先调用描述本体的工具,弄清楚签约客户和付款账户的区别,再发起查询。就像新员工入职,先读业务词典,再去查数据。
治理同样重要。Agent 是代表某个用户在做事,所以每次调用都按这个用户的身份判断权限,而不是按 Agent 自己的身份;没有授权默认拒绝——用户看不到的表,Agent 也看不到。每一次调用都会留下审计记录:谁发起的、用了哪些概念、执行了哪条 SQL、结果来自哪里。出了问题可以复盘,合规团队也能核查 Agent 到底访问了什么。
这个方向正在变成基础设施:云服务正在把业务描述、数据使用说明和业务注解直接挂到数据目录和存储上,并用开放格式发布,让 Agent 在运行时就能取到受治理的上下文。
五条实践建议
第一,从小处开始。 不要一上来就想建全公司的本体。先挑一个高价值的领域,比如客户和收入,把它做深做准。过度建模是新手最常犯的错误之一。
第二,准备一组展示问题。 从真实业务里挑出几十个有代表性的问题,写好标准答案。它既是验收标准,也是回归测试:每次修改本体、映射或指标,都重新跑一遍,看准确率有没有下降。
第三,只在真正需要时做物化。 当跨域整合确实需要时,再把那一部分物化下来。如果映射写得很绕,可以在源头建一些和本体结构对齐的视图。
第四,从第一天起就做好治理。 本体要有版本和审批流程,草稿和生产分开,随时可以回滚。大模型可以起草本体、生成映射,但每一次变更都要有人审核。
第五,重视可观测和可解释。 记录每次查询走了哪一层、用了哪些概念、耗时多少;回答里附上引用和推理链。用户看得到依据,才会信任 Agent 的结论。同时尽量遵循 RDF、OWL、SPARQL、R2RML、RML 这些开放标准,以免被某个工具锁定。
结语
Agent 会答错,是因为业务含义不在 schema 里。语义层用指标、本体和文档补上了这块。虚拟知识图谱让本体直接映射到现有数据,不必搬迁;分层解析兼顾确定性和灵活性;AI 起草、专家把关,大大缩短了本体的构建周期;MCP 和身份感知的治理,把这一切安全地交给 Agent。
有了本体,Agent 给出的答案不只要算得对,还要讲得清依据。