
AIエージェントに業務セマンティックレイヤーを:オントロジー・OBDA・MCPの実装
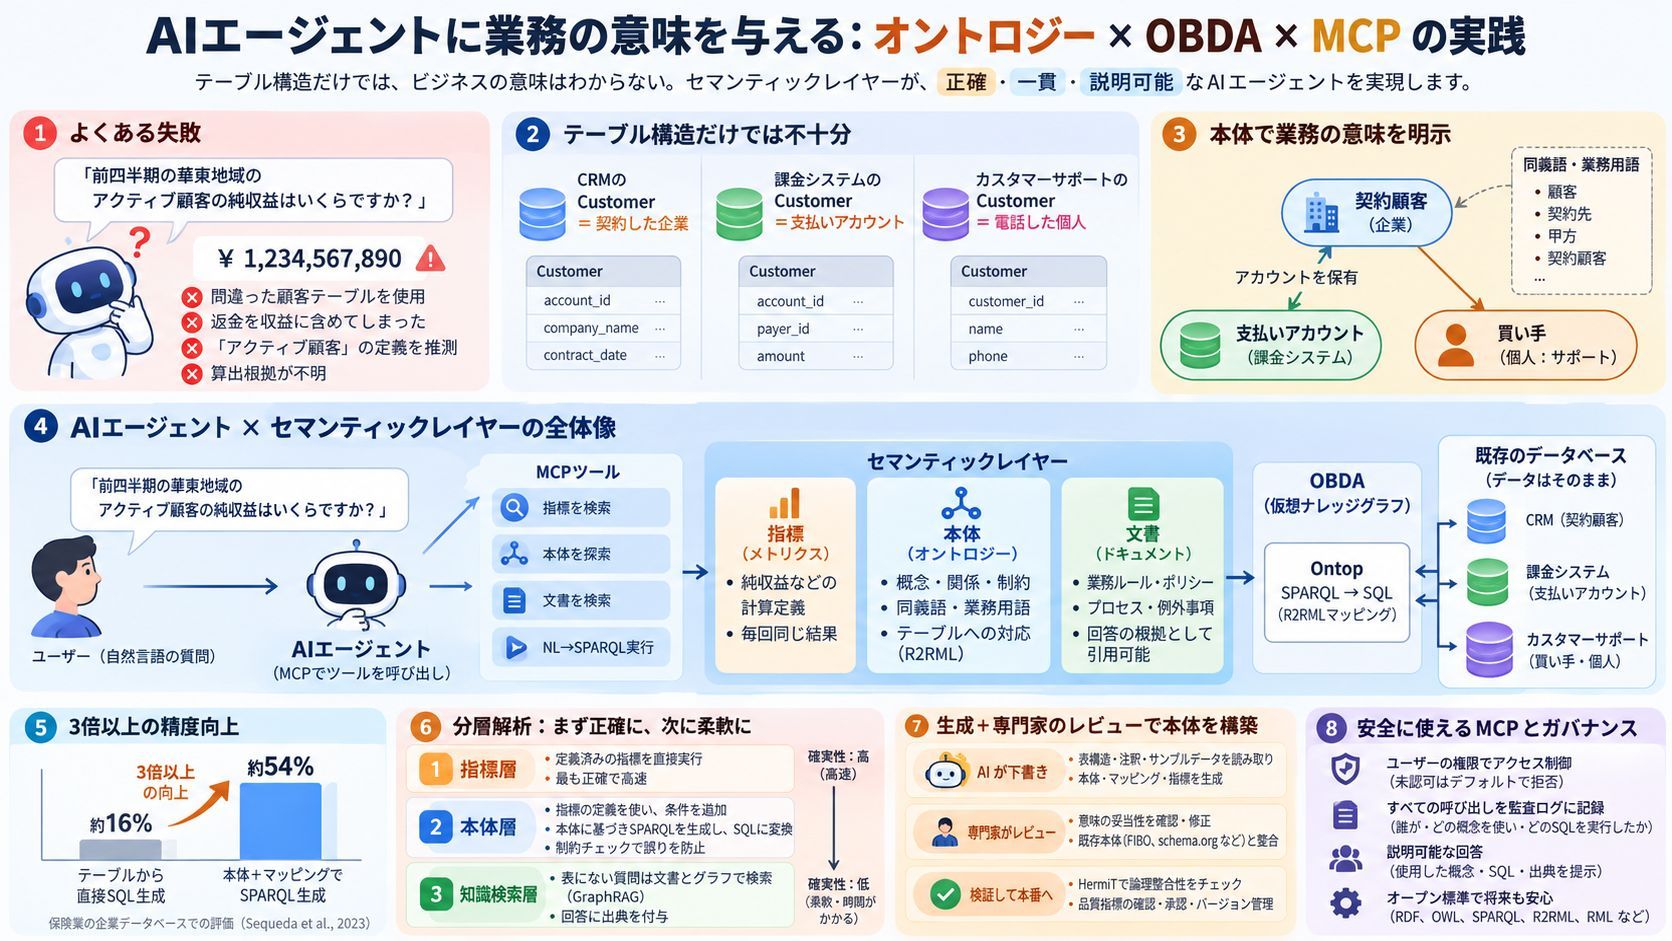
表構造をプロンプトに入れるだけでは、AIエージェントは業務上の意味を理解できず、正しく見えるが間違った数字を返す。本記事は、保険業のベンチマークでGPT-4の実行精度が約16%から約54%へ上がった事例を軸に、指標・オントロジー・ドキュメントからなるセマンティックレイヤー、オントロジーを既存データに対応づけるOBDA、確実性と柔軟性を両立する階層的パースを解説する。AI起草と専門家承認、MCPとガバナンス、実践の5つの提案も扱う。

AIエージェントに業務セマンティックレイヤーを:オントロジー、OBDA、MCPの実装
データチームがテーブル構造をプロンプトに放り込み、大規模言語モデルに直接SQLを書かせる——これは今日もっとも一般的で、もっとも危険なやり方です。なぜなら、業務上の意味はスキーマの中には決して存在しないからです。
いかにもプロらしい、間違った数字
CRM、課金システム、カスタマーサポートシステムに同時に接続されたデータ分析エージェントを想像してみてください。業務の同僚がこう尋ねます。
前四半期、華東地区のアクティブ顧客がもたらした純収益はいくらですか?
エージェントはすぐに数字を返します。書式も整い、定義も明確に見えます。しかし実際には、間違った顧客テーブルを使っていたり、返金を収益に算入していたり、「アクティブ顧客」の定義を自分で勝手に推測していたりするかもしれません。さらに厄介なのは、その数字がどう計算されたのか、誰にも説明できないことです。
問題は、3つのシステムにそれぞれ Customer というテーブルがあり、意味がまったく異なる点にあります。
- CRMの顧客は、契約を交わした会社
- 課金システムの顧客は、1つの支払アカウント
- サポートシステムの買い手は、電話をかけてきた個人
同じ言葉が、3つの異なる業務エンティティを指しています。モデルにはテーブル名と列名しか見えず、この違いは見えません。
テーブル構造をプロンプトに入れても足りない理由
今日よくあるのは、データベースのテーブル構造をプロンプトに入れ、モデルにテーブル名・列名・外部キーを直接読ませる方法です。モデルは確かにテーブル構造を「見て」います。しかし、答えの正しさを本当に左右する知識は見えていません。
- 「アクティブ顧客」とは、直近90日以内に注文した顧客か、それとも有効な契約を持つ顧客か
- 純収益から返金を差し引くのか
- 華東地区には具体的にどの省が含まれるのか
こうした知識は、指標ドキュメントやWiki、データチームの頭の中に散らばっていて、そもそも書き残されていないものもあります。モデルは推測するしかありません。推測を外しても、SQLはそのまま動き、結果もそのまま返ってきます。こうした誤りが最も危険です。正しく見えるからです。
では、すべてのドキュメントをプロンプトに詰め込めばいいのでしょうか。コンテキストウィンドウがどれだけ大きくても、数百システム分の説明は収まりません。しかも、同じ言葉の複数の定義を並べると、モデルはかえって混乱しやすくなります。
3倍以上の差
2023年、Juan Sequeda らは保険業の企業データベースでベンチマークを実施しました。GPT-4に質問を直接SQLへ翻訳させると、実行精度は約16%にとどまりました。一方、オントロジーとマッピングでデータを知識グラフとして表現し、GPT-4にSPARQLを生成させて問い合わせると、精度は約54%まで上がり、3倍以上になりました。
エージェントには、さらに高い水準が求められます。質問に答えるだけでなく、それに基づいて行動するからです。その意思決定には3つの条件を満たしてほしい——正確、一貫、説明可能。これは ACE 原則と呼ばれています。
解決策は、データとエージェントの間にセマンティックレイヤーを1層挟み、業務上の意味を機械が読める形で書くことです。エージェントはまずセマンティックレイヤーに問い合わせ、それからデータに触れます。
「セマンティックレイヤー」という言葉自体は新しくありません。BIツールには以前からセマンティックレイヤーがあり、主に指標の定義とディメンションを管理し、どのレポートでも収益が同じ方法で計算されるようにしてきました。エージェントのセマンティックレイヤーは、その上でさらに一歩進みます。モデルが概念・関係・ルールを理解し、それに基づいて推論できるようにするのです。
完全なエージェントのセマンティックレイヤーは、通常3種類のコンテキストを含みます。指標、オントロジー、ドキュメントです。役割分担は明確です。
- 指標:「純収益」のように、毎回まったく同じ計算結果でなければならないもの
- オントロジー:概念・関係・制約、そしてフィールドの業務的な意味を記述するもの
- ドキュメント:ポリシーやプロセス、例外などの文章。たとえば収益認識ポリシーで、ルールの背景にある理由を説明し、回答が根拠を引用できるようにするもの
3つは互いを補完し合うもので、置き換え合うものではありません。背景にあるのはニューロシンボリックな考え方です。大規模言語モデルが自然言語を理解し、候補となる答えを出し、オントロジーと推論エンジンが確定的な論理でそれを制約・検証・説明する。一方は柔軟に、もう一方は確実に。
オントロジーがエージェントの正しいデータ照会を可能にする仕組み:OBDAと仮想知識グラフ
鍵となる技術は仮想知識グラフ(Virtual Knowledge Graph)、別名 オントロジーベースのデータアクセス(OBDA)です。
考え方はこうです。データは元のデータベースに置いたまま、引っ越しさせません。私たちはマッピングを1つ書くだけで、オントロジー内の各概念と関係がどのテーブル・どの列に対応するかを示します。クエリ時には、オントロジーに対する問い合わせを、データベース向けのSQLへ自動的に書き換えます。
顧客の例に戻りましょう。オントロジーにクラス「契約顧客」を定義し、CRMの Accounts テーブルにマッピングします。次にクラス「支払アカウント」を定義し、課金システムの Billing Accounts テーブルにマッピングします。両者は関係「アカウントを保有する」で結び、これが2つのテーブル間の関連キーに対応します。このマッピングにはW3C標準があり、R2RMLと呼びます。
これにより、CRMと課金システムでいう顧客が何を指すのかは、もはや誰かエンジニアが書いたSQLの中に隠れているのではなく、明確で審査可能な宣言になります。オントロジーにはクラスと関係だけでなく、各概念に説明や同義語、業務用語を書くこともできます。ユーザーが「顧客」「発注元」「契約者」と言っても、同じ概念に対応づけられます。
全体の流れはこうです。エージェントが自然言語の質問を受け取り、オントロジーに対するSPARQLを生成します。オープンソースエンジン Ontop がマッピングに従ってSPARQLをSQLへ書き換えます。SQLは元のデータベースで実行されます。モデルが向き合うのはクリーンな概念一式だけで、700個のテーブルに直接向き合う必要はありません。
たとえば、華東地区の契約顧客を問い合わせる場合、SPARQLなら3行で書けます。すべての契約顧客を取得し、その所属地域を取り出し、華東で絞り込む。しかし書き換えられたSQLは、3つのテーブルを結合し、さらに省を地域コードへ変換する必要があります。
これには2つの利点があります。1つ目は、モデルが正しく書きやすいこと。「契約顧客」「アカウントを保有する」といった業務言語を見ているのであって、略語だらけの列名ではないからです。2つ目は、各ステップを追跡できること。どの概念を使い、その概念がどのテーブルにマッピングされ、最終的にどのSQLが実行されたのかが分かります。
階層的パース:まず正確に、次に柔軟に
指標、オントロジー、ドキュメントがそろったとき、エージェントは質問に対してどれを使うべきでしょうか。実用的な設計の1つが階層的パースです。最も正確な方法をまず使い、解決できなければ次の層に渡します。
第1層は指標です。質問がちょうど定義済みの指標、たとえば「純収益の合計はいくらか」であれば、システムはその指標にあらかじめ用意されたSQLを直接実行します。結果は確定していて、誰が聞いても同じ数字になります。しかし今回の質問には「前四半期」「華東地区」「アクティブ顧客」という限定が付いています。指標のSQLは固定なので、これらの条件を加えられません。フィルタなしの総額しか返しません。そこで第2層に渡します。
第2層は、オントロジーに基づいて構造化クエリを生成します。この層は指標を捨てません。純収益の公式な定義もモデルに一緒に渡し、モデルはその定義を土台に、時間・地域・アクティブ顧客の条件を加え、仮想知識グラフを通じてSQLを生成します。定義は指標から、概念はオントロジーから。
オントロジーは実行前に一度チェックすることもできます。たとえばオントロジーが「アカウントを保有する」という関係の主語は契約顧客でなければならないと定めているとします。生成されたクエリが、サポートシステムの個人を契約顧客として結合しようとすれば、この制約に違反するので、実行前に止められます。
第3層は知識検索です。ユーザーが「なぜ返金を収益から差し引くのか」と尋ねた場合、答えはどのテーブルにもなく、収益認識ポリシーのようなドキュメントの中にあります。システムは知識グラフとドキュメントに対して検索とグラフ走査を行い、大規模言語モデルが根拠を添えて答えをまとめます。これが前回触れた GraphRAG です。
3つの層は順にフォールバックできます。下に行くほど柔軟ですが、確実性は下がり、時間もかかります。どの層を通っても、生成されたSQLは実行前にSQLファイアウォールを通ります。クエリ文だけを許可し、ユーザーの権限に応じてアクセスできるテーブルと列を制限します。
AIでオントロジーを構築し、専門家が承認する
理屈は分かっても、オントロジーはどこから来るのでしょうか。従来のやり方では、ナレッジエンジニアと業務専門家が一緒に、何か月もかけて概念を整理しマッピングを書く必要があり、これが多くのチームが二の足を踏む理由でした。
大規模言語モデルがこれを変えました。今では、AIにデータカタログ内のテーブル構造・コメント・サンプルデータを先に読ませ、オントロジーとマッピングの草案を作らせ、それを専門家が審査する、という流れが取れます。
AWSがオープンソースで公開している Context Ontology Accelerator は、まさにそうしたツールで、流れは3ステップです。
- スキャン:データソースに接続し、テーブル構造を発見し、メタデータを補完する。非構造化ドキュメントの取り込みも可能
- モデリング:オントロジーを導出し、指標を定義し、統一されたセマンティックグラフを構築する
- サービス:クエリとグラフ走査を通じて、コンテキストをエージェントに渡す
オントロジーを導出する際には、「生成+レビュー」という方法が使えます。外部キーの依存順にテーブルを処理し、まず既存オントロジーから関連する概念を検索し、あるモデルにオントロジーの断片を生成させ、別のモデルにレビューと修正をさせ、最後にコアオントロジーへ統合します。
もう1つ「アラインメント(grounding)」というステップがあります。新しく生成したクラスを FIBO や schema.org のような既存オントロジーに対応づけ、同じ概念が重複して現れるのを防ぎます。このステップは名前だけでは判断できません。保険業界の Policy は保険証券ですが、別の領域のオントロジーでは Policy が政策規範を指すことがあり、同名異義なのです。意味に基づいて区別する必要があります。
生成されたオントロジーはさらに検証を受けます。HermiT のような推論エンジンで論理的一貫性を確認し、品質指標とよくあるモデリングミスをチェックし、最後に領域の専門家が1件ずつ審査・修正・承認して、初めて本番に入ります。
AIが起草し、人が承認する。専門家が修正した説明と同義語がAI生成版を置き換え、旧版は履歴として残します。こうしてモデルが見る定義は常に1つだけになり、2つの食い違う説明が並ぶことはありません。
このアクセラレータは自分のAWSアカウント内にデプロイします。Amazon Neptune がセマンティックグラフを保存し、OpenSearch がベクトル検索を担い、Amazon Bedrock がモデルを提供します。オントロジーはW3C標準形式で保存され、他のツールでも利用できます。
セマンティックレイヤーをエージェントに渡す:MCPとアイデンティティを意識したガバナンス
オントロジーができたら、どうやってエージェントに渡すのか。現在もっとも一般的な方法が MCP(Model Context Protocol)です。セマンティックレイヤーは自分の能力を一連のツールとして包み込み、MCP対応のあらゆるエージェントが発見して呼び出せるようにします。
Context Ontology Accelerator を例にすると、6つのツールを提供します。2つは探索用で、どの指標があるかを一覧表示し、オントロジー内のクラス・プロパティ・データテーブルを記述します。4つはエンドツーエンドの自然言語クエリ用で、SPARQLへの翻訳、ドキュメント断片の検索、セマンティックグラフ上でのエンティティ関係の走査を行います。
使いやすいパターンは「まず探索し、それから実行」です。エージェントはまずオントロジーを記述するツールを呼び、契約顧客と支払アカウントの違いを把握してから、クエリを発行します。新しい社員が入社して、まず業務用語辞典を読んでからデータを調べるのと同じです。
ガバナンスも同じくらい重要です。エージェントはあるユーザーを代表して行動しているので、呼び出しのたびにそのユーザーのアイデンティティで権限を判定します。エージェント自身のアイデンティティではありません。権限がなければデフォルトで拒否し、ユーザーが見られないテーブルはエージェントにも見えません。呼び出しのたびに監査記録が残ります。誰が開始し、どの概念を使い、どのSQLを実行し、結果がどこから来たのか。問題が起きれば振り返られますし、コンプライアンスチームもエージェントが何にアクセスしたかを確認できます。
この方向はインフラになりつつあります。クラウドサービスは業務記述、データ利用上の注意、業務アノテーションを、データカタログやストレージに直接ひも付け、オープンな形式で公開しようとしています。エージェントは実行時に、ガバナンスの効いたコンテキストを取得できるようになります。
実践のための5つの提案
第一に、小さく始める。 最初から全社のオントロジーを作ろうとしないこと。まず顧客や収益のような価値の高い領域を1つ選び、深く正確に作り込みます。過剰なモデリングは、初心者が最もよくやる失敗の1つです。
第二に、デモ用の質問セットを用意する。 実際の業務から代表的な質問を数十個選び、模範解答を書いておきます。これは受け入れ基準であると同時に回帰テストです。オントロジー、マッピング、指標を変更するたびに再実行し、精度が落ちていないかを確認します。
第三に、本当に必要なときだけマテリアライズする。 領域をまたぐ統合が本当に必要になったとき、その部分をマテリアライズします。マッピングが複雑になりすぎるなら、ソース側にオントロジー構造と揃えたビューを作ります。
第四に、初日からガバナンスに取り組む。 オントロジーにはバージョンと承認フローを持たせ、ドラフトと本番を分け、いつでもロールバックできるようにします。大規模言語モデルはオントロジーやマッピングの草案を作れますが、変更のたびに人の承認が必要です。
第五に、可観測性と説明可能性を重視する。 各クエリがどの層を通ったか、どの概念を使ったか、どれだけ時間がかかったかを記録します。回答には引用と推論チェーンを添えます。ユーザーが根拠を見られてこそ、エージェントの結論を信頼します。同時に、RDF、OWL、SPARQL、R2RML、RML といったオープン標準にできるだけ従い、特定ツールへのロックインを避けます。
おわりに
エージェントが間違えるのは、業務上の意味がスキーマの中にないからです。セマンティックレイヤーが指標・オントロジー・ドキュメントでその穴を埋めます。仮想知識グラフはオントロジーを既存データへ直接マッピングし、移行を不要にします。階層的パースは確実性と柔軟性を両立します。AIが起草し専門家が承認することで、オントロジー構築の期間は大きく短縮されます。MCPとアイデンティティを意識したガバナンスが、それを安全にエージェントへ渡します。
オントロジーがあれば、エージェントの答えは正しく計算できるだけでなく、根拠を説明できるものになります。