
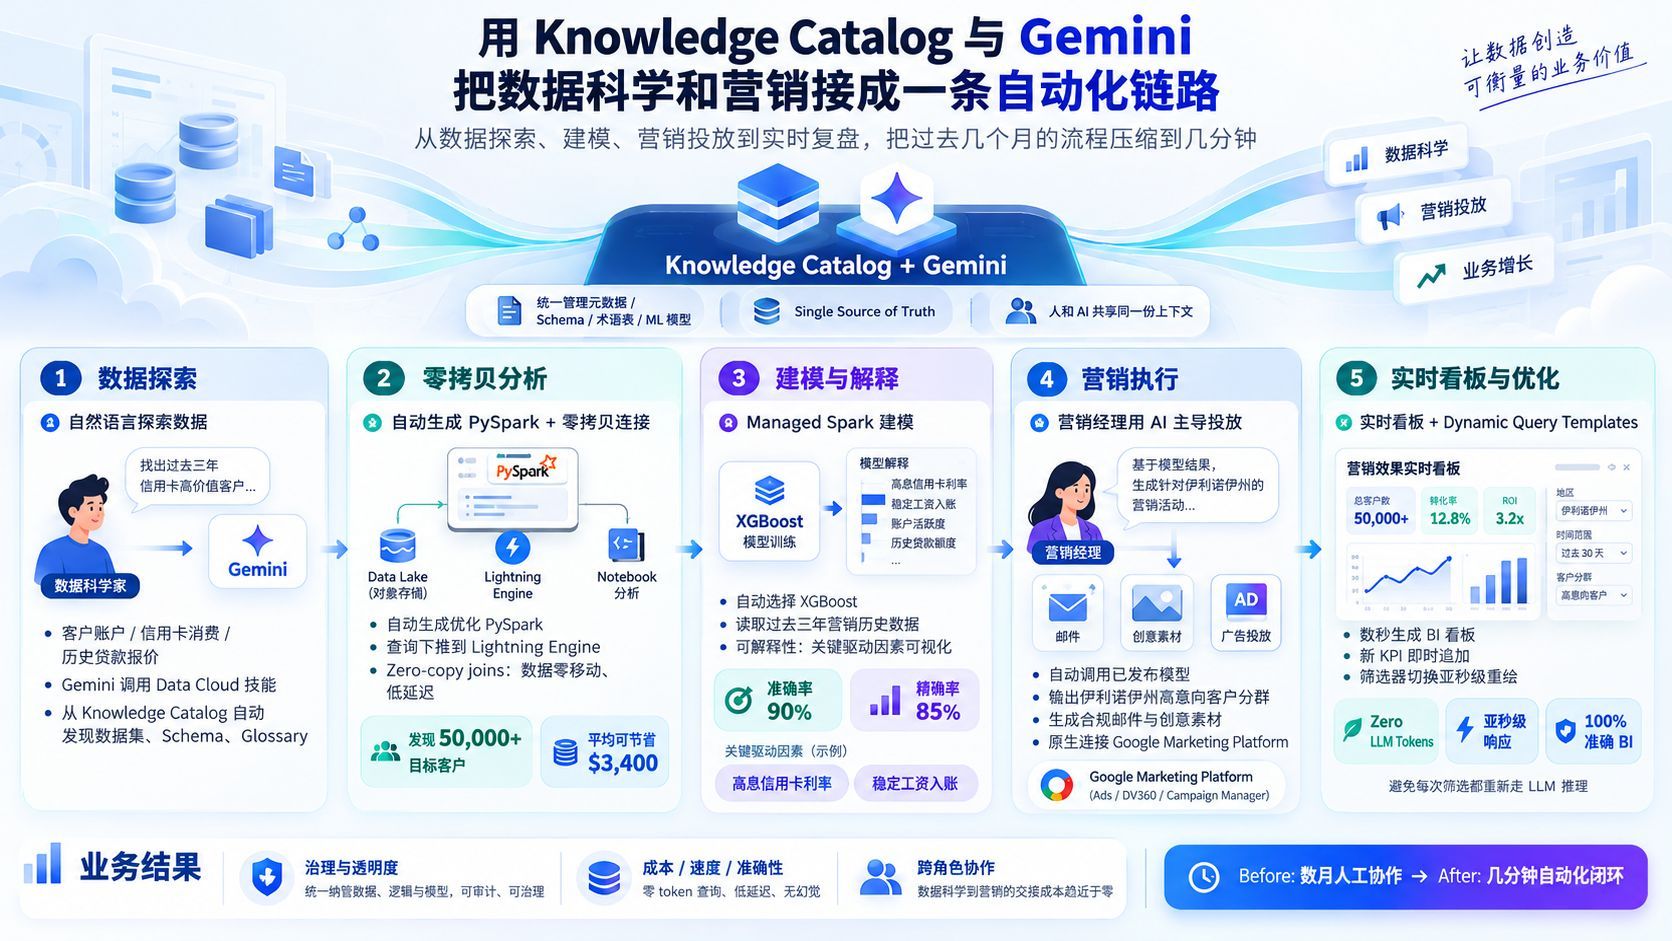
用 Knowledge Catalog 与 Gemini 打通数据科学与营销的自动化工作流
本文以零售银行的贷款置换为例,说明 Knowledge Catalog 与 Gemini 如何打通数据科学与营销:自然语言探索数据、自动生成 PySpark 并经 Lightning Engine 做零拷贝连接,用 XGBoost 建模(准确率90%、精确率85%),一键发布到目录,直至用零 token 的 BI 分析把数月工作压到几分钟。

用 Knowledge Catalog 与 Gemini 把数据科学和营销接成一条自动化链路
在很多企业里,数据科学家和营销人员之间横着一道很深的缝:前者清楚数据在哪、模型怎么建,后者清楚要对谁说什么话,但两者之间靠人工取数、邮件交接和临时脚本来连接。一次从数据探索到投放复盘走完,常常要耗上几个月。
真正的症结不在模型不够强,而在"上下文"被切成了好几段。要修这道缝,需要的不是再加一个工具,而是让大语言模型(LLM)与统一管理的数据目录原生地长在一起,成为整个组织"唯一可信的信息源"(Single Source of Truth)。
Google Cloud 的 Knowledge Catalog 就是这样一个底座。它不只纳管 Google Cloud 上的数据资源,也把散落在多云与本地环境中的异构数据集、元数据、表结构(Schema)和业务术语表(Glossary)集中管理;同时给数据工程师和数据科学家留有可扩展的空间,让他们能够注册、定义并可视化新的数据集与业务逻辑。
更关键的是它的角色变了:过去的数据目录是"给人翻阅的静态字典",而 Knowledge Catalog 是"人和 AI 智能体共享同一份上下文、据此行动的动态执行底座"。人与 LLM 共用同一套数据定义和业务逻辑,才能在守住治理与安全的前提下,把数据使用周期整体提速。
下面用一家零售银行的贷款交叉销售场景,走一遍这条链路。
一、从一句自然语言开始探索数据
要防止客户流失、把客户引导到更赚钱的金融产品上,第一步是能立刻定位并分析三类数据:客户账户、信用卡消费记录、历史贷款报价记录。
数据科学家不需要先写 SQL 或翻数据字典,直接对 Gemini 说:
请告诉我都有哪些关于客户账户、卡片消费数据、历史贷款报价记录的数据,并把我的数据景观可视化出来。
Gemini 会自动调用内置的"Data Cloud 技能",从 Knowledge Catalog 登记的元数据中找出相关数据集,立刻画出数据景观。场景可以很具体:对背着高息信用卡余额的客户,推销本行低息个人贷款做债务置换。这时数据科学家只要说一句"帮我找出那些把高息卡余额换成低息个人贷款后能省钱的客户",就能顺畅进入查询设计。
二、不搬数据也能算:PySpark 自动生成与 Lightning Engine 零拷贝连接
在 PB 级的数据湖仓里,为了分析把数据物理抽出来再传输,会带来巨大的网络成本和时延。现代数据架构要的是把计算推到数据旁边,而不是把数据搬到计算这边。
Gemini 借助 Data Cloud 技能,自动生成将湖仓内客户数据与卡片消费数据做连接、聚合的优化 PySpark 代码,并把这份计算直接下推(Pushdown)到贴近湖仓存储的高性能查询优化引擎 Lightning Engine 上。
这样就去掉了旧架构中"从存储抽取数据(ETL)、再经网络序列化/反序列化"的开销,实现零拷贝连接(Zero-copy joins):不产生数据移动,分析速度极快,数据的本地性与安全性也完整保留。
新一代 Python Notebook 环境还提供两种顺手的能力:
- 逐行实时编辑:Gemini 生成的 PySpark 代码,可以在 Notebook 单元格里逐行实时修改、定制。
- 交互式重算:只改 Notebook 下拉菜单里的参数,下方所有图表和可视化组件就会自动重新计算。
[数据科学家的自然语言指令]
       │
       ▼ (Data Cloud 技能解析 Schema)
[自动生成 PySpark 代码]
       │
       ▼ (查询下推执行)
[Lightning Engine / 湖仓] ─── 零拷贝连接(数据零移动 / 超低延迟)
       │
       ▼ (即时可视化)
[初步分析结果]
  ⇒ 识别出 50,000 名以上目标客户(平均可节省 $3,400)
这一步初步分析很快得出结论:从高息卡换成低息个人贷款、平均能省 $3,400 的目标客户,已经有 50,000 人以上。
有了这份名单,下一步就是构建模型,精确预测谁最可能接受贷款置换报价。
三、用 Gemini 与 Managed Spark 建模型,并解释它为何这样判断
要从目标客户中挑出"真正收到报价后最可能回答同意"的人,需要选算法、做训练。
Gemini 会经由 Knowledge Catalog 读取存放在 BigQuery 中的"过去三年营销活动历史数据"。考虑到梯度提升在结构化表格数据上的显著性能与算法适配度,它自动选定 XGBoost 作为最合适的模型;为了免去分布式基础设施的搭建与管理开销,它自动选择全托管的 Managed Spark 作为运行底座。
由于 Gemini 准确掌握特征工程所需的列(Column)上下文,能直接产出高质量 Python 代码,数据科学家不必再从零手写复杂的流水线。
准确率之外,还要能解释
在企业决策中,与预测精度同样重要的是"模型为什么这样判断",也就是可解释性(Explainability / XAI)。在金融监管与合规的视角下,黑箱模型很难真正投入实务。
用历史测试数据评估,这个模型给出了不错的结果:
- 模型准确率(Accuracy):90%
- 精确率(Precision):85%
Gemini 还会可视化并解释驱动预测的主要特征信号(Propensity drivers):
- 高息信用卡利率(High interest credit card rates)
- 稳定的每月工资入账(Steady monthly payroll deposits)
拿到这些可解释的信号,营销团队就不必再依赖直觉和经验拍脑袋,而是能基于客观数据制定更有说服力的沟通策略。
一键发布到目录,把交接成本降到零
训练与评估完成的 ML 模型,可以从 Notebook 环境一键直接发布到 Knowledge Catalog。
[在 Notebook 中构建并评估 ML 模型](准确率 90%,精确率 85%)
       │
       ▼ (一键发布)
[Knowledge Catalog(治理管理底座)]
       │
       ├─► [营销经理]:通过 GUI / Gemini 界面按需调用
       └─► [其他 AI 智能体]:在自动化流程中作为模型推理 API 调用
把模型登记到目录里,真正的价值在于消除了过去压在数据科学团队身上的瓶颈——"模型上线、封装 API、编写批处理脚本"这些交接工时,让业务用户能通过 Gemini 自助运行预测模型。发布后的预测模型立刻对全组织可用,流程无缝进入下游的营销执行阶段。
四、下游落地:营销经理用 AI 主导投放
因为数据科学家构建的 ML 模型就扎根在 Knowledge Catalog 上,营销一线完全不用麻烦开发团队,就能把高级预测模型用进活动里。
营销经理同样用一句自然语言对 Gemini 说:
请找出伊利诺伊州客户中最可能接受这个贷款报价的人群,并创建一封包含数字营销素材的邮件活动。
Gemini 智能体立刻检索 Knowledge Catalog,自动发现并调用刚发布的 ML 模型执行推理,从伊利诺伊州客户数据中抽出接受概率最高的目标分群。
在同一个集成平台上运行的单个 Gemini 智能体底座,共享同一套工具、技能与记忆(上下文),因此可以把从数据分析、内容生成到活动暂存的多任务连贯处理:
| 执行任务 | 具体内容 | 使用的工具 / 资产 |
|---|---|---|
| 生成合规邮件 | 遵守金融监管与内部规范,生成个性化邮件正文草稿 | Gemini LLM 上下文 / 合规检查规则 |
| 生成创意素材 | 自动生成横幅、图片等数字营销视觉素材 | 生成式 AI 创意技能 |
| 输出目标分群 | 基于模型推理结果,筛出伊利诺伊州高意向客户名单 | 目标分群 CSV 导出 |
| 活动暂存上线 | 把活动配置、创意和投放名单自动应用到 Google Marketing Platform | Google Marketing Platform 原生连接器 |
活动自动暂存完成后,下一步就进入实时追踪并优化效果的监测阶段。
五、实时看板与 Dynamic Query Templates:把成本、速度、准确性一起解决
活动上线后(比如一周后),要准确验证收益影响,必须有实时、可交互的效果衡量环境。
营销经理让 Gemini"按前 5 个县(top 5 counties)展示个人贷款活动的表现",几秒钟内就能生成一个连着实时数据的 BI 看板。想深挖数据故事、再加个新 KPI 也很容易:只要指示"加上从活动到贷款签约的中位转化时长(median time)",看板上就会立刻生成并放置一个新的 KPI 卡片。
[看板生成提示]
       │
       ▼ (数秒内接入实时数据)
[绘制前 5 县表现看板]
       │
       ▼ (追加 KPI:中位转化时长)
[即时新增 KPI 卡片]
       │
       ▼ (用户切换"县"筛选器)
[Dynamic Query Templates 触发] ──► 零 LLM token,亚秒级重绘!
问题在于:把 LLM 集成进企业级 BI 系统后,如果用户每次更改看板筛选器或参数都要调用一次 LLM 推理,不仅 token 成本高昂,还会带来推理延迟和输出波动(幻觉)的风险。
解法是:看板后端内置登记在 Knowledge Catalog 中的 Dynamic Query Templates(上下文模板)。它带来四层技术与经济价值:
- 零 LLM token 成本(Zero LLM Tokens):用户更改"县(counties)"这类参数时,不经过 LLM 推理,而是直接在数据库上执行优化好的模板查询,LLM token 消耗为零。
- 亚秒级响应:跳过 LLM 生成阶段,图形化参数变更的响应速度被压到 1 秒以内,交互分析变得顺畅。
- 彻底排除幻觉风险:LLM 不再重新生成 SQL,错误查询与数字误写的风险从原理上被排除,保证 100% 准确、确实扎根于企业数据的 BI 结果。
- 即时团队共享:更新后的实时分析结果,一个链接就能实时分享给整个组织。
有了这套查询优化与治理机制,成本、速度和准确性才能同时成立,形成可持续的数据使用循环。
六、结论:把几个月的流程压成几分钟
过去,从数据探索、编写 PySpark、构建与评估 ML 模型、交接给营销部门、配置活动,到用看板衡量效果,这一整条企业流程要靠数月的人工与跨部门协调。
把企业数据严格扎根在 Knowledge Catalog 上,再叠加 Gemini 智能体组成集成流程,这些环节可以压缩到"几分钟"内完成。
| 成果支柱 | 过去的难题(Before) | 引入 Knowledge Catalog + Gemini 后(After) | 业务价值(So What?) |
|---|---|---|---|
| ① 治理与透明度兼得 | 数据割裂在孤岛,模型和逻辑成为黑箱 | 元数据、Schema、ML 模型在 Knowledge Catalog 统一管理 | 在可审计、强治理下可信地运行 AI |
| ② 抑制 token 消耗且高精度低延迟 | 每次分析查询都产生 LLM 成本,还有延迟与幻觉风险 | 用 Dynamic Query Templates 以"零 token"即时执行查询 | 运营成本大减,同时实现亚秒响应与 100% 准确的 BI 分析 |
| ③ 跨角色无缝协作 | 数据科学家到营销人员之间的手工交接瓶颈 | 通过同一个 Gemini 智能体、工具与记忆按需调用 | MLOps 交接成本归零,把投放上市速度压到极限 |
把企业数据正确地扎根到高级 AI 智能体上,正是数据环境日益复杂的企业在快速变化的市场中取得竞争优势的根本。