
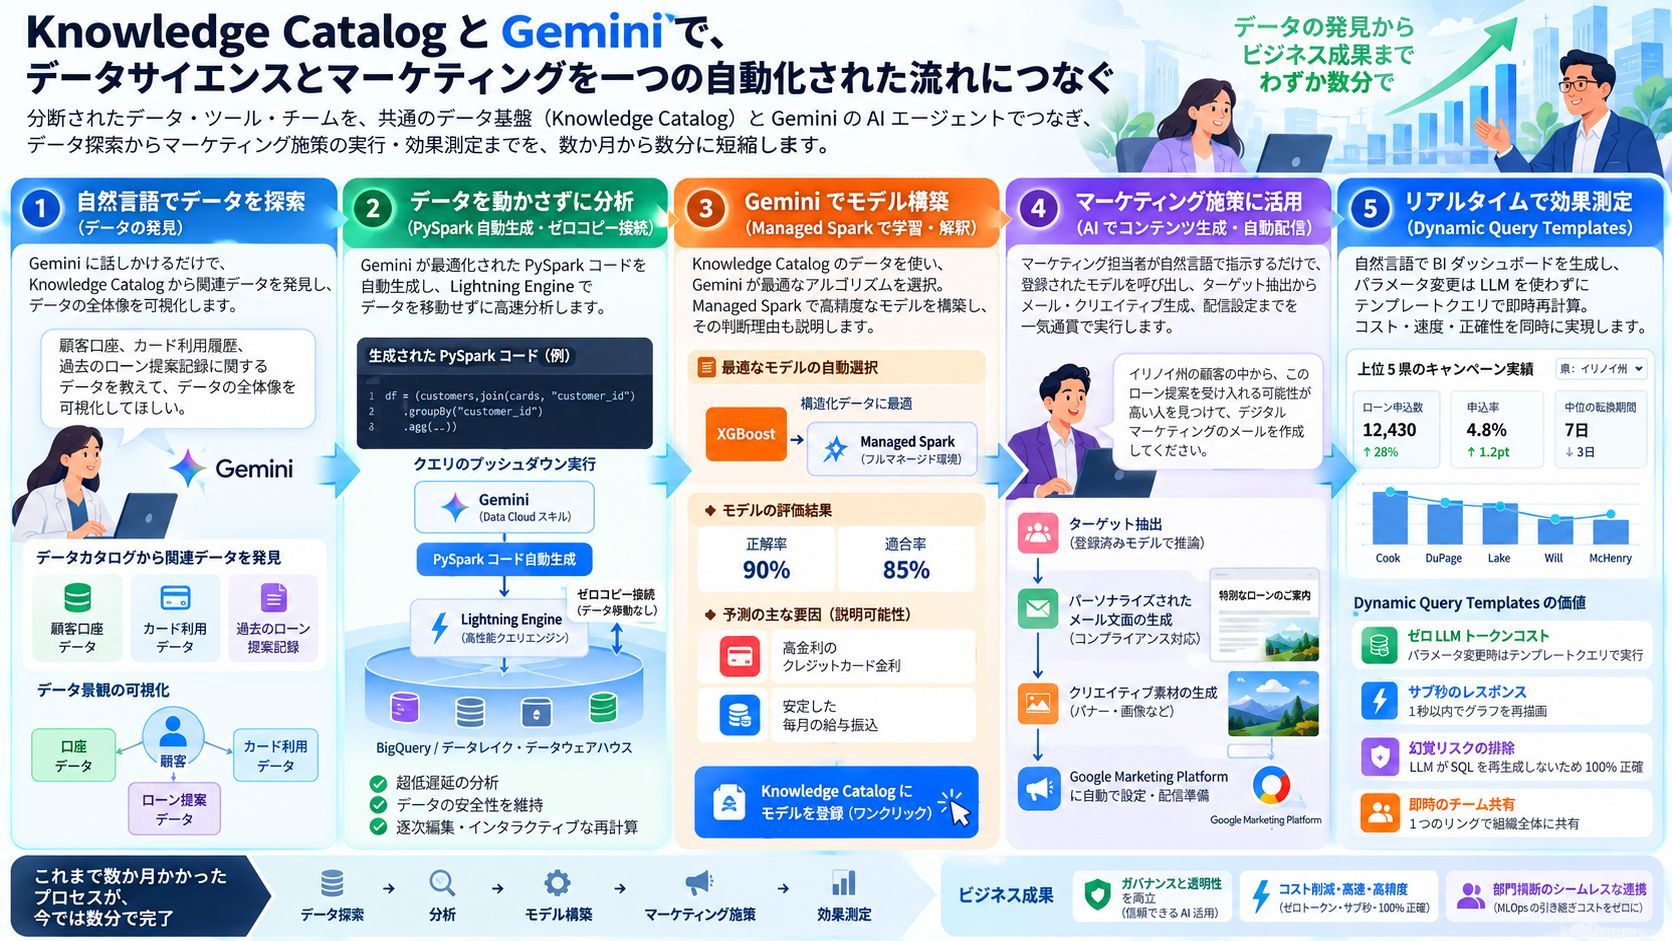
Knowledge Catalog と Gemini でつなぐデータサイエンスとマーケティングの自動化ワークフロー
データサイエンティストとマーケティングの分断を、Knowledge Catalog と Gemini の統合で解消する流れを、リテールバンクのローン借り換えを例に解説。自然言語でのデータ探索、PySpark 自動生成と Lightning Engine のゼロコピー結合、XGBoost によるモデル構築(精度90%・適合率85%)、カタログへワンクリック公開、ゼロトークンの BI 分析まで、数か月の作業を数分に短縮する。

Knowledge Catalog と Gemini で、データサイエンスとマーケティングをつなぐ自動化ワークフロー
多くの企業では、データサイエンティストとマーケティング担当者の間に深い溝があります。前者はデータがどこにあり、モデルをどう作るかを知っており、後者は誰に何を伝えるべきかを知っています。しかし両者は、手作業のデータ抽出、メールでの引き継ぎ、その場しのぎのスクリプトによってつながれています。データ探索からキャンペーンの振り返りまでを一度やり切るには、数か月かかることも珍しくありません。
本当の問題は、モデルが弱いことではなく、「コンテキスト」がいくつにも分断されていることです。この溝を埋めるために必要なのは、ツールをもう一つ増やすことではありません。大規模言語モデル(LLM)と一元管理されたデータカタログをネイティブに結びつけ、組織全体の「単一の信頼できる情報源(Single Source of Truth)」にすることです。
Google Cloud の Knowledge Catalog は、まさにその土台です。Google Cloud 上のデータリソースだけでなく、マルチクラウドやオンプレミスに散在する異種データセット、メタデータ、テーブルスキーマ、ビジネス用語集(Glossary)を集中管理します。さらにデータエンジニアやデータサイエンティストのために拡張の余地を残し、新しいデータセットやビジネスロジックを登録・定義・可視化できるようにします。
さらに重要なのは、その役割が変わったことです。従来のデータカタログは「人間が眺めるための静的な辞書」でしたが、Knowledge Catalog は「人間と AI エージェントが同じコンテキストを共有し、それに基づいて行動するための動的な実行基盤」です。人間と LLM が同じデータ定義とビジネスロジックを共有してこそ、ガバナンスとセキュリティを守ったまま、データ活用のサイクルを全体として加速できます。
以下では、リテールバンクのローンのクロスセルを例に、この流れをたどります。
1. 自然言語のひとことからデータ探索を始める
顧客離れを防ぎ、顧客をより収益性の高い金融商品へ導くには、まず3種類のデータを即座に特定して分析できることが前提になります。顧客口座、クレジットカードの利用履歴、過去のローン提示履歴です。
データサイエンティストは SQL を書いたりデータ辞書をめくったりする必要はありません。Gemini にこう話しかけるだけです。
顧客口座、カード利用データ、過去のローン提示履歴について、どのようなデータがあるか教えてください。私のデータランドスケープを可視化してください。
Gemini は組み込みの「Data Cloud スキル」を自動的に呼び出し、Knowledge Catalog に登録されたメタデータから関連するデータセットを特定して、データランドスケープをすぐに描き出します。シナリオは具体的にできます。高金利のクレジットカード残高を抱える顧客に、自行の低金利パーソナルローンへの借り換えを提案するのです。このときデータサイエンティストは「高金利カードの残高を低金利のパーソナルローンに乗り換えて節約できる顧客を見つけて」と一言伝えるだけで、クエリ設計へスムーズに移れます。
2. データを動かさずに計算する:PySpark の自動生成と Lightning Engine によるゼロコピー結合
ペタバイト級のデータレイクハウスでは、分析のためにデータを物理的に抽出して転送すると、膨大なネットワークコストと遅延が生じます。現代のデータアーキテクチャが求めるのは、データを計算側へ運ぶのではなく、計算をデータの近くへ押し出すことです。
Gemini は Data Cloud スキルを使って、レイクハウス内の顧客データとカード支出データを結合・集計する最適化済みの PySpark コードを自動生成し、その処理を湖倉ストレージに近接する高性能クエリ最適化エンジン Lightning Engine へ直接プッシュダウンします。
これにより、旧来のアーキテクチャにあった「ストレージからのデータ抽出(ETL)と、ネットワークを介したシリアライズ/デシリアライズ」のオーバーヘッドを取り除き、ゼロコピー結合(Zero-copy joins)を実現します。データ移動を発生させず、分析は極めて高速になり、データのローカリティとセキュリティもそのまま保たれます。
次世代の Python Notebook 環境には、次の2つの便利な機能があります。
- 行単位のライブ編集:Gemini が生成した PySpark コードを、Notebook のセル上で1行ずつリアルタイムに編集・カスタマイズできます。
- インタラクティブな再計算:Notebook のドロップダウンメニューのパラメータを変えるだけで、下部にあるすべてのチャートと可視化コンポーネントが自動的に再計算されます。
[データサイエンティストの自然言語指示]
       │
       ▼ (Data Cloud スキルによるスキーマ解析)
[PySpark コードの自動生成]
       │
       ▼ (クエリのプッシュダウン実行)
[Lightning Engine / レイクハウス] ─── ゼロコピー結合(データ移動ゼロ / 超低遅延)
       │
       ▼ (即時の可視化)
[初期分析結果]
  ⇒ 50,000人以上の対象顧客を特定(平均 $3,400 の節約可能性)
この初期分析はすぐに結論を出します。高金利カードから低金利パーソナルローンへ乗り換えることで平均 $3,400 を節約できる対象顧客が、すでに 50,000人以上 存在することが分かったのです。
このリストができたら、次はどの顧客がローン借り換えのオファーを受け入れやすいかを精度高く予測するモデルを構築します。
3. Gemini と Managed Spark でモデルを構築し、判断理由を説明する
対象顧客の中から「実際にオファーを提示したときに最も同意しそうな顧客」を選び出すには、アルゴリズムの選定とトレーニングが必要です。
Gemini は Knowledge Catalog を経由して、BigQuery に格納された「過去3年間のキャンペーン履歴データ」を読み取ります。構造化テーブルデータに対する勾配ブースティングの顕著な性能とアルゴリズム適合性を考慮し、最適なモデルとして XGBoost を自動選定します。さらに分散処理基盤の構築・管理のオーバーヘッドをなくすため、フルマネージドの Managed Spark を実行基盤として自動選択します。
Gemini は特徴量エンジニアリングに必要なカラムのコンテキストを正確に把握しているため、高品質な Python コードを直接生成でき、データサイエンティストは複雑なパイプラインをゼロから書く必要がありません。
精度だけでなく、説明できること
企業の意思決定では、予測精度と同じくらい「モデルがなぜそう判断したのか」、つまり説明可能性(Explainability / XAI)が重要です。金融規制やコンプライアンスの観点では、ブラックボックスのモデルを実務に投入するのは困難だからです。
過去のテストデータで評価したところ、このモデルは良好な結果を示しました。
- モデル精度(Accuracy):90%
- 適合率(Precision):85%
Gemini はさらに、予測を駆動している主要な特徴量シグナル(Propensity drivers)を可視化・解説します。
- 高金利のクレジットカード利率(High interest credit card rates)
- 安定した毎月の給与振込(Steady monthly payroll deposits)
こうした説明可能なシグナルが得られれば、マーケティングチームは勘や経験に頼るのではなく、客観的なデータに裏打ちされた説得力のあるコミュニケーション戦略を立てられます。
ワンクリックでカタログへ公開し、引き継ぎコストをゼロにする
トレーニングと評価を終えた ML モデルは、Notebook 環境からワンクリックで Knowledge Catalog へ直接公開できます。
[Notebook で ML モデルを構築・評価](精度 90%、適合率 85%)
       │
       ▼ (ワンクリック公開)
[Knowledge Catalog(ガバナンス管理基盤)]
       │
       ├─► [マーケティングマネージャー]:GUI / Gemini インターフェースからオンデマンドに呼び出し
       └─► [他の AI エージェント]:自動化フローの中でモデル推論 API として呼び出し
モデルをカタログに登録する真の価値は、これまでデータサイエンスチームにのしかかっていた「モデルの運用化、API のラッピング、バッチ処理スクリプトの作成」という引き継ぎ工数をなくし、ビジネスユーザーが Gemini を通じてセルフサービスで予測モデルを実行できるようにする点にあります。公開された予測モデルはすぐに組織全体で使える状態になり、フローはそのまま下流のマーケティング実行フェーズへとつながります。
4. 下流への展開:マーケティングマネージャーが AI 主導でキャンペーンを実行する
データサイエンティストが作った ML モデルは Knowledge Catalog に根ざしているため、マーケティングの現場は開発チームに一切負担をかけずに、高度な予測モデルを施策へ反映できます。
マーケティングマネージャーも、同じように自然言語で Gemini に指示します。
イリノイ州の顧客の中で、このローンオファーに応じる可能性が最も高い層を特定し、デジタルマーケティング素材を含むメールキャンペーンを作成してください。
Gemini エージェントはすぐに Knowledge Catalog を検索し、先ほど公開された ML モデルを自動的に見つけて推論を実行します。こうしてイリノイ州の顧客データから、受諾確率が最も高いターゲットセグメントが抽出されます。
同じ統合プラットフォーム上で動く単一の Gemini エージェント基盤は、同じツール、スキル、メモリ(コンテキスト)を共有しているため、データ分析からコンテンツ生成、キャンペーンのステージングまでを一貫して処理できます。
| 実行タスク | 具体的な内容 | 使用するツール / アセット |
|---|---|---|
| コンプライアンス準拠メールの作成 | 金融規制と社内ルールを守り、パーソナライズしたメール本文のドラフトを生成 | Gemini LLM コンテキスト / 規制チェックルール |
| クリエイティブ素材の生成 | バナーや画像など、デジタルマーケティング用のビジュアル素材を自動生成 | 生成 AI クリエイティブスキル |
| ターゲットセグメントの出力 | モデル推論の結果から、イリノイ州の見込み顧客リストを絞り込み | ターゲットセグメント CSV エクスポート |
| キャンペーンのステージング | キャンペーン設定、クリエイティブ、配信リストを Google Marketing Platform へ自動適用 | Google Marketing Platform ネイティブコネクタ |
キャンペーンのステージングが自動で終わると、次は成果をリアルタイムに追跡・最適化するモニタリング段階に入ります。
5. リアルタイムダッシュボードと Dynamic Query Templates:コスト・速度・正確性を同時に解決する
キャンペーン開始後(たとえば1週間後)に収益インパクトを正確に検証するには、リアルタイムで操作できる効果測定環境が欠かせません。
マーケティングマネージャーが Gemini に「パーソナルローンキャンペーンのパフォーマンスを上位5つの郡(top 5 counties)別に見せて」と依頼すると、数秒でライブデータにつながった BI ダッシュボードが生成されます。データストーリーを深掘りして新しい KPI を足すのも簡単です。「キャンペーンからローン契約までのコンバージョン所要時間の中央値(median time)を加えて」と指示するだけで、ダッシュボード上に新しい KPI タイルがすぐ生成・配置されます。
[ダッシュボード生成のプロンプト]
       │
       ▼ (数秒でライブデータに接続)
[上位5郡別パフォーマンスダッシュボードを描画]
       │
       ▼ (KPI 追加:コンバージョン所要時間の中央値)
[KPI タイルを即時追加]
       │
       ▼ (ユーザーが「郡」フィルターを切り替え)
[Dynamic Query Templates が発動] ──► ゼロ LLM トークンでサブセカンド再描画!
問題は、LLM を組み込んだエンタープライズ BI を運用するとき、ユーザーがダッシュボードのフィルターやパラメータを変えるたびに LLM 推論を呼び出すと、トークンコストがかさむだけでなく、推論による遅延や出力のばらつき(ハルシネーション)のリスクが生じることです。
そこで、ダッシュボードのバックエンドには Knowledge Catalog に登録された Dynamic Query Templates(コンテキストテンプレート) を組み込みます。これには技術的・経済的に4つの価値があります。
- LLM トークンコストゼロ(Zero LLM Tokens):ユーザーが「郡(counties)」などのパラメータを変えても、LLM 推論を経由せず、最適化済みのテンプレートクエリがデータベース上で直接実行されるため、LLM トークンの消費はゼロになります。
- サブセカンド応答:LLM の生成フェーズを飛ばすことで、グラフィカルなパラメータ変更への応答が1秒未満に抑えられ、インタラクティブな分析が快適になります。
- ハルシネーションリスクの排除:LLM が SQL を再生成しないため、誤ったクエリや数値の誤記のリスクが原理的に排除され、企業データに確実に根ざした 100% 正確な BI 結果が保証されます。
- チームへの即時共有:更新されたライブ分析結果は、リンク1つで組織全体へリアルタイムに共有できます。
このクエリ最適化とガバナンスの仕組みによって、コスト・速度・正確性が同時に成り立ち、持続可能なデータ活用サイクルが完成します。
6. 結論:数か月のプロセスを数分に縮める
これまで、データ探索、PySpark の記述、ML モデルの構築と評価、マーケティング部門への引き継ぎ、キャンペーン設定、ダッシュボードによる効果測定という一連の企業プロセスには、数か月に及ぶ手作業と部門間の調整が必要でした。
企業データを Knowledge Catalog に厳格に根ざし、そこに Gemini エージェントを重ねた統合フローを組むことで、これらの工程は「わずか数分」に短縮されます。
| 成果の柱 | 従来の課題(Before) | Knowledge Catalog + Gemini 導入後(After) | ビジネス価値(So What?) |
|---|---|---|---|
| ① ガバナンスと透明性の両立 | データがサイロ化し、モデルとロジックがブラックボックスに | メタデータ、スキーマ、ML モデルを Knowledge Catalog で一元管理 | 監査可能性と強いガバナンスのもとで AI を信頼して運用 |
| ② トークン消費の抑制と高精度・低遅延 | 分析クエリのたびに LLM コストが発生し、遅延とハルシネーションのリスクも | Dynamic Query Templates で「ゼロトークン」の即時クエリ実行 | 運用コストを大きく下げつつ、サブセカンド応答と 100% 正確な BI 分析を実現 |
| ③ ロール間のシームレスな連携 | データサイエンティストからマーケターへの手作業の引き継ぎがボトルネック | 同じ Gemini エージェント、ツール、メモリを通じたオンデマンド呼び出し | MLOps の引き継ぎコストをゼロにし、施策の市場投入を極限まで速く |
企業データを高度な AI エージェントに正しく根ざさせることこそ、データ環境が複雑化する現代の企業が、変化の激しい市場で競争優位を築くための根本なのです。