
从故事到视频:我在黑客松上验证的三层 AI 视频生成方案
这次黑客松我开发了一套从故事或博客生成视频的工具,并完成了三层验证。第一层把故事自动拆成多节,生成提示词、角色与配音,再逐节生成视频;第二层把 AI& CLI 包装成服务层,用 skills 驱动 AI LLM API,让非程序员也能使用;第三层先写好配音,再以配音为参考让 MiniMax 生成画面,形成声音驱动的视频生成方法。三个验证都成功了。

Github: https://github.com/perfact-tang/AIDirector_AI-81builders
从一条故事到一支视频:我在黑客松上验证的三层做法
这次黑客松,我做了一套生成视频的工具。做完之后我发现,比“做出了一个工具”更让我开心的,是它替我验证了三件事:视频能不能被连续地生产出来,AI 服务能不能被包装成普通人也能用的产品,以及声音能不能成为视频生成的起点。三层都跑通了。
第一层:把“一次性生成”变成可连续的流水线
现在 AI 生成视频的主流做法,是用首帧、尾帧加提示词。单看一个片段,这样已经够用;但真正做一个视频时,问题会立刻暴露:这一条做完,下一条很难接上。越往后做,衔接越痛苦,工作量也越来越大。
我的做法是换一个起点:用户只需要传入一个故事或一篇博客,工具自动判断这个故事需要分成多少节,再为每一节生成对应的提示词。除此之外,工具还会生成角色、配音,并逐节生成视频。项目已经完成。
这一步的价值不在于“能生成视频”,而在于把“每次从零开始”改成了“先拆解,再逐节生产”。故事是同一个故事,角色和声音可以延续,每一节只需要解决自己那一段的画面。对我来说,这是视频能不能持续做下去的关键。
第二层:把 CLI 包成服务层,让非程序员也能用上 AI
这一层来自我作为软件工程师的惯性思考。首先要感谢 AI& 提供的额度(credit)赞助,让我这次能放心地把这些 AI 服务真正跑起来。
我参加过很多次黑客松,尤其是近一年的“氛围编程”(vibe coding)黑客松。大家主要用 AI 工具做产品,产品也基本都是面向程序员的:调用各家 AI 的 API,再把能力包装成面向程序员的 AI 服务。这样的产品成立,但用户边界也很清楚——只有会写代码、会调接口的人才能用。
我一直在想,如果让 AI& 把这些 AI 服务最大限度地跑起来,它们能不能不只供给程序员,也让普通人用上?
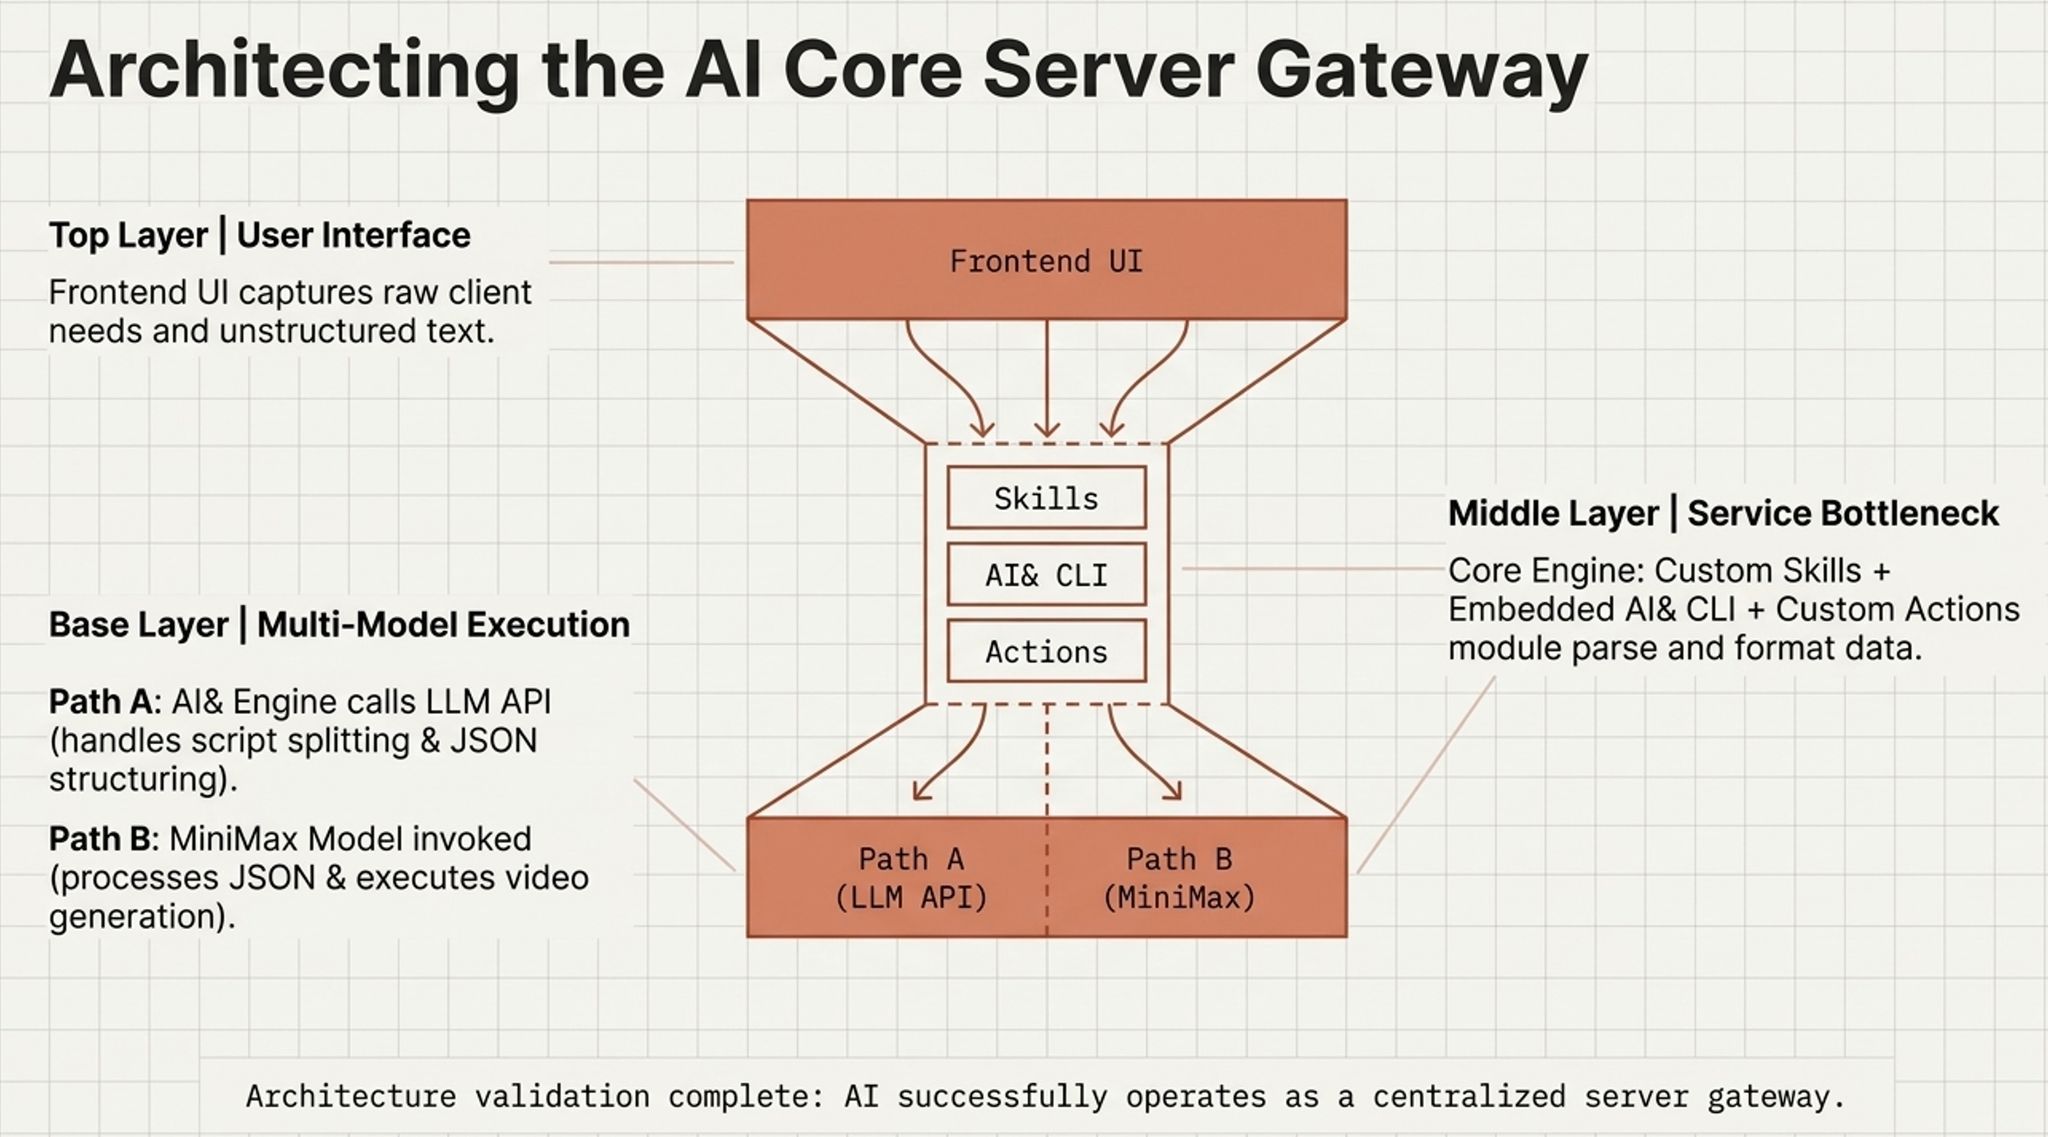
这次听 AI& 介绍产品,他们现在提供的是 AI& CLI 服务。CLI 是开发者熟悉的入口,但它也可以成为底座:把 CLI 包装成一个服务层,再给服务层配一个前台,非程序员就能使用这些能力;如果再在 Server 里叠加我们自己的功能,它就不再只是一个命令行工具,而是一个智能服务。
基于这个想法,我做了两件事:
- 把我写的 skills 安装到这个服务层里。
- 让服务层接上 AI& CLI 工具:前端把客户需求传进来,服务层用我的 skills 加上 AI& 引擎,调用 AI LLM API 来执行、驱动这些 skills,拆分脚本并逐个生成,最后返回一个标准 JSON。
这个想法成功了。前端不需要理解 skill 的内部结构,服务层也不需要为每个需求重写一套流程,双方通过一个标准 JSON 对接。
沿着同样的思路,我又发现 AI& 上线了一个新功能:调用 MiniMax 的视频模型。读文档时我看到,这个视频模型还支持用声音引导生成视频。于是我在服务层里做了一个我称为 Action 的功能:前端发送信息后,服务层在后台调用 AI& CLI,再调用 MiniMax 的模型生成视频。这个也做成了。
让我很惊讶的是价格:生成视频每秒只收 10 日元。我生成了一条大约一分钟的视频,总共花了五六百日元。这个成本低得超出预期,也确实慷慨。
回头来看,AI& 很好地完成了任务,我把它变成了一个服务端指令。更重要的是,这套架构可以广泛复用:做好前端,把 AI 作为服务器的核心入口层,再为它配置 Action 和 Skills 来提供服务。这样既能让 AI& 的能力有更多用途,也能让开发者把更好、更智能的服务交给普通用户。
第三层:声音先行,让配音决定画面
第三层是我在这次实践中发现、也愿意继续倡导的一种新做法:用声音驱动视频生成。
问题很具体:逐段生成的视频,常常缺乏衔接感。我的解法不是继续堆提示词,而是先把配音写好。判断标准也很直接——不看画面,只听配音,能不能感受到故事?如果能,这件事就成了一半。
接下来,把配音文件按段落切好,以每段配音为参考,用 MiniMax 模型生成对应视频。模型会参照配音里的语义去想象动作、生成内容。相比写大量描述画面的 Prompt,这种方式更实际:声音本身带着情绪、节奏和意图,生成的视频有一条核心意图和宗旨去推进,效果也非常好。
三个验证,都成功了
这次黑客松,我完成了三个验证,而且都成功了:一套能连续生产的视频系统,一套把 AI 能力交给普通用户的服务层架构,一种声音先行的视频生成方法。对我来说,这比单纯做出一个 demo 更有价值。
最后感谢组织者 +81 Builders,带来了优秀的 Sponsor、很好的场地和非常好吃的披萨。希望活动越办越好。