
物語から動画へ:ハッカソンで検証した3層のAI動画生成アプローチ
ハッカソンで物語やブログから動画を生成するツールを開発。第1層は、物語を自動で節に分け、プロンプト・キャラクター・ボイスオーバーを生成して節ごとに映像化する仕組み。第2層は、AI& CLIをサービス層で包み、skillsとAI LLM APIで非エンジニアでも使える形にした。第3層は、先に書いたボイスオーバーを参照してMiniMaxで映像を生成する音声駆動の手法。3つの検証はすべて成功した。

Github: https://github.com/perfact-tang/AIDirector_AI-81builders
1つの物語から1本の動画へ:ハッカソンで検証した3層のアプローチ
今回のハッカソンで、私は動画生成ツールを作りました。作り終えてみて、「ツールができた」こと以上に嬉しかったのは、3つのことを検証できたからです。動画を途切れなく制作できるのか。AIサービスを、エンジニア以外の人でも使えるプロダクトとして包めるのか。そして、音声を動画生成の出発点にできるのか。3層とも、実際に動くところまで確認できました。
第1層:「一度きりの生成」を、連続制作できるパイプラインに変える
現在のAI動画生成の主流は、最初のフレームと最後のフレーム、そしてプロンプトを与える方法です。1つのカットを見るだけなら十分ですが、実際に1本の動画を作ると問題がすぐに表れます。このカットを作り終えても、次のカットをうまくつなげられないのです。後ろに進むほどつなぎ合わせが苦しくなり、作業量もどんどん増えていきます。
私のやり方は、出発点を変えることでした。ユーザーが物語やブログを1つ渡すだけで、ツールがその物語を何節に分けるべきかを自動で判断し、各節に必要なプロンプトを生成します。さらに、キャラクターとボイスオーバー(配音)も生成し、節ごとに動画を作っていきます。プロジェクトはすでに完成しています。
このステップの価値は「動画が生成できる」ことではなく、「毎回ゼロから始める」を「まず分解し、節ごとに制作する」に変えた点にあります。物語は同じ物語であり、キャラクターと声も継続できます。各節は、自分の担当するカットの映像だけを考えればよい。私にとって、これは動画制作を続けられるかどうかを決める重要な点でした。
第2層:CLIをサービス層で包み、非エンジニアでもAIを使えるようにする
この層は、ソフトウェアエンジニアとしての私の習慣的な考え方から来ています。まず、AI& から大きなクレジットの提供を受けたことに感謝します。今回、これらのAIサービスを安心して本格的に動かすことができました。
私はこれまで多くのハッカソンに参加してきました。特に直近1年は「バイブコーディング(vibe coding)」のハッカソンが中心です。参加者は主にAIツールでプロダクトを作り、そのプロダクトも基本的にはエンジニア向けでした。各社のAI APIを呼び出し、その能力をエンジニア向けのAIサービスとして包む。そうしたプロダクトは成立しますが、使える人の範囲もはっきりしています。コードを書き、APIを呼べる人だけが使えるのです。
ずっと考えていたのは、AI& にこれらのAIサービスを最大限に動かしてもらうとして、それをエンジニアだけに提供するのではなく、一般の人たちにも使ってもらえないか、ということでした。
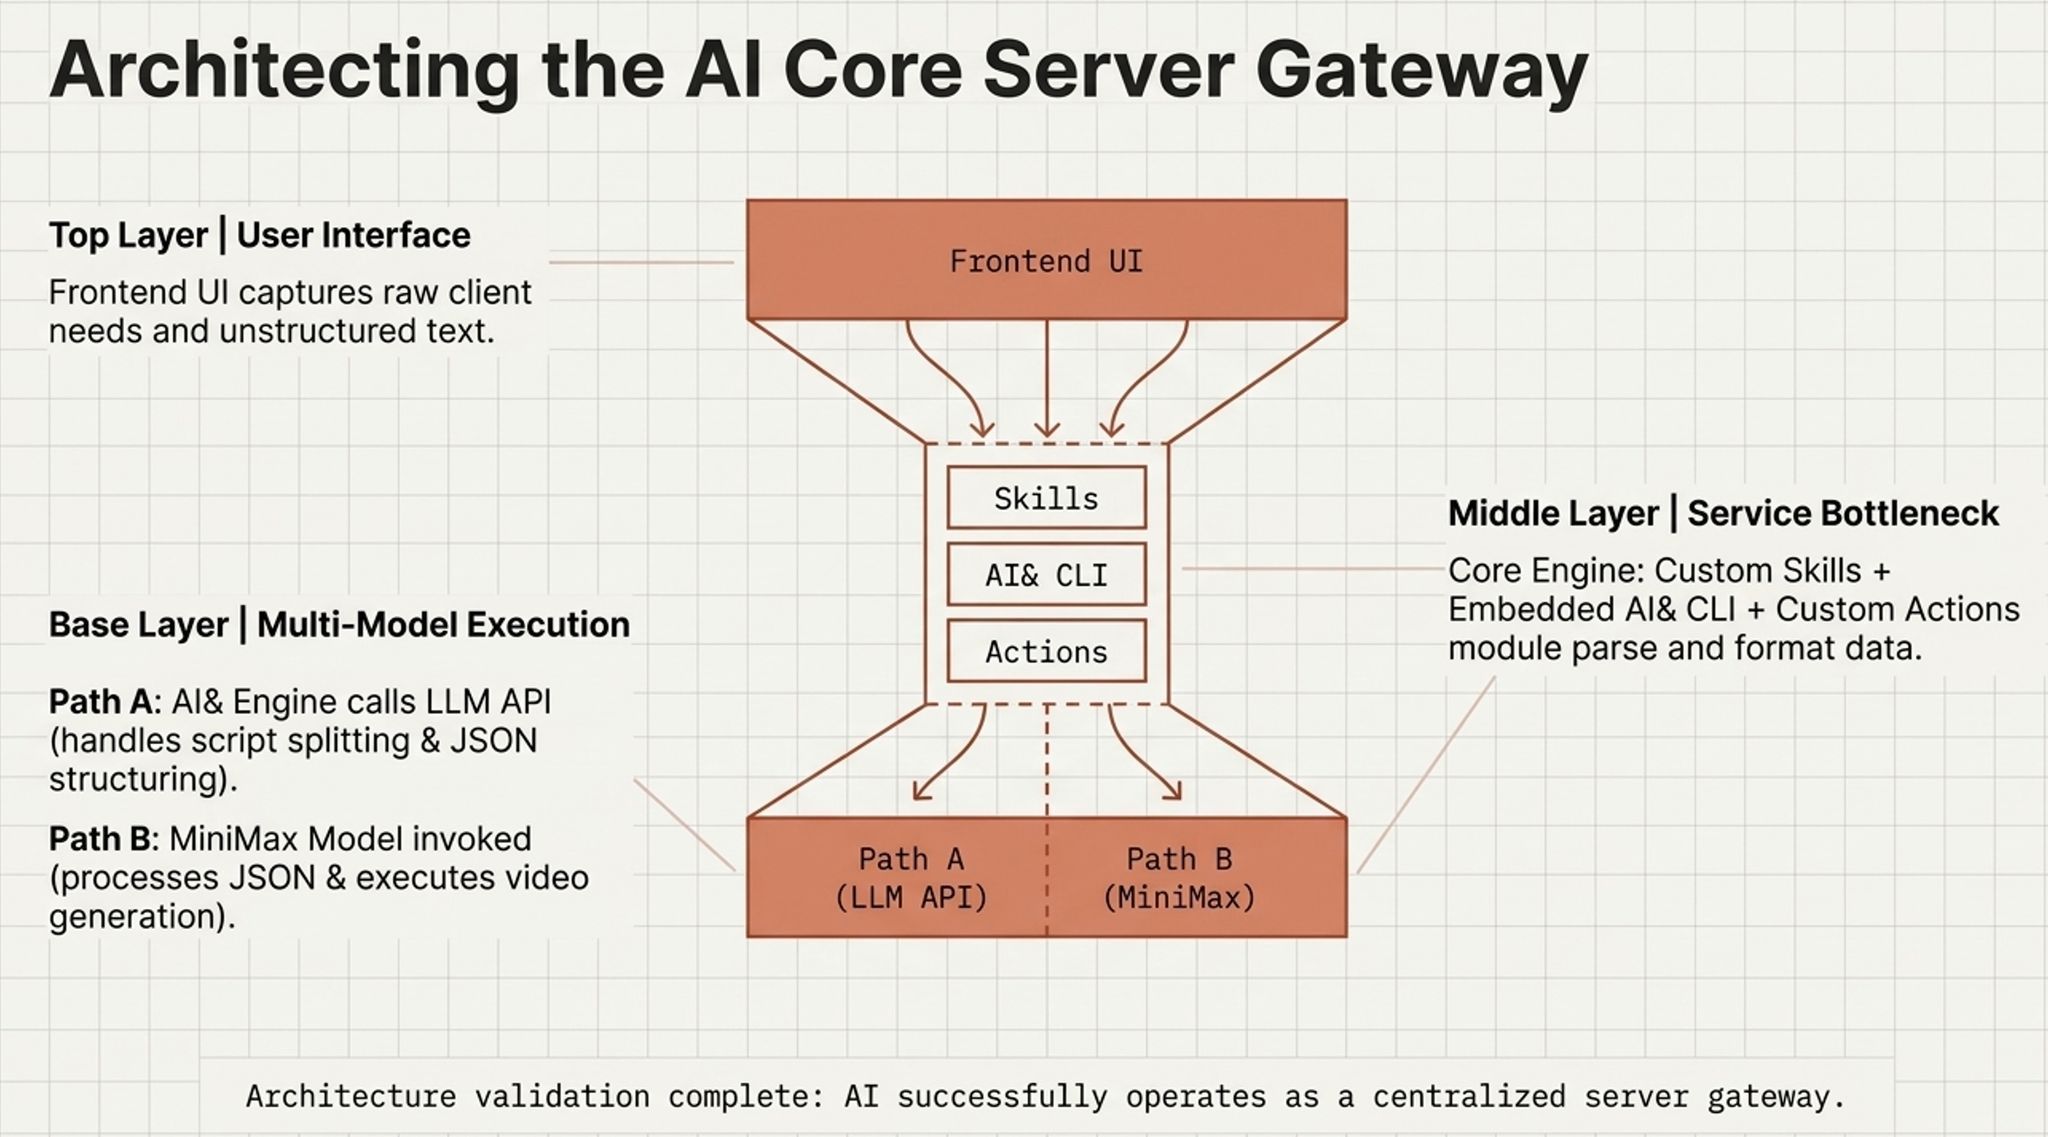
今回AI& のプロダクト説明を聞いて、現在は AI& CLI サービスを提供していると知りました。CLIはエンジニアにとって馴染みのある入口ですが、土台にすることもできます。CLIをサービス層として包み、そのサービス層にフロントエンドを用意すれば、非エンジニアでもこれらの機能を使えます。さらにServer側に独自の機能を足せば、それは単なるコマンドラインツールではなく、スマートサービスになります。
この考えに基づいて、私は2つのことをしました。
- 自分が書いたskillsを、このサービス層にインストールする。
- サービス層を AI& CLI ツールにつなぐ。フロントエンドから顧客の要望が入ってきたら、サービス層が私のskillsとAI&エンジンを使い、AI LLM APIを呼び出してskillsを実行・駆動し、スクリプトを分割して1つずつ生成し、最後に標準JSONを返す。
このアイデアは成功しました。フロントエンドはskillの内部構造を理解する必要がなく、サービス層も要望ごとにフローを書き直す必要がありません。双方は標準JSONでつながります。
同じ考え方で、AI& がMiniMaxの動画モデルを呼び出す新機能を出したことにも気づきました。ドキュメントを読むと、この動画モデルは音声で動画生成を導く機能にも対応しています。そこで私はサービス層に「Action」と呼ぶ機能を作りました。フロントエンドが情報を送ると、サービス層がバックグラウンドでAI& CLIを呼び、さらにMiniMaxのモデルを呼び出して動画を生成します。これも完成しました。
驚いたのは価格です。動画生成の料金は1秒あたり10円でした。私は約1分の動画を生成し、合計で500〜600円かかっただけでした。このコストは予想をはるかに下回り、本当に太っ腹だと感じました。
振り返ると、AI& は見事に仕事を果たしてくれました。私はそれをサーバー側の命令に変えました。さらに重要なのは、このアーキテクチャが広く再利用できることです。フロントエンドを整え、AIをサーバーの中心的な入口層として置き、そこにActionとSkillsを設定してサービスを提供する。これにより、AI& の能力はより多くの用途に広がり、開発者はより良く、より賢いサービスを一般ユーザーに届けられます。
第3層:音声を先に。ボイスオーバーが映像を決める
第3層は、今回の実践で私が見つけ、今後も提唱していきたい新しいやり方です。音声で動画生成を駆動する、という方法です。
問題は具体的でした。節ごとに生成した動画は、しばしばつながりを感じられません。私の解決策は、プロンプトをさらに積み上げることではなく、先にボイスオーバーを書き上げることでした。判断基準もシンプルです。映像を見ず、音声だけを聞いて物語を感じられるか。感じられるなら、半分は成功したも同然です。
次に、ボイスオーバーのファイルを段落ごとに切ります。その各段落の音声を参照として、MiniMaxのモデルで対応する動画を生成します。モデルは音声の意味を参照し、動きを想像して内容を生成します。映像を大量に説明するプロンプトを書くよりも、この方法は現実的です。声そのものに感情、リズム、意図が宿っており、生成される動画には中心となる意図と目的が通っています。映像の仕上がりも非常に良いと感じました。
3つの検証は、すべて成功した
今回のハッカソンで、私は3つの検証を完了し、そのすべてに成功しました。連続して制作できる動画システム、AIの能力を一般ユーザーに届けるサービス層アーキテクチャ、そして音声を先行させる動画生成方法です。私にとって、これは単にデモを1つ作るよりも価値のあることでした。
最後に、主催者の+81 Buildersに感謝します。素晴らしいスポンサー、とても良い会場、そしてとてもおいしいピザを用意してくれました。イベントがますます発展することを願っています。