
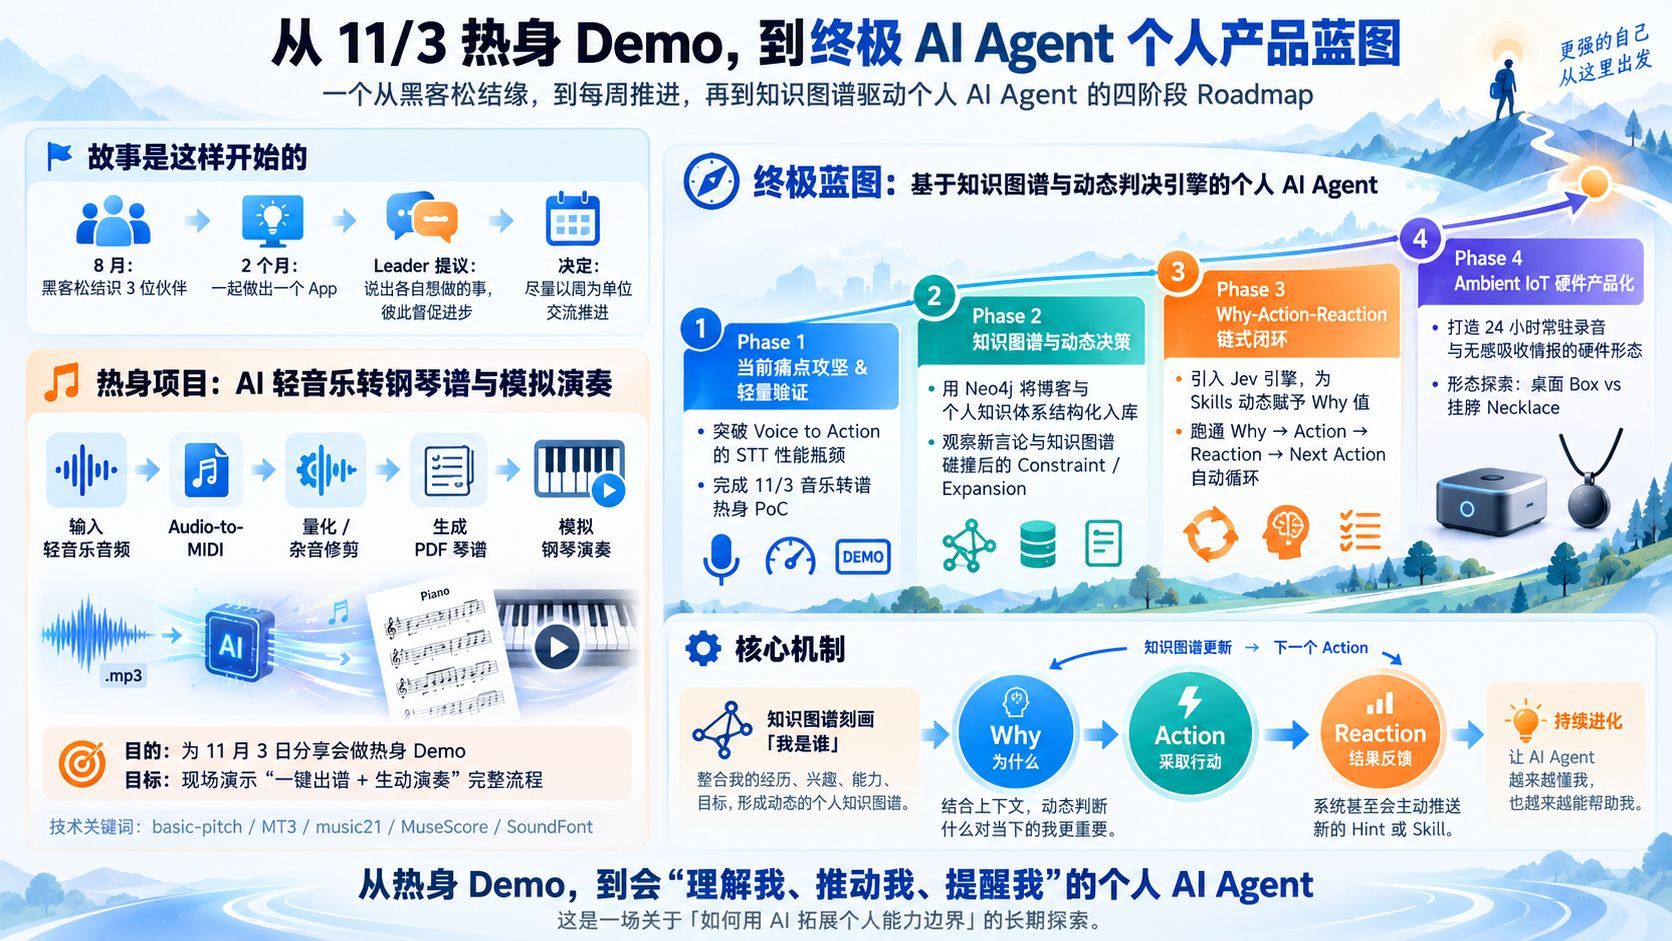
从 11 月 3 日的一场热身 Demo,到我的 AI Agent 四阶段蓝图
11 月 3 日与朋友的小型分享会前,我先做一个把轻音乐自动转成钢琴谱并模拟演奏的热身 Demo,用它验证音频处理与 MIDI 生成链路。之后回到核心产品:用 Neo4j 知识图谱为 Agent 赋予动态的“Why”,并沿 STT 提速、知识碰撞、Why-Action-Reaction 闭环、Ambient IoT 硬件化四个阶段推进。文章也记录了目前尚未确定的问题与每周推进的方式。

故事是这样的:
8月份,缘分的使然,在黑客松上结识了三个小伙伴。我们一起经过两个月的时间,做了一个 App。
黑客松完事后,发现大家彼此非常合得来。其中 leader 提议:既然这么合得来,不如把各自想做的事儿都说出来,互相督促进步。如果在做事的过程中能有焦点交流,对彼此也是帮助。
我们探讨后决定,尽可能以周为单位去交流推进.
那么,以下是我想到要做的事:
🚀 从11月3日的热身 Demo,到我的终极 AI Agent 个人产品蓝图
最近一段时间,随着新工作的过渡和各种应酬安排,日程被填得很满。但在工作之余,关于 AI、关于 Agent 机制、关于“我是谁以及如何让 AI 真正赋能个人”的思考,其实一直没有停过。
为了给即将到来的 11月3日与朋友们的小型分享会 准备一个有趣的 Demo,我决定先从一个一直想尝试的“热身项目”切入,随后再逐步推进我心中那个真正的终极产品。
下面我梳理一下我接下来要做的事情,以及我的 四阶段(Phase 1 ~ 4)产品 Roadmap。
🎹 热身项目:AI 轻音乐转钢琴谱与模拟演奏
为什么先做这个? 这个项目并不是我的终极产品,而是我用来为 11/3 分享会热身、顺便验证音频处理与 MIDI 生成 Pipeline 的小实验。
我一直很想做一件事:把一段好听的轻音乐,自动转化成高质量的钢琴五线谱,并能够现场进行模拟演奏。
- 技术路经:利用开源的 Audio-to-MIDI 模型(如
basic-pitch/MT3),结合 Python 脚本做音符量化(Quantization)与杂音修剪,最后通过music21+MuseScore渲染成漂亮的 PDF 琴谱,并挂载 SoundFont 音色库生成高还原度的模拟演奏。 - 目标:在 11 月 3 日分享会现场,向朋友们展示从“输入一段音频”到“一键出谱 + 生动演奏”的完整流程!
🧭 终极蓝图:基于知识图谱与动态判决引擎的个人 AI Agent
热身之后,我将全力回归到我的核心产品研发上。
传统 Agent 的逻辑大多是静态、硬编码的条件判断。而我想探索的新 Path 是:利用 Neo4j 知识图谱赋予 Agent 动态演进的“Why”值,让知识图谱体现“我”是一个什么样的人,结合说的话与上下文,自动推演并联动触发下一个 Action。
以下是我的四阶段推进计划:
[Phase 1:当前痛点攻坚 & 轻量验证]
 └── Voice to Action 的语音转文字 (STT) 性能突破(解决 CPU 小电脑的耗时瓶颈)

[Phase 2:知识图谱与动态决策]
 ├── Neo4j 知识图谱实战(将日常博客与个人知识体系结构化入库)
 └── 融合 Analogy(类比)模型:观察个人知识体与新言论碰撞后的“约束”与“扩展”

[Phase 3:Why-Action-Reaction 链式闭环]
 ├── 引入 Jev 引擎:让知识图谱反向给 Skills 赋予动态“Why”值
 └── 跑通自动链式循环(Why ➔ Action ➔ Reaction ➔ 自动触发下一个 Action)

[Phase 4:终极 Ambient IoT 硬件产品化]
 └── 打造 24 小时常驻录音与无感吸收情报的硬件形态(桌面 Box vs 挂脖 Necklace)
🛠 各阶段核心细节
Phase 1:痛点攻坚(STT 加速与热身)
之前把 Voice to Action 的眼镜和引擎调通了,但家里的 CPU 小电脑跑 STT 非常耗时。后续会尝试接入 Groq API (Whisper large-v3) 或本地 faster-whisper(CTranslate2)来突破性能瓶颈。
Phase 2:Neo4j Ontology 与知识碰撞
我每天都在写博客、积累知识。我很好奇,当把这些知识转化为 Neo4j 中的 Knowledge Graph(实体与关系)后,我平时说的话、产生的新灵感与这个知识图谱碰撞时,到底会约束我的话(Constraint),还是扩展我的话(Expansion)?
Phase 3:Why-Action-Reaction 动态判决引擎
这是最核心的一步:
- Why:结合 Neo4j 中“我的画像与上下文”,动态计算出某件事对现在的我为什么重要(赋予 Why 值)。
- Action:触发预设或动态生成的 Skills。
- Reaction:Action 产生的输出反馈给图谱,自动联动触发下一个 Action。
系统会尝试自己“审视我”,看我是否需要一个新的 Skill Action,甚至在我还没想到的时候,自动给我推送一个 hint。
Phase 4:Ambient IoT 终极形态
最终,它会落脚在一个硬件产品上——比如一个放在桌面 24 小时开启录音的 Ambient Box,或者一个随身携带的 AI 项链/挂坠。它没有强烈的“录音/操作”感知,而是像空气一样默默吸收情报,在后台自动判断、自动处理、自动生成动画或博客。
💬 结语
从 11 月 3 日的音乐转谱小 Demo,到后续构建动态演进的 Why-Action-Reaction 知识引擎,这是一场关于“如何用 AI 拓展个人能力边界”的长期探索。
如果你对音乐转谱、Neo4j 知识图谱,或是 AI Agent 的动态判决机制感兴趣,欢迎关注后续的进展!