
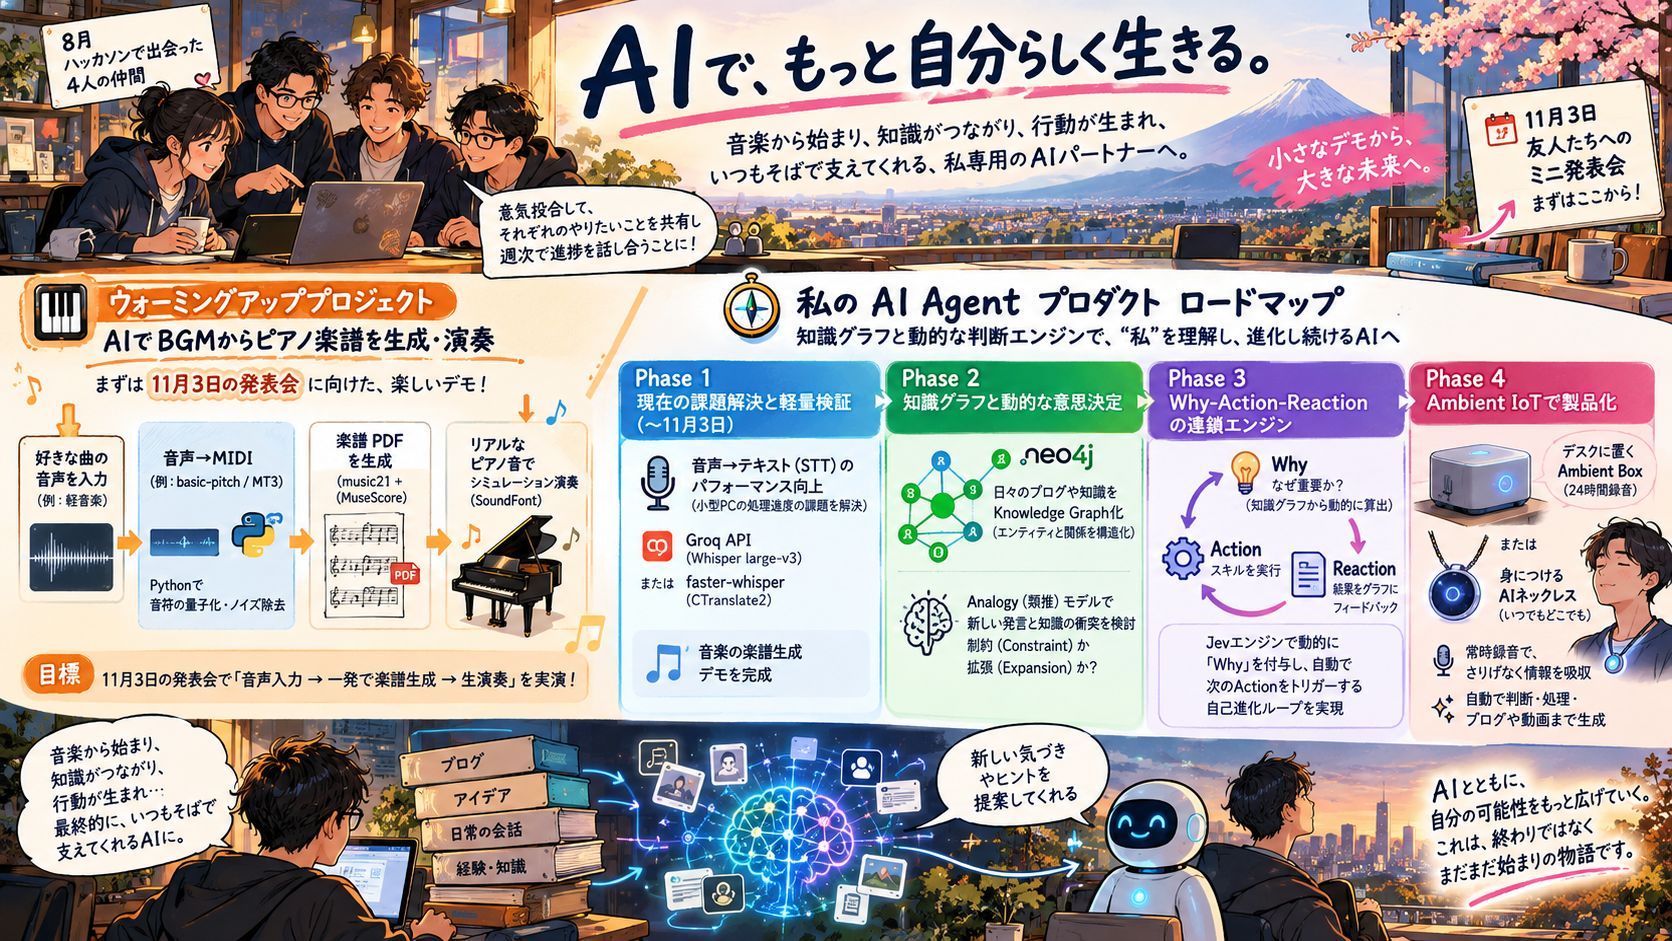
11月3日のウォームアップDemoから、AI Agent四段階ロードマップへ
11月3日の共有会に向け、軽音楽を自動でピアノ譜にするウォームアップDemoを作る。Audio-to-MIDIやmusic21、MuseScoreで、音声入力から楽譜生成・模擬演奏までを検証。その後はNeo4jのナレッジグラフで「Why」を与えるAI Agentの四段階ロードマップへ。STT高速化、知識との衝突、Why-Action-Reactionの連鎖、Ambient IoTのハードウェア化までの構想と未解決の問いをまとめた。

11月3日のウォームアップDemoから、私のAI Agent四段階ロードマップへ
現在の多くのAgentは、静的なハードコードされた条件分岐で動いている。AならBを実行する、という具合だ。私が作りたいプロダクトは、その前にもう一つの問いに答えたい——「今の自分にとって、この出来事はなぜ重要か」。
ただし、その最終目標の話をする前に、まず宿題を済ませる必要がある。11月3日、友人たちと小さな共有会を開くので、そのために軽音楽を自動でピアノ譜にするウォームアップDemoを先に作り、それから本当のコアプロダクトに戻るつもりだ。
最近は仕事の移行やさまざまな付き合いで予定がびっしり詰まっている。それでも、AIについて、Agentの仕組みについて、「自分は誰で、どうすればAIが個人を本当に後押しできるのか」についての思考は止まっていない。
まず宿題:軽音楽を自動でピアノ譜にする
最初にやりたいことは具体的だ。心地よい軽音楽を、それなりの品質のピアノ五線譜に自動変換し、その場で模擬演奏できるようにする。
このプロジェクトは最終プロダクトではない。まずは11月3日の共有会に向けた面白いDemoであり、同時に音声処理とMIDI生成パイプラインの検証でもある。技術的な流れはおおよそ次の通りだ。オープンソースのAudio-to-MIDIモデル(basic-pitchやMT3など)で音符を認識し、Pythonスクリプトで音符のクオンタイズ(Quantization)と雑音除去を行い、music21 + MuseScoreでPDFの楽譜にレンダリングし、最後にSoundFont音源を組み合わせて再現度の高い模擬演奏を生成する。
目標は明確だ。共有会の場で、「音声を入力する」ところから「ワンクリックで楽譜が出て、生き生きと演奏される」ところまでの一連の流れを友人たちに見せる。聴く人にとってはデモだが、私にとっては音声処理のパイプラインを前もって検証する機会でもある——まずこの流れを一つの具体的なDemoで通す。
最終目標:Agentに「なぜ」を知らせる
ウォームアップが終わったら、本格的にコアプロダクトへ戻る。
従来のAgentのロジックは、多くが静的でハードコードされた条件分岐だ。私が模索するもう一つの道は、Neo4jのナレッジグラフでAgentに動的に進化する「Why」の値を与えることだ。ナレッジグラフが表すのは「自分がどんな人間か」——私の経験、判断、好み、知識の構造だ。そこに私が話すことと言葉の文脈を組み合わせ、システムが自動的に推論し、次のActionを連動して起動する。
つまりAgentは、あらかじめ書かれた指示を実行するだけではない。まず「今の自分にとってなぜ重要か」を判断し、それから何をするかを決める。
四段階のロードマップ
Phase 1:目の前の性能ボトルネックを解消する
以前、Voice to Actionのグラスとエンジンは動くところまで来た。ただ、家のCPUの小型PCでSTTを動かすと非常に時間がかかる。これが今もっとも直接的な課題だ。次はGroq API(Whisper large-v3)の接続、あるいはローカルのfaster-whisper(CTranslate2)を試し、この性能の壁を突破できるかを見る。
このフェーズにはもう一つ成果物がある。11月3日の音楽採譜ウォームアップPoCのデモを完成させることだ。
Phase 2:個人の知識をNeo4jに入れ、新しい表現との衝突を観察する
私は毎日ブログを書き、知識を蓄積している。それがNeo4jのKnowledge Graph(エンティティと関係)に変換されたとき、普段の言葉や新しい着想がこのグラフと衝突したら、私の発言を制約するのか(Constraint)、それとも拡張するのか(Expansion)。それがとても気になっている。
さらに、Analogy(類推)モデルを組み合わせ、個人の知識体系と新しい言説が衝突した後、その「制約」と「拡張」が具体的にどこで起きるのかを観察したい。
Phase 3:Why → Action → Reactionの連鎖ループ
これはロードマップの中で最も核心的なステップだ。
- Why:Neo4jの中の「自分のプロフィールと文脈」を組み合わせ、ある出来事が今の自分にとってなぜ重要かを動的に計算する。つまりWhyの値を与える。
- Action:あらかじめ用意したSkills、または動的に生成したSkillsを起動する。
- Reaction:Actionの出力をグラフにフィードバックし、次のActionを自動で連動起動する。
このループにJevエンジンを導入し、ナレッジグラフからSkillsへ逆向きに動的な「Why」の値を与え、自動連鎖の循環を走らせる。システムは自ら私を省みようとし、新しいSkill Actionが必要かどうかを判断する。私がまだ思いついていないうちに、先にhintをプッシュしてくることもあるだろう。
Phase 4:Ambient IoTという最終形態
最終的には、ハードウェアプロダクトに着地する。机の上に置いて24時間録音し続けるAmbient Boxかもしれないし、持ち歩くAIネックレス/ペンダント(Necklace)かもしれない。
「今、録音している/操作している」と強く意識させるものにはしたくない。より理想的なのは、空気のように黙って情報を吸収し、バックグラウンドで自動的に判断し、処理し、アニメーションやブログを自動生成する形だ。
まだ答えのない二つのこと、そして決まっている進め方
この路線には、今はまだ答えを出せない問題が二つある。
一つはPhase 2の衝突の結果だ。ナレッジグラフは私の発言をより収束させるのか、それとも可能性を広げるのか。これは実際にグラフを組み、しばらく使ってみないと分からない。
もう一つはPhase 4のハードウェアの形だ。机の上のBoxは固定された場面での継続的な集音に近く、ペンダントは持ち歩きと無意識さに近い。それぞれ異なる使い方を指している。まだ決めていないし、検証が済む前に固定するつもりもない。
決まっているのは進め方だ。今年8月、私はハッカソンで三人の仲間と出会った。一緒に二か月かけてアプリを作り、終わってみると意外に気が合うことが分かった。リーダーが「これだけ気が合うなら、それぞれやりたいことを出し合って互いに励まし合おう。集中して話せる場があれば、お互いの助けにもなる」と提案した。私たちは最終的に、できるだけ週単位で交流しながら進めることにした。このロードマップが、私が持ち出して進めているその題材だ。
この約束は私にとって制約になる。毎週、少しでも実際の進捗を出さなければならず、ロードマップのまま止まってはいられない。11月3日のDemoは、その最初の検証可能な節目だ。
おわりに
11月3日の音楽採譜の小さなDemoから、動的に進化するWhy-Action-Reactionの知識エンジンを築くところまで。これは「AIで個人の能力の境界をどう広げるか」をめぐる長期的な探索だ。
音楽の採譜、Neo4jのナレッジグラフ、あるいはAI Agentの動的な判定機構に興味があれば、ぜひ今後の進展を見守ってほしい。11月3日の共有会で会おう。