从聊天窗口到软件工厂:Antigravity 如何改变开发的组织方式
在 Antigravity 的 deep dive 上,Google 的资深开发者关系工程师提出:AI 编程不应停留在“更聪明的聊天对象”,而应把开发组织成并行装配线式的“软件工厂”。文章梳理模型与 harness 的共同进化、/boost 与 Teamwork Preview 的结构化委派、cron 与钩子触发的自动化、源自丰田自働化的停线与验证机制、.gemini/brain 的状态持久化,以及搭建产线的五个步骤。

从聊天窗口到软件工厂:Antigravity 想改变的不是模型,而是开发的组织方式
“如果你已经在使用 Antigravity,请举手。”
在 Antigravity 的 deep dive 开场,这位在 Google 工作了六年的资深开发者关系工程师做了几轮举手调查:用过 Gemini 的人有多少,主要只靠 IDE 自动补全的人有多少,把侧边聊天窗口当作主界面的人有多少,完全跑在 CLI 里的人又有多少。答案的分布本身就指向他要讲的问题——大多数人仍然把 AI 编程理解成“一个更聪明的对话对象”。
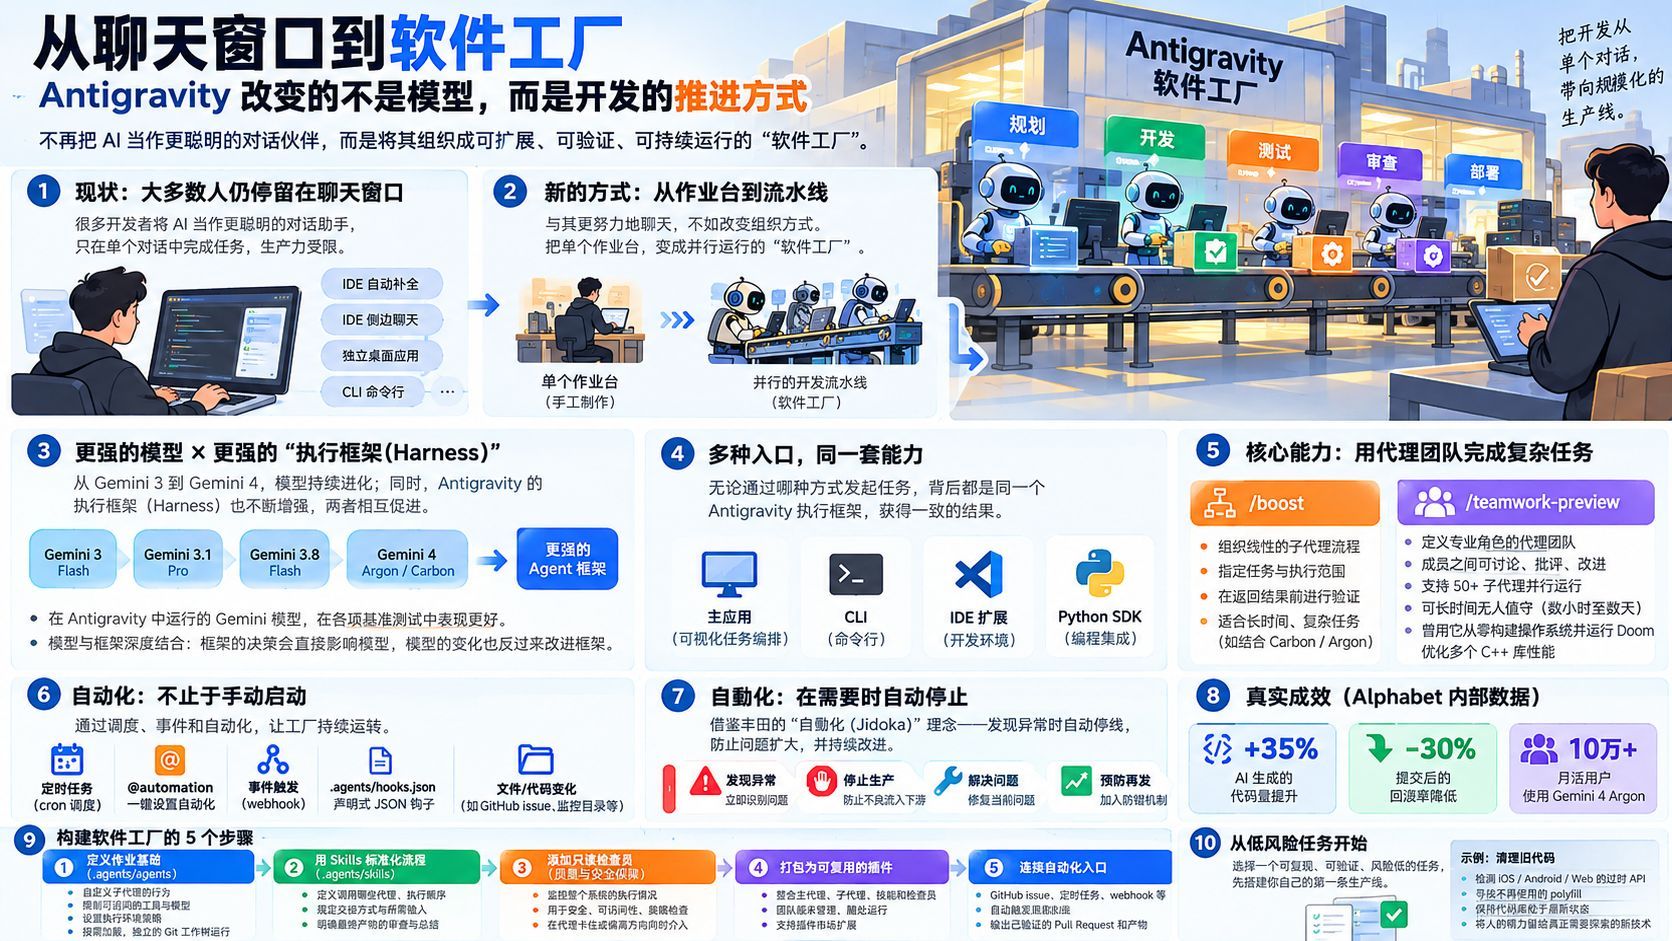
他的判断更进了一步:只盯着一个聊天线程,就像工匠守着一张工作台。你能同时推进多少项目,受限于打字速度、审阅速度,以及在上下文之间反复切换的代价。想扩大产出,靠更努力地聊天没有用,得换一种组织方式:从单张工作台走向并行装配线,也就是他所说的“软件工厂”。
模型在变强,承载模型的“马具”也在变强
他把转折点定在去年 12 月。从那之后,模型更新一波接一波:先是 Gemini 3 Flash,然后是 Gemini 3.1 Pro,接着是所有 Flash 型号,包括 Gemini 3.8 Flash;到现在,已经有了 Gemini 4、Argon 和 Carbon。每一次更新,都配着能力更强的智能体框架。
Antigravity 团队与模型团队、研究部门的合作非常紧密。用他的话说,他们在“马具”(harness)层面做的某些决定会直接影响模型,模型的变化也会反过来改变 harness 的设计。最近公布的一些基准测试显示,在 Antigravity 里运行任何 Gemini 模型都能得到更好的结果。他的建议很直接:如果你以前在 Antigravity 之外用过 Gemini,不妨用最新版本再试一次。
这个变化也改变了开发界面的形态。早期模型写代码已经相当熟练,但处理复杂系统时,通常需要严格监督、广泛的防护措施和仔细的上下文范围界定,才能避免它写入非预期的文件或目录。随着模型和 harness 一起成熟,交互方式从逐行自动补全,过渡到 IDE 聊天,再过渡到专用的桌面端和 CLI 智能体环境。现场调查也印证了这种分化:有人只要补全,有人守着侧边聊天,有人已经把所有工作交给命令行。
Antigravity 去年底发布时,团队的目标之一就是从零开始做一个“智能体优先”的开发环境。这位工程师此前支持过 Project IDX(后来重组为 Firebase Studio),也参与过 Gemini CLI;最近,Jules 的许多能力又被整合进 Antigravity。反复出现的问题是:每个产品如何为其他产品提供输入,从而形成持续改进。今年 Google I/O 上,他们把能力拆成四个入口:主 App、CLI、IDE 扩展和 Python SDK。无论你是在 App 里可视化地组织任务,还是在终端里发起任务,背后是同一套 harness,结果也应当一致。
“软件工厂”不是新比喻,日本在半个多世纪前就试过
“软件工厂”这个词,其实早于现代人工智能几十年就在日本成为现实。1969 年,日立在横滨建立了世界上第一家软件工厂;1977 年,东芝在东京也建了一家。正如一位麻省理工学院教授所记录的那样,日本的工程领导者把软件开发从一项孤立的技艺,转变为可重复的学科:采用可复用的组件,建立严格的质量控制体系。
这段历史恰好解释了为什么“多开几个聊天窗口”不等于规模化。工匠的工作台可以做出精品,但产量被绑在一个人身上。装配线改变的是分工、交接和检验方式。Antigravity 想做的,就是把这三件事搬进智能体开发。
第一步:把同步聊天换成结构化委派
在 Antigravity 里,这一步有两个代表性功能:/boost 和 /teamwork-preview。
/boost 协调一条线性装配线上的一组子代理。你可以指定任务,以及每个“工位”的执行范围;它会在返回结果之前先验证结果。这位工程师常把 Boost 与 Carbon、Argon 搭配使用,用来跑时间很长、又希望尽量少压缩上下文的任务。
/teamwork-preview 则定义一支由专业角色组成的完整团队,成员之间可以互相提建议、批评和改进对方的工作。团队可以在运行时动态调整。你可以启动 50 个甚至更多子代理,这会消耗大量 token,但它们能无人值守地跑上几个小时,有时是几天。他团队里的许多人已经用它开“通宵会议”:下班前启动流程,第二天早上直接审阅结果。
I/O 上的演示展示了这种规模的潜力:借助 Teamwork Preview 和 Flash 模型,他们从零构建了一个操作系统——把 C++ 编译成操作系统,甚至让它跑起了 Doom;他们还用这套方式优化了多个库的 C++ 性能。在阿贡国家实验室的发布会上,他们讨论了如何帮助企业把 Fortran、COBOL 或旧版 C++ 代码库迁移到现代 Rust,从而解决内存性能问题,让科学计算在现代硬件上高效运行。
任务跑得越久,人越不可能一直盯着。Antigravity 的 Remote Control 允许你从任何浏览器连接到工作站,更重要的是,它能把通知发到手机甚至手表上。现在模型可能需要一个半小时到三个小时才返回结果,你只需要在权限提示需要批准,或者发现方向不对需要干预时出现。用他的话说:只有当“议会”需要你拍板时,你才介入。
第二步:把“手动发起”也去掉
从聊天走向委派,相当于在工厂里接上了流水线。但流水线仍然需要有人送原料、按启动键。下一步是消除手动调用。
Antigravity 支持按 cron 计划运行的计划任务和自动化流程。现在配置也更简单:用一条 @automation 命令,它就会替你完成设置。可以自动化的对象,就是那些每天重复的事:给夜间错误报告分类、分析基准测试、审核依赖项,或者创建在你打开笔记本之前就已经开始工作的主动代理。
除了时间表,.agents/hooks.json 里还提供了声明式 JSON 钩子。后台的 sidecar 可以监听生命周期和事件,自动验证代码、触发产线。一旦事件发生,工厂车间就能立刻启动。如果你还没用过 sidecar,可以把它理解成一套类似 webhook 的机制:在需要的时候把 Antigravity 叫起来。
自働化:让产线在该停的时候自己停下
要成为真正的软件工厂,还需要一个从一端输入原料、另一端输出成品的系统。丰田生产系统里的“自働化”(Jidoka)常被翻译成“带人工干预的自动化”,其起点是 1924 年的一台自动织布机。
在此之前,每台织布机都需要一名操作员持续监控,因为一根断线可能让大量布料变成次品。没有监督的 AI 也有类似风险:大量上下文和 token 可能被浪费在无关信息或错误方向上。那台织布机的不同之处在于,线一断,它就自己停下。于是,一名操作员可以同时照看 40 台织布机。
丰田后来把这种做法推广成四个步骤:立即发现异常;用绳索拉停产线,防止缺陷流向下游;修复当前问题;再采取防错措施,避免同样的错误再次发生。
Antigravity 试图把同样的原则写进开发流程。你在里面创建的每一条产线,背后都有一个 .gemini/brain 文件夹:聊天记录、操作步骤文档和独立的 Git 工作树都会留下完整的 JSON 轨迹,所有内容自动持久化。这种基于磁盘的状态让你可以暂停、切换和恢复工作流,而不丢进度。配额用完、需要换模型,或者要修掉某个出错的地方,都可以干净利落地停下来。
这套机制在 Alphabet 内部已经有实际数据。据这位工程师介绍,超过 10 万名月活跃用户在公司内部的 Antigravity 环境中使用 Gemini 4 Argon;智能体编写的代码量增加了 35%,提交后的回滚减少了 30%。因为验证被直接放进生产流程,整体生产速度提高了,缺陷率反而降低了。这些是内部统计,不是独立审计,但它们说明了一件事:产线的价值不只在于“更快”,更在于每一步都可验证、可回退。
搭建一条产线的五个步骤
他把在 Antigravity 里搭软件工厂拆成五步,核心组件是自定义子代理、技能(Skills)和插件。
第一,定义工作基元。 它们放在 .agents/agents 里。你可以用 Markdown 文件和自定义子代理完整定义行为:限定它能访问的 MCP 服务器和工具,规定执行环境策略,甚至为每个子代理指定模型。这样也可以存在大量子代理,而它们只在实际被调用时才加载上下文。运行时,这些基元在各自独立的 Git 工作树中并发执行,具备动态模型选择、范围沙箱和实时状态跟踪。
第二,用 Skills 把流程写成标准作业程序。 它们放在 .agents/skills。一条产线要规定:哪些工人被直接叫到、按什么顺序叫、在独立工作树之间何时以及如何交接;在继续下一步之前需要哪些研究和定义材料;最终要审查和总结哪些成果。
第三,加入只读的巡检员。 用只读的自定义子代理审核系统中发生的一切,适合做安全检查、可访问性监控和策略强制执行。他也喜欢用它来处理另一种情况:某个子代理卡住了,或者看起来正要漂移到错误的上下文里,就让这些“巡检员”来管住局面。Google 的一些团队已经把这些能力做进插件,例如 Flutter 团队的可访问性检查、Firebase 规则检查,以及 Google Play 的预提交审核。
第四,打包成可移植的插件。 把主工厂代理、子代理、技能和巡检员整合成一个 Antigravity 插件,整个团队就能对它做版本控制,并在任何地方运行。他们也宣布了插件市场的扩展。
第五,接上自动化入口。 让原料到达时自动触发主代理:GitHub 上新增 issue、每日定时任务、webhook,或者监控 NAS 上的某个文件夹。这样 CI 流水线就能运行,并在结束时交付经过验证的拉取请求和演练工件。
产线运行期间,巡检员一旦发现问题,就会暂停生产线、立即止损,并把改进反馈到代理、技能和工作流里,让下一条产线更聪明。需要做真正的架构权衡时,还可以通过手机上的远程控制介入。这一点会越来越重要,因为这些系统正变得越来越具备自我修复和持续改进的能力。
从最没有风险的地方开始
如果不知道从哪里下手,他的建议是:找一件可重复、可验证、低风险的事,先把它变成产线。
他自己的例子是“删除旧代码”。他搭了一个系统,用来检查 iOS、Android 和 Web 的 API,找出已经过时的 polyfill 或不再使用的 API。他在 Web 开发方面经验丰富,因此很清楚这类清理的价值:它让代码库始终保持在前沿,而人可以把聊天代理留在真正需要探索的新技术上。
这也是整场分享最核心的转变:从管理对话里的每一个回合,转向设计一条产线,并在需要判断的地方介入。软件工厂的重点从来不是“无人”,而是让每一步都可验证、可停止、可恢复——只有这样,规模才不是把同一个工作台复制很多份,而是真的换了一种生产方式。