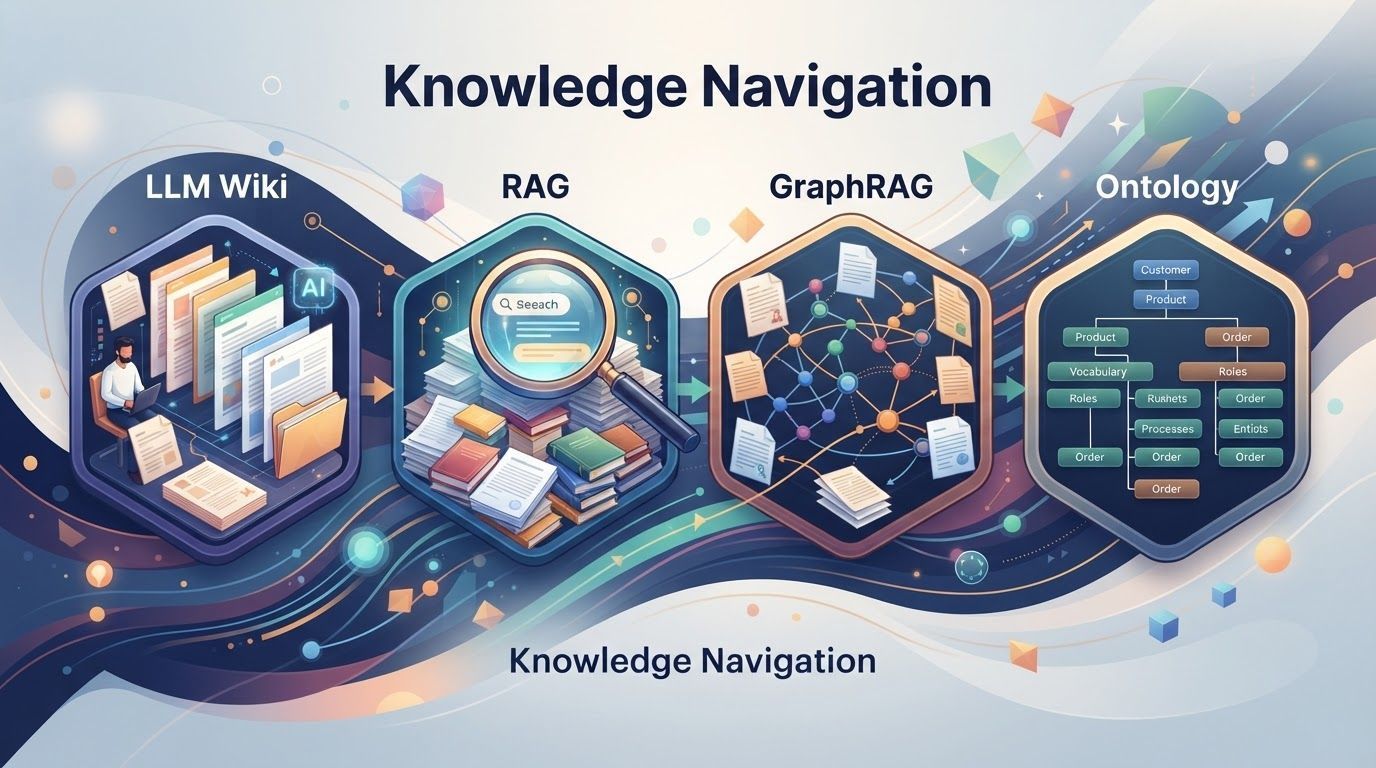
RAG、GraphRAG、LLM Wiki 与 Ontology:四种知识库技术怎么选
四种技术解决的不是同一个问题:LLM Wiki 整理个人资料,RAG 做企业文档问答,GraphRAG 追踪跨文档的实体关系,Ontology 统一多系统的业务语义。文章用项目 A 的同一组例子拆开原理、边界与组合方式,并说明两种「图谱」为什么不是一回事。

支持对已公开的 133 篇文章进行关键词模糊搜索、分类与标签筛选。
四种技术解决的不是同一个问题:LLM Wiki 整理个人资料,RAG 做企业文档问答,GraphRAG 追踪跨文档的实体关系,Ontology 统一多系统的业务语义。文章用项目 A 的同一组例子拆开原理、边界与组合方式,并说明两种「图谱」为什么不是一回事。
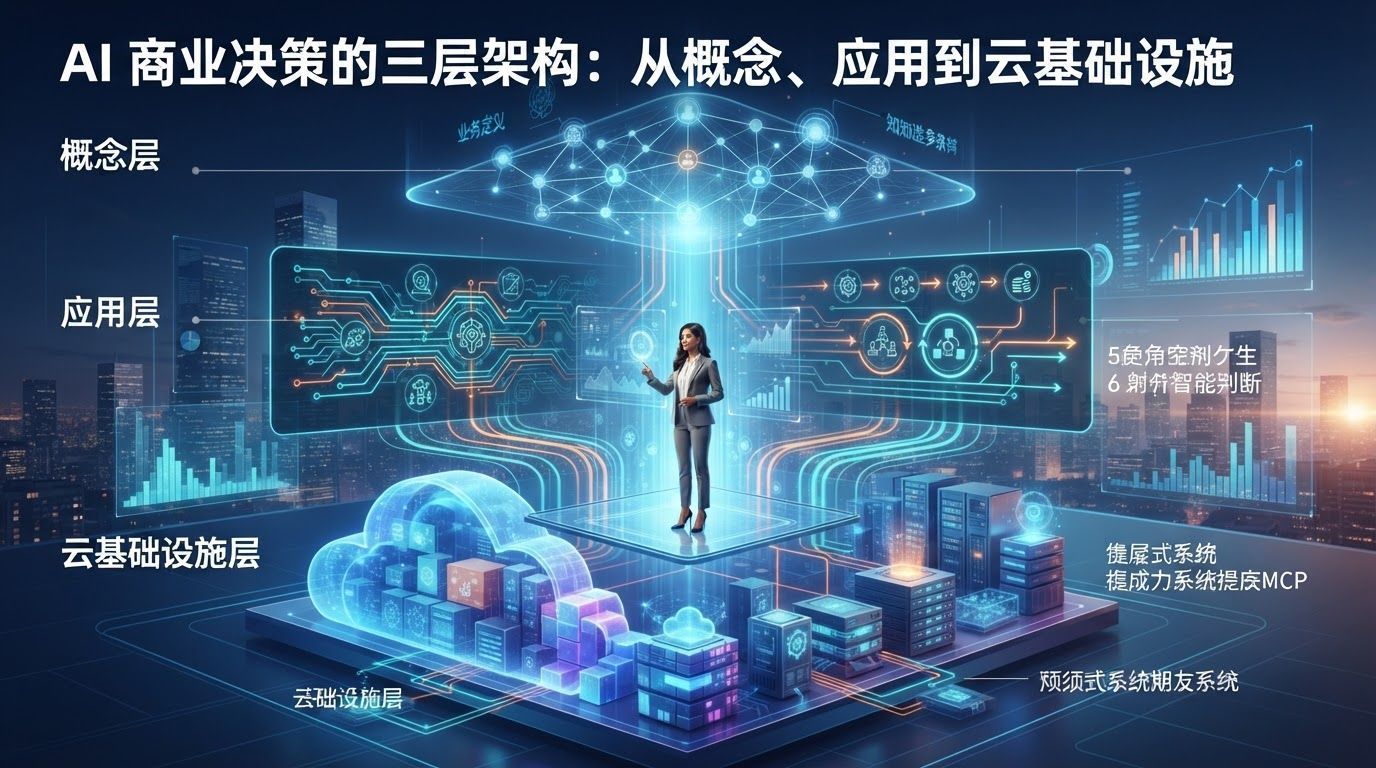
企业 AI 提案常常停在“需要知识图谱”的概念上。本文把它拆成三层:定义知识形态的概念层,抽取业务逻辑、让 AI 能判断的应用层,以及支撑判断与执行的云基础设施层。文章还讨论了由 5 个周期、6 种能力构成的判断框架,用 MCP 把旧系统包成 AI 可调用服务的 modernization 思路,以及为什么智能必须配得上执行。
本体、知识图谱、知识库、数据中台这些概念大多早于大模型出现,却在 LLM 时代重新变热。作者用自己搭建的企业知识图谱解释四者的关系,并从入库、查询、可追溯和 Agent 执行四个方面,说明大模型究竟改变了什么。
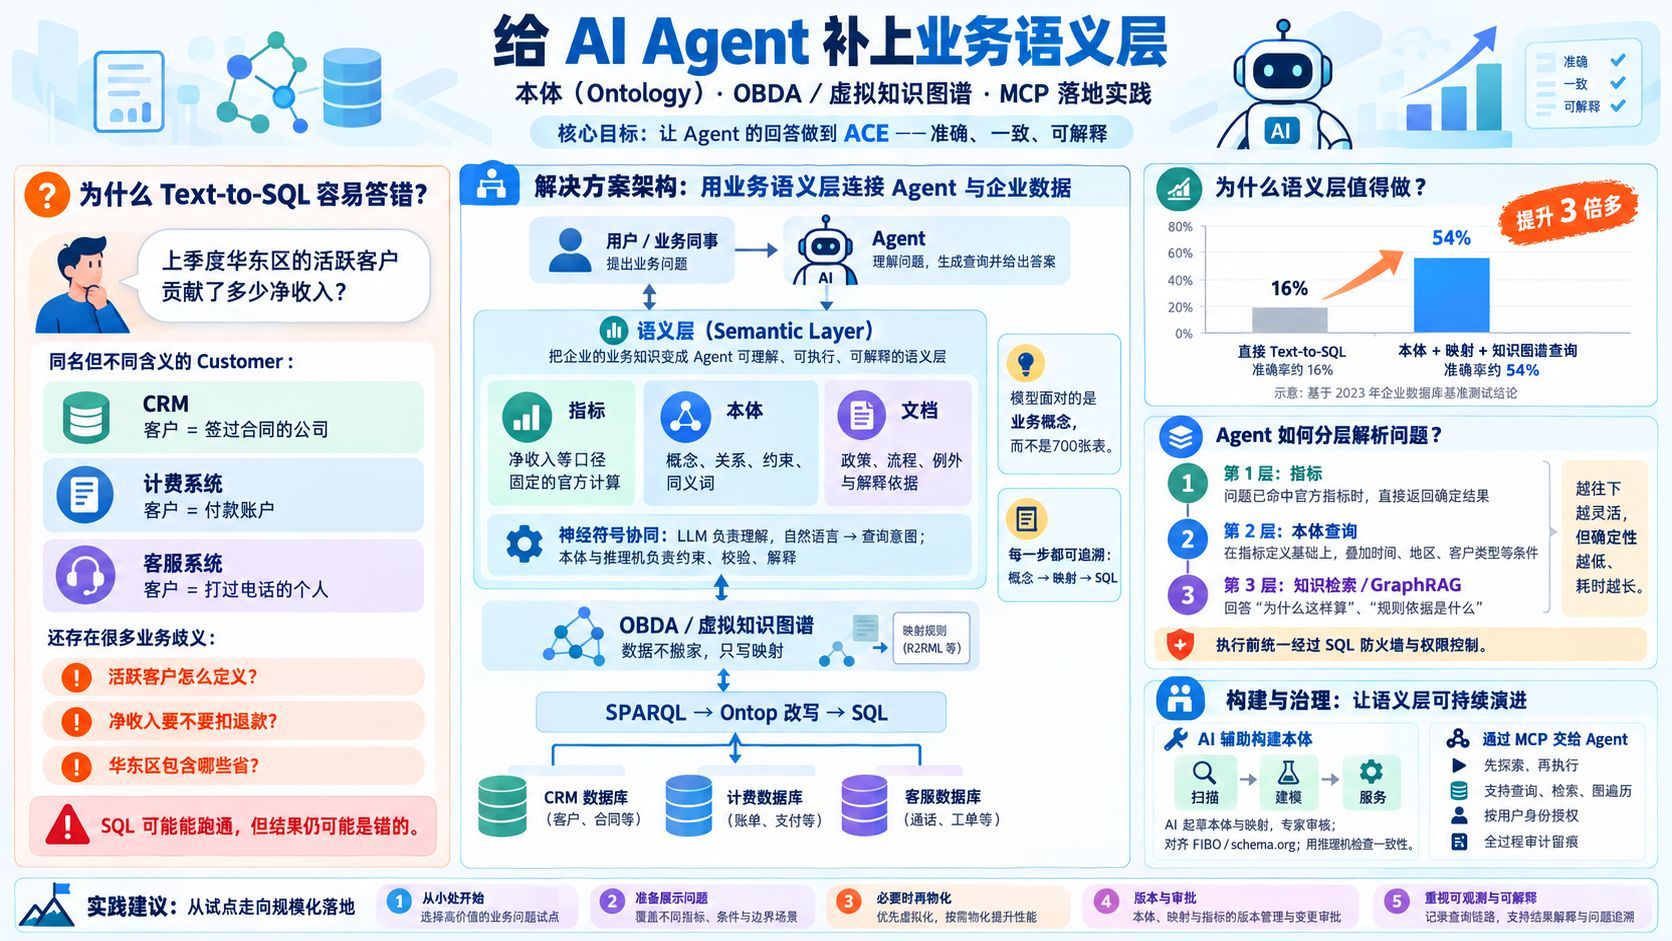
把表结构塞进提示词,并不能让 AI Agent 理解业务含义,它照样会给出看起来很专业、实际却算错的数字。本文以保险业基准测试中 GPT-4 执行准确率从约 16% 提升到约 54% 为例,讲清由指标、本体和文档组成的语义层,如何通过 OBDA(虚拟知识图谱)把本体直接映射到现有数据,并用分层解析兼顾确定性与灵活性。文章还介绍了用 AWS Context Ontology Accelerator 让 AI 起草本体、专家审核,以及 MCP 与身份感知的治理和五条实践建议。
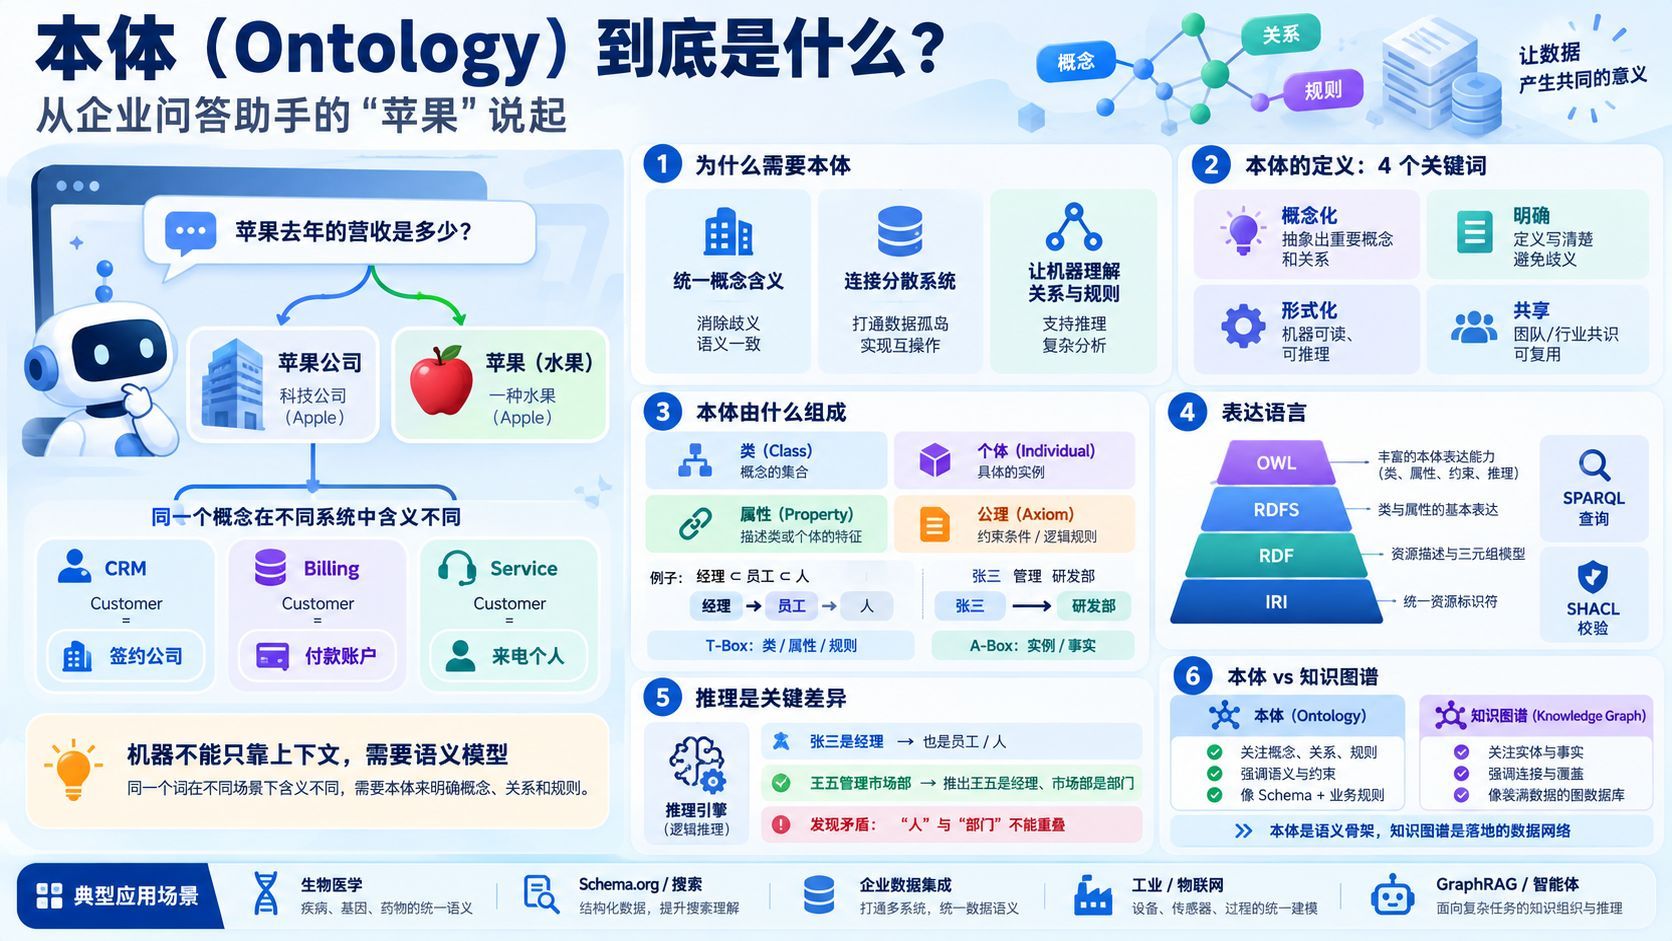
要让企业问答助手分清“苹果”是公司还是水果,并理解三张都叫 Customer 的表,机器需要的不是上下文,而是一个明确的语义模型——本体。本文从哲学起源讲到 Gruber 与 Studer 的定义,拆解类、个体、属性与公理,介绍 RDF、RDFS、OWL 及推理机的作用,梳理生物医学、Schema.org、企业集成、工业物联网和大模型时代的典型应用,并说明本体与知识图谱的区别以及动手构建的方法与常见错误。