
OpenAI Build Hour 深度解析:GPT Realtime 2.0 引领的“语音到行动”技术变革
本报告深入剖析了 OpenAI Build Hour 上发布的“GPT Realtime 2.0”技术细节,并结合企业实例探讨了语音 AI 智能体的落地实践。内容全面涵盖了低延迟端到端架构、情感表达、工具调用的重大演进,并为开发者提供了实用的上手开发指南。

OpenAI Build Hour:GPT Realtime 2.0 技术发布与企业实践分析报告
1. 概述 Overview
- 主题:GPT Realtime 2.0 新功能发布及其在提升语音 AI 智能体(Voice Agents)生产力中的应用。
- 举办日期:2026年5月13日
- 主要演讲嘉宾:
- Sarah Urbanus:OpenAI 初创企业营销负责人(主持人)。
- Terry:OpenAI 多模态人机交互(HCI)专家。
- Erica:OpenAI 解决方案工程师。
- Ken Murphy & Soham:Sierra 团队(企业级 AI 智能体合作伙伴)。
2. 执行摘要 Executive Summary
本届 Session 正式发布了专注于低延迟和高级推理能力的语音交互模型解决方案——“GPT Realtime 2.0”。该版本在指令执行能力(Instruction Following)、工具调用(Tool Calling)以及多语言表现上实现了大幅提升,并将延迟缩短至 200 毫秒级别。通过电商购物助手和产品分析仪表盘的现场演示,OpenAI 展示了“语音到行动(Voice-to-Action)”的无缝体验。此外,合作伙伴 Sierra 公司还分享了“Agent Harness”架构,旨在确保复杂的企业环境中语音 AI 的可靠性与安全性。
3. 议题核心内容深度解析 Detailed Discussion Points
A. GPT Realtime 2.0 模型能力的进化
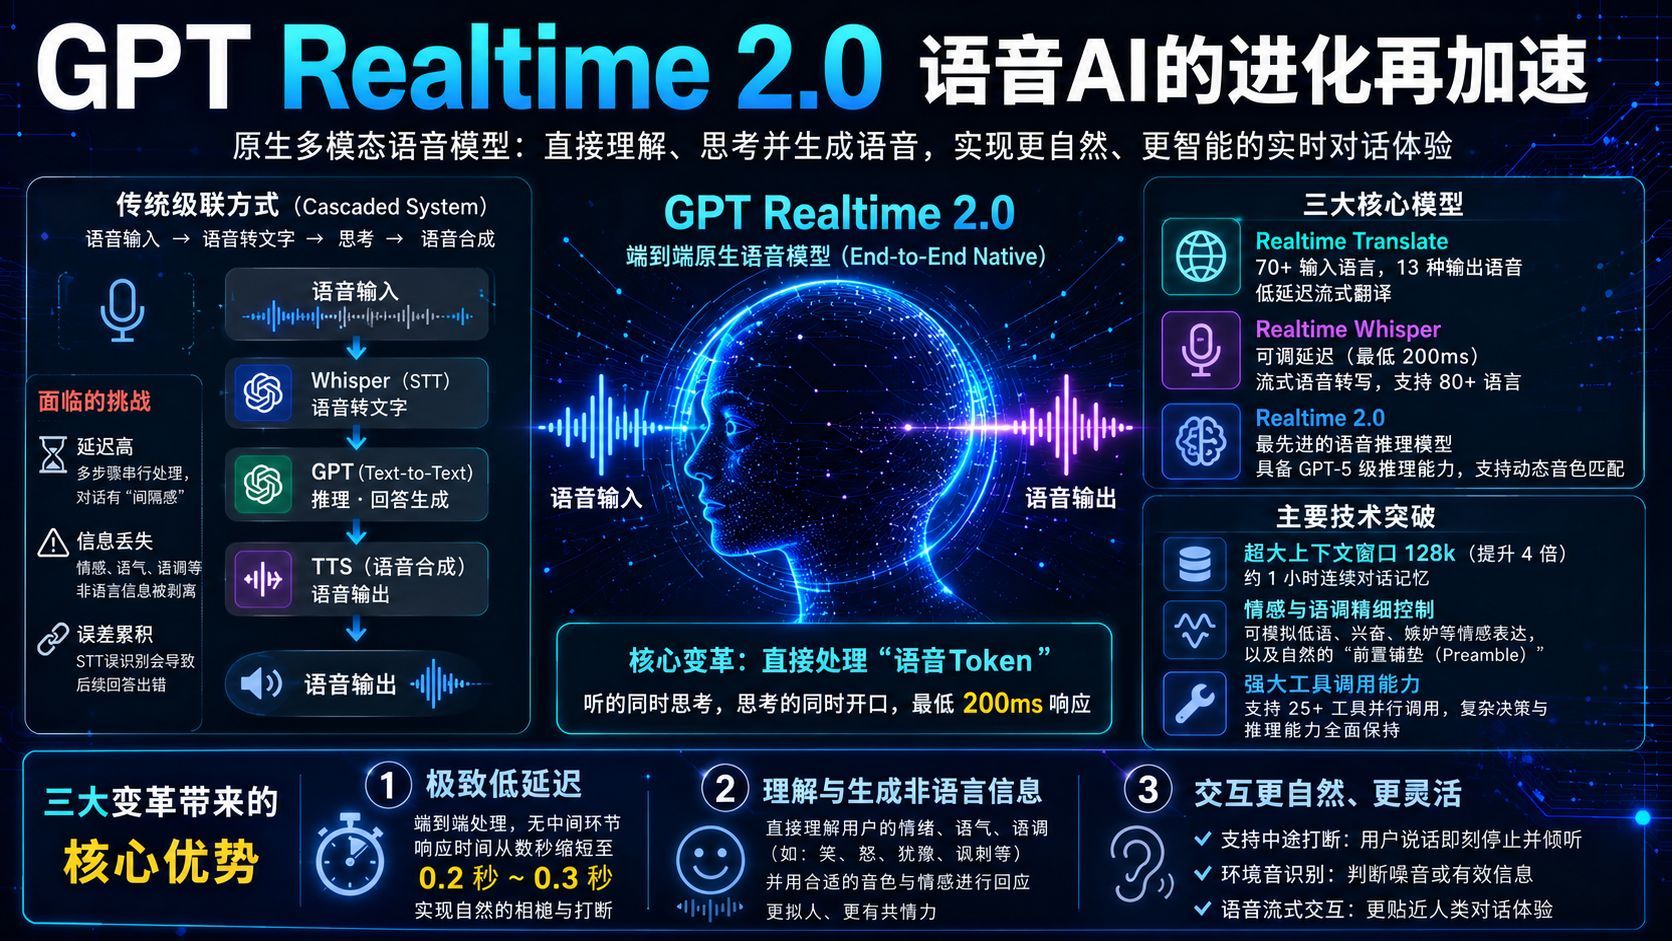
- 三大核心模型:
- Realtime Translate:支持 70 多种输入语言和 13 种输出语言的低延迟流式翻译。
- Realtime Whisper:延迟时间可调(最短可达 200ms)的流式语音转文字,支持 80 多种语言。
- Realtime 2.0:最先进的语音推理模型。将 GPT-5 级别的推理能力引入语音领域,并支持动态音色匹配。
- 主要技术提升:
- 上下文窗口:扩大至 128k,为以往的 4 倍。可支持约 1 小时的连续对话。
- 情感与语气控制:能够表现低语、兴奋、嫉妒等细腻的情感变化,并能模拟人类说话时带有的自然“前置垫字(Preamble)”。
- 工具调用:支持并行调用 25 个以上工具的大规模工具库,并保持能够支撑复杂决策逻辑的推理能力。
B. 演示:语音驱动型智能电商(SupplyCo)
- 背景:模拟一位正在准备徒步旅行的用户,通过语音智能体购买装备的场景。
- 技术亮点:
- 智能体能够查看用户的历史订单(掌握其已购买的袜子或水壶等物品)。
- 实时搜索网络评论(识别出某款特定帐篷关于防水性较差的差评)。
- 调用外部天气 API,根据目的地的降水预报提供针对性的合理建议。
- 结论:语音智能体不再局限于单纯的“聊天”,而是可以直接操作 UI 并执行复杂的筛选逻辑。
C. 演示:产品分析仪表盘(Metric Loop)
- 背景:产品经理通过语音操作动态仪表盘,分析欧洲地区活跃率下降原因的场景。
- 技术亮点:
- 语音到行动:根据语音指令自动执行仪表盘的筛选过滤操作。
- 根本原因分析:智能体自动调查会话重放(Session Replays)和客户支持工单,精准定位出移动端 Safari 特定版本中尺寸选择功能的 Bug。
- 唤醒词与静音逻辑:展示了在被要求保持安静时的高度自主性,以及对环境噪音的极强抗干扰能力。
D. 企业实践案例 Sierra Team
- 痛点:在财富 100 强企业中,即使是 0.1% 的错误率也可能引发重大的商业风险。
- 解决方案:
- Agent Harness:在模型外层构建基础设施,用以管理工作流编排、工具限制、品牌一致性以及个人身份信息(PII)的匿名化。
- VAD(语音活动检测)微调:即便在嘈杂环境下(如高速公路或有孩子吵闹的车内),也能准确判定用户是否结束发言。
- 状态恢复(State Recovery):具备应对通话中断的能力,支持跨会话保持上下文。
4. 核心决议 Key Decisions
- 模型定位:从传统的“语音→文本→语音”级联式架构,转向原生的“语音到语音(Voice-to-Voice)”端到端架构,彻底消除了延迟与信息损耗。
- 应用方向:重心不再是简单的语音聊天,而是重点推进“Voice-to-Action(语音驱动执行)”。
- 开放性:即刻面向开发者公开 GPT Realtime 2.0 的 API、SDK 以及 Playground。
5. 行动项 Action Items
| 具体任务 | 负责人 | 备注 |
|---|---|---|
| 查阅技术文档与代码示例 | 全体开发者 | 参考 OpenAI 官方 Build Hour 仓库 |
| 验证新版 VAD 参数 | 语音应用开发者 | 在各类硬件(麦克风/PC)上测试检测精度 |
| 参加下一期 Build Hour | 注册用户 | 主题:Agents SDK(将于5月28日举行) |
| 整合 128k 上下文策略 | 现有客户 | 优化长时间通话中的信息召回精度 |
6. 潜在风险与行业洞察 Risks & Insights
- 打断处理(Interruptions):语音交互中的最大难点。OpenAI 现已提供特定时间段的禁止打断逻辑(例如在朗读法律免责声明时)。
- 推理与速度的权衡:尽管 Realtime 2.0 速度极快,但在极端复杂的场景下,建议启用“异步监督模式”,由后台性能更强的文本模型(如 GPT-4o)来监控对话质量。
- 全球趋势:在巴西、印度等移动端优先的国家,大众对语音交互的接受度高于文本,蕴含着巨大的增长机会。
- 模型幻觉:在拼写姓名、电话号码等需要绝对精确度的任务中,依然存在错误风险。建议结合 UI 确认机制或加入严格的结构化推理限制。
GPT Realtime 2.0:架构变革及其深远意义
GPT Realtime 2.0 是一款原生的多模态模型,它不再采用“把语音转化为文本后再思考”的传统逻辑,而是实现了“直接用语音理解、用语音思考、用语音输出”。
1. 架构对比
传统方式 Cascaded System
将多个模型像串糖葫芦一样级联(Pipeline)在一起的方式。
- 处理流程:语音输入 → Whisper (STT) → GPT (Text-to-Text) → TTS (语音合成)
- 痛点:
- 高延迟:必须等待每个步骤依次完成后才能进入下一步,导致对话中出现明显的“空白停顿”。
- 信息缺失:在转化为文本的过程中,说话人的“情绪”、“反讽”、“重音”、“声音颤抖”等非语言信息会被全部过滤掉。
- 错误链式反应:如果第一步的语音转文字(STT)出现错别字,后面 GPT 产生的回答也会随之跑偏。
GPT Realtime 2.0 End-to-End Native
由单个模型直接处理语音口令(Tokens)的方式。
- 处理流程:语音输入 → GPT Realtime 2.0 → 语音输出
- 变革核心:
- 语音 Token:模型不仅能处理文本(文字),还能将声音的波形和特征直接作为“Token”进行处理。
- 同步并行处理:支持边听边想、边想边说,从而实现了与人类无异的 200ms 响应速度。
2. 这场变革带来的 3 大红利
① 极致的低延迟 Latency
由于砍掉了中间生成(文本化)的环节,以往传统方式需要消耗数秒的响应,如今被缩减至 0.2秒~0.3秒。这使得自然的“随声附和”和“中途打断”成为现实。
② 非语言信息的理解与生成 Prosody & Emotion
- 理解:能直接分辨出用户是在笑、在生气,还是在犹豫(通过句尾的语气词和语调)。
- 表达:模型自身也能自由切换“低语”、“兴奋语气”、“沉稳语气”等,实现更具人情味的沟通。
③ 极高的人机交互灵活性
得益于对语音的直接处理,以下高级控制变得轻而易举:
- 打断响应:在用户开口说话的瞬间,模型会立即闭嘴,并开始聆听新的指令。
- 环境音识别:能够智能判断背景音(如警报声或敲击键盘声)是应该作为噪音忽略,还是作为有效信息纳入考量。
结论
本次更新绝非单纯的“提速”,而是 AI 真正将“耳朵”和“声音”化为了大脑的一部分,是一次根本性的进化。
GPT Realtime 2.0 快速入门指南
GPT Realtime 2.0(Realtime API)通过 WebSocket 协议,在设备与 OpenAI 服务器之间实现了低延迟的双向流式传输。
步骤 1:在 OpenAI Playground 中免代码体验
在动手写代码之前,您可以先在浏览器中直观感受模型的性能(响应速度与音质)。
- 登录 OpenAI Dashboard。
- 点击左侧菜单中的 “Playground”。
- 将模式切换为 “Realtime”。
- 允许浏览器使用麦克风,并在右侧设置中选择模型(如
gpt-4o-realtime-preview)和音色(如 Alloy, Echo, Shimmer 等)。 - 点击 “Connect” 即可开始对话。
步骤 2:准备开发环境
若要正式构建应用程序,您需要准备 API 密钥以及特定的依赖库。
必备条件
- OpenAI API Key:前往 API Keys 创建。
- Tier 1 或更高等级的充值记录:Realtime API 目前仅对有付费历史的账户开放。
- Node.js 或 Python 环境:官方已提供相应 SDK。
步骤 3:官方参考与示例代码
配合本次 Build Hour,OpenAI 发布了极具参考价值的代码仓库:
- openai-realtime-console:
- 基于 React 开发的全功能演示 App。
- 包含了语音可视化(波形)、工具调用(Function Calling)以及日志查看等完整实现方案。
- openai-realtime-api-dotnet / python / node:
- 各语言版本的最新 SDK。
步骤 4:核心核心概念理解
Realtime API 弃用了传统的 fetch (HTTP) 请求,而是采用 WebSocket。其核心开发围绕以下 3 种“事件(Events)”展开:
- Session Update:
- 用于配置智能体的人设、可调用的工具(函数)、声音类型以及是否允许用户打断。
- Item Create / Response Create:
- 负责发送用户的语音或文本输入,并向模型请求回复。
- Server Events:
- 客户端接收服务器传回的
response.audio.delta(音频切片)并在本地进行播放。
步骤 5:推荐学习路径
- 优先在本地运行官方 Console:
只需 git clone 并在本地 npm start,即可搭建出类似于发布会上演示的“语音驱动仪表盘”环境。
- 尝试工具调用 (Function Calling):
测试当您说出“帮我查查今天的天气”时,系统如何正确触发您在本地定义的函数。
- 微调 VAD (智能静音检测):
根据应用场景选择“自动检测用户何时说完”,还是采用手动的“按住发言(Push-to-Talk)”模式。
⚠️ 注意事项
- 成本管理:语音 Token 的单价高于文本 Token,建议在开发调试阶段尽量使用简短的对话进行测试。
- 安全合规:切勿将 API Key 直接明文写在前端浏览器代码中,否则会有被盗刷的风险。生产环境中请务必通过后端中转或使用临时令牌(Ephemeral Tokens)。