
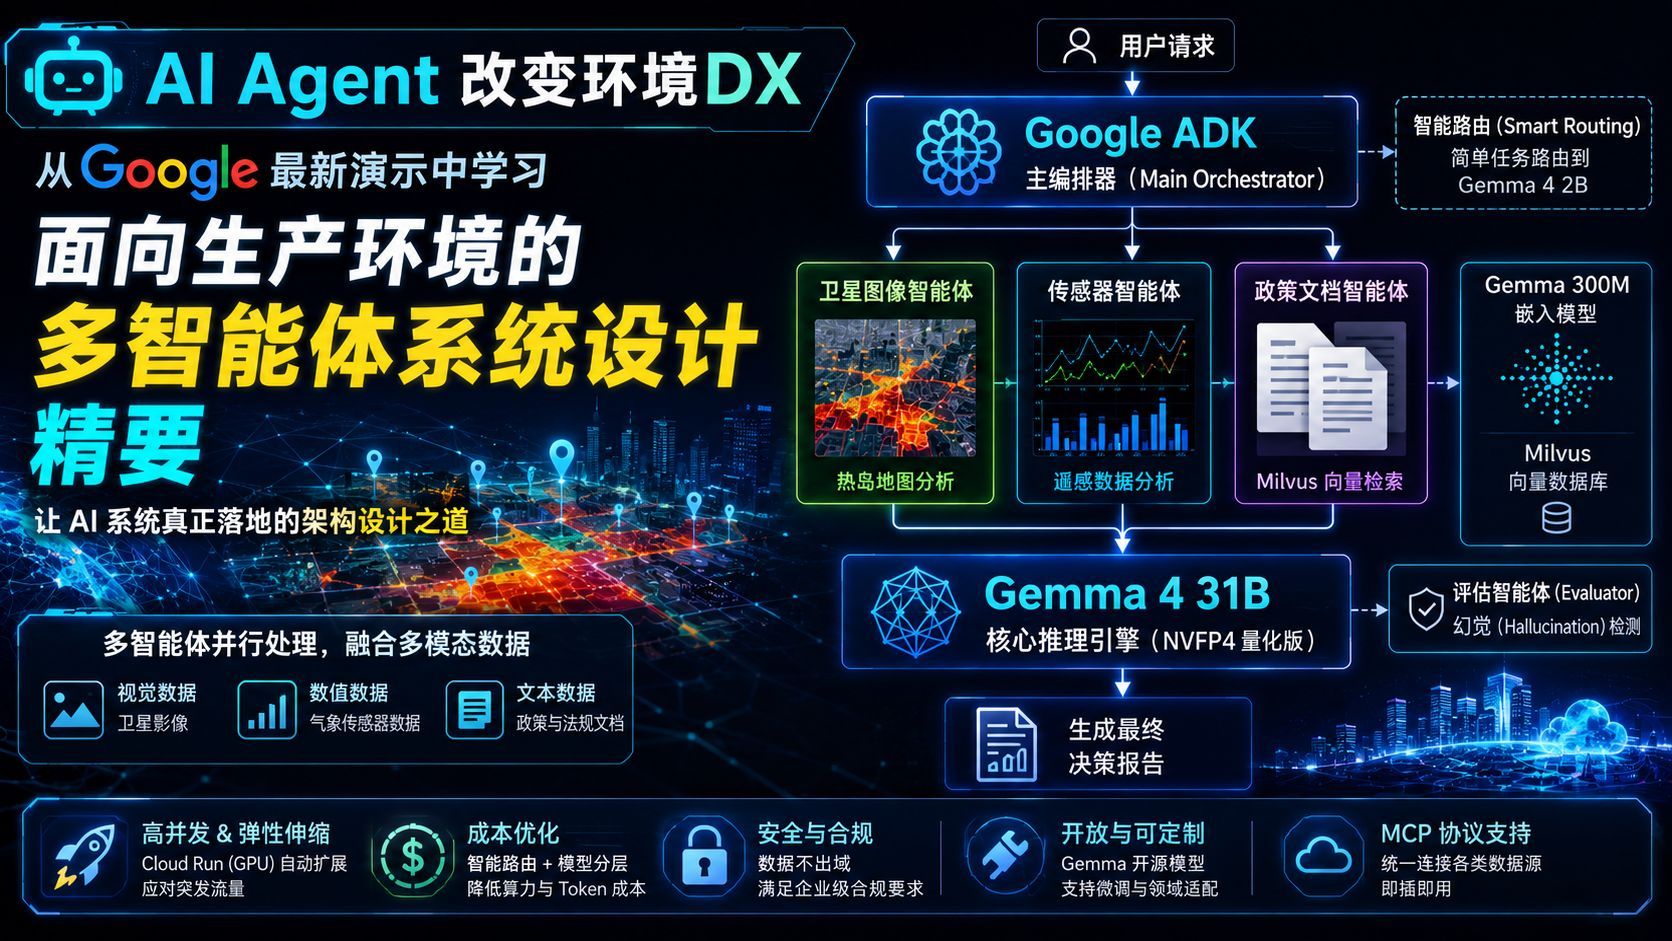
🤖 当 AI Agent 卷入环境 DX:从 Google 最新技术演示,看生产级多智能体系统的落地美学
讲解超越单聊天机器人范畴、能够解决现实复杂业务问题的先进 AI Agent 系统。以 Google 最新技术演示为案例,深入探索多 Agent 之间的协同工作流、开放模型 (Gemma 4) 的最佳利用,以及企业级不可或缺的 Cloud Run 和 ADK 构建的坚固系统设计的秘诀。

“AI Agent(智能体)”这个词,最近两年估计大家听得耳朵都要起茧子了。手快的朋友可能早就用 LangChain 或 LlamaIndex 写过几个 “Hello World” 级别的聊天机器人了。
但在面对现实世界里那些复杂、多维且充满脏数据的商业场景时,单靠一个“全能”的 Prompt,真的能撑起本番环境(生产环境)的并发、延迟和成本控制吗?
最近看了 Google 团队的一段最新技术分享视频(视频链接),里面展示了一个非常有意思的案例——“可持续性智能应用”(Sustainability Intelligence App)。这个应用旨在协助政府或企业的决策者,在面对极端气候(比如凤凰城的城市热岛效应)时,能瞬间拿到一份具备可执行性的风险缓解策略报告。
看完之后,我整个人被点亮了。这绝对不是一个简单的“AI 帮写报告”的温情故事,而是一场关于 Multi-agent(多智能体系统)、开源大模型 Gemma 4、以及 Google ADK 如何在云端优雅协奏的系统架构设计盛宴。
作为一名资深架构师,我连夜把我的理解与硬核思考整理了出来。今天不聊虚无缥缈的 AI 威胁论,我们来聊点干货:本番环境下的 Agent 系统该如何优雅落地。
🌎 过去的痛:不用 AI,环境分析师的日常就是“人间地狱”
在聊新架构之前,我们先把时钟拨回“传统做法”。
假设凤凰城政府现在要求评估极端高温风险并制定应对政策。这项任务需要处理三种完全不同维度的多模态(Multimodality)数据:
- 视觉数据: 城市热岛风险的卫星图像。
- 数值数据: 气象站密密麻麻的实时传感器遥感数据。
- 文本数据: 各县市厚重、枯燥的政策法规文件。
在没有 AI 的“石器时代”,这个流程简直是分析师的噩梦:
- 分析师 A 每天坐在电脑前用肉眼死盯着卫星图片,手动标注热岛区域;
- 分析师 B 在 Excel 里疯狂拉公式,拼命清洗气象传感器的遥感数据;
- 最惨的是分析师 C。由于各地方政府根本没有现代化 API,他必须像个网络侦探一样,定期去刷各机关官网,看看政策 PDF 更新了没有。每个月手动下载一次,人工审查、肉眼阅读几百页的文件……
最后,大家再开个马拉松式的会议,把所有信息手工拼凑成一份报告。这种做法不仅延迟(Latency)高到天际,而且只要中间有人手抖抄错个数据,整份报告的准确性就直接崩盘。
🚀 现代架构的救赎:Multi-agent + Gemma 4 的并奏交响乐
视频中展示的现代解法,彻底把这个高度依赖人工的泥潭,转变成了异步的自动化流水线操作。
先看这张我为大伙儿梳理的系统协同工作流:
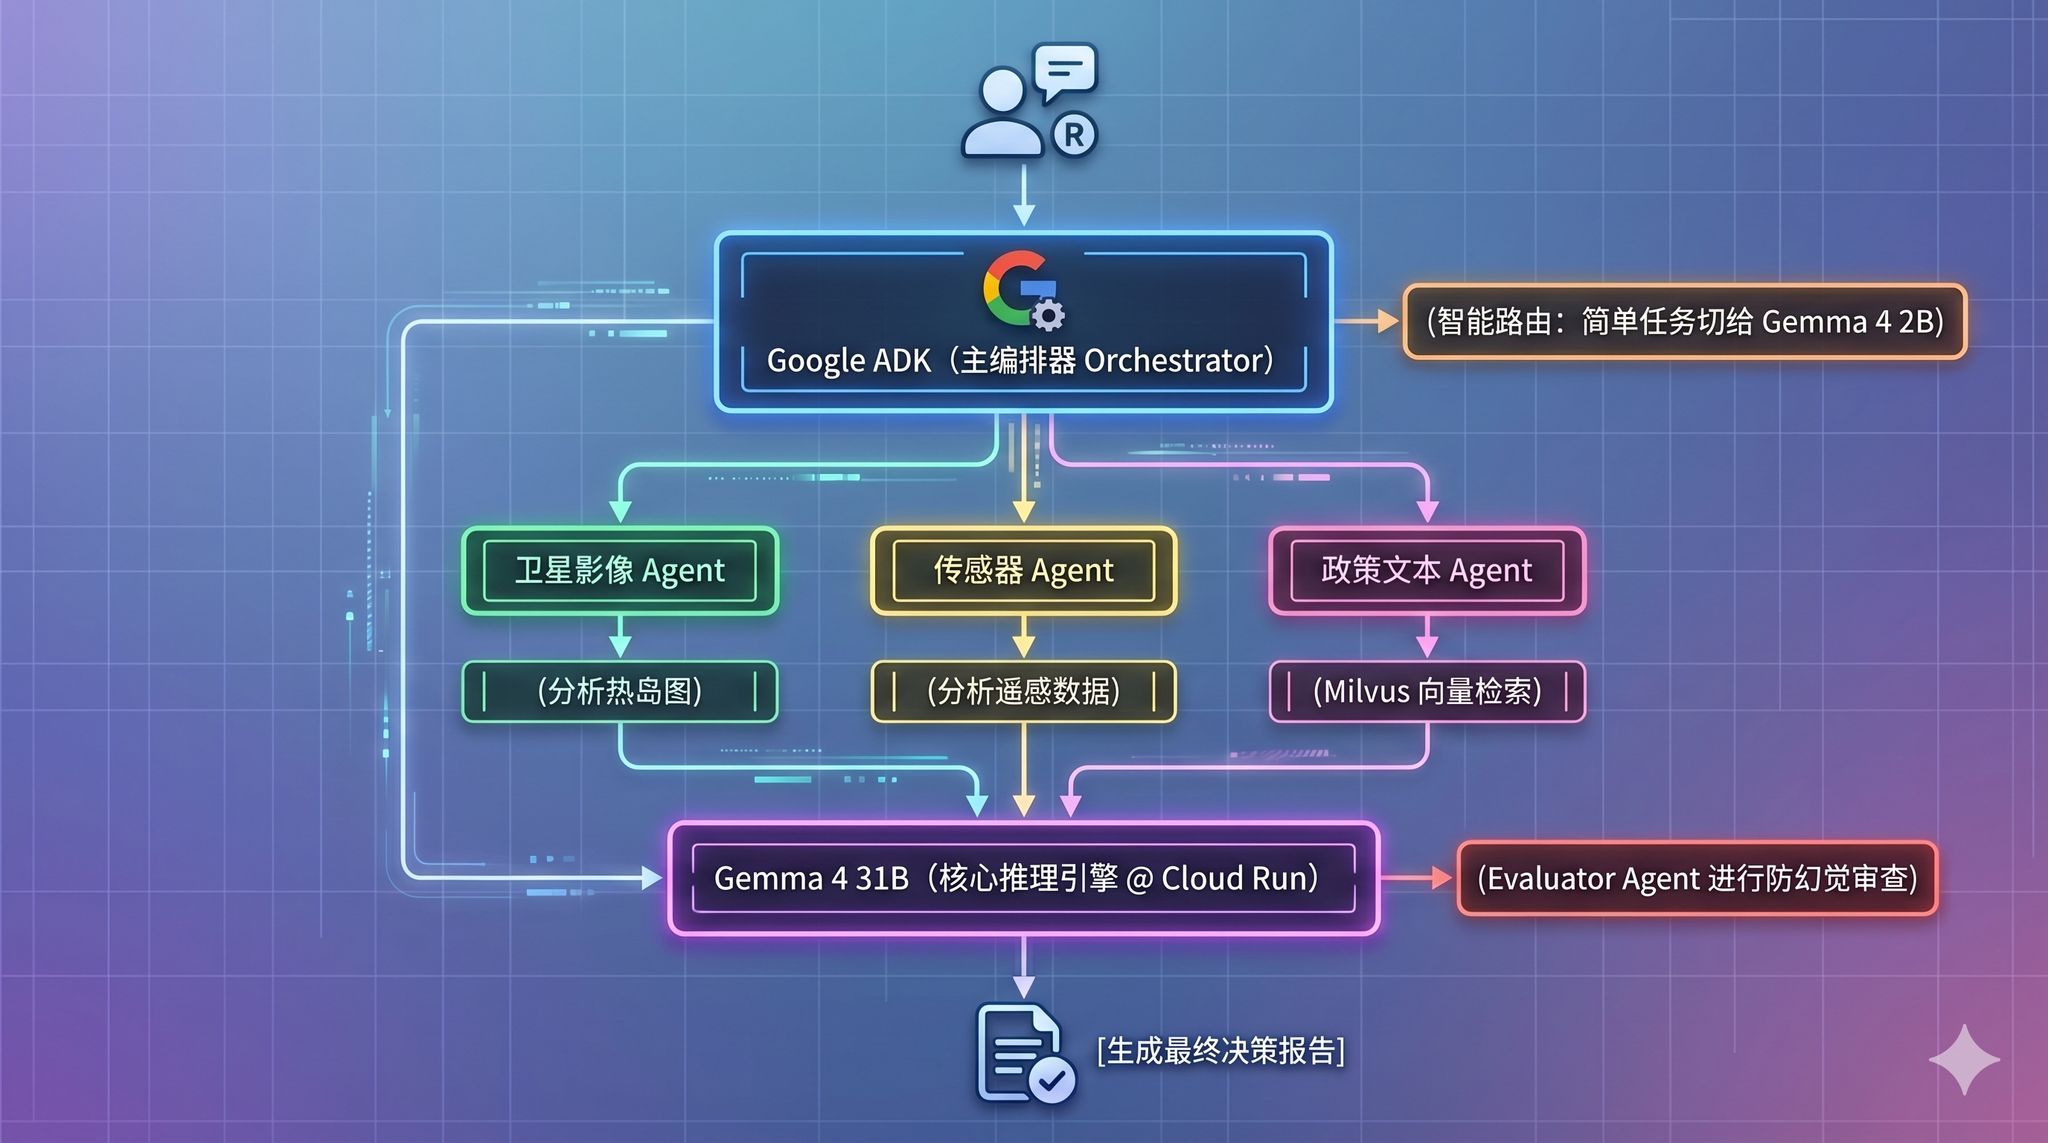
在这个架构中,不同领域的分析工作被并发分配给了不同的“子智能体”(Sub-agents)。而整个系统的核心大脑,正是 Google 最新开源的 Gemma 4!
有意思的是,Gemma 4 在这里并不是“一个人打全场”,而是化身为好几种不同的形态,各司其职,完美配合:
1. 核心推理引擎:Gemma 4 31B NVFP4 量化版
当各个子智能体把数据搜集上来后,主编排器会调用 Gemma 4 31B(310亿参数)模型。多亏了它强悍的多模态处理能力,它能同时“吸收”并理解卫星图像、气候数值与政策文本,进行深度综合推理。视频中特别提到,该模型使用了 NVFP4 格式进行量化压缩,不仅大幅缩小了体积,还能直接在云端高性能输出,简直是性价比魔鬼。
2. 文书处理大师:Gemma 300M Embedding
面对那堆厚重的政策 PDF,如果直接一股脑塞给大模型,Token 费用绝对会让你当场破产。系统在准备阶段使用了专门的 Gemma 300M(3亿参数)嵌入模型。它的工作很单纯:把海量的文本转化为“向量嵌入(Vector Embeddings)”,然后存入 GPU 加速的 Milvus 向量数据库。需要时,子智能体一秒就能精准捞出对应的政策法条。
3. 守门员与省钱专家:Gemma 4 2B
大模型虽好,但天天用它来处理“请帮我把这行字去空格”这种低能任务,简直是用大炮打蚊子。这时候,体积小、内存占用极低的 Gemma 4 2B(20亿参数)小模型 就登场了!它被用作智能路由(Smart Routing),专门处理轻量级文本或判断任务流向,帮企业省下大把的 GPU 算力成本。
🛠️ 谁来指挥这支乐队?Google ADK 的总指挥美学
有了这么多 Agent 和不同版本的 Gemma 4,谁来负责调度和编排?答案是 Google ADK (Agent Development Kit)。
在整个架构中,Google ADK 扮演的是 主编排器(Main Orchestrator) 的角色。如果没有它,我们程序员得自己苦哈哈地去写底层底层代码来管理并发、处理异常、串接数据库。而 ADK 直接提供了一个高度封装的“抽象层”,它的核心价值表现在:
- 任务拆解与最终集结: 把总任务拆给视觉、遥感、文本三个子智能体,等他们各自完工后,再完美地把反馈结果重组起来。
- 万能插座(MCP 协议的完美搭档): 整个系统引入了 MCP(Model Context Protocol,模型上下文协议)。这东西被誉为 AI 界通往外部世界的“通用 USB-C 接口”。有了 MCP,Agent 不需要为每个外部数据库单独写 API 代码;而 ADK 让开发者能轻易把这些标准化的 MCP 接口编排进系统中,实现即插即用。
- 落实“智能路由”: 在生产环境中,ADK 可以动态判断:这个传入的问题需要开启复杂的推理(Reasoning)功能吗?如果不开启,直接关闭推理,或者转发给 Gemma 4 2B。省 Token 就是省预算,ADK 在这一点上卡得死死的。
🤔 灵魂拷问:既然有了 Gemini API,为什么还要大费周章在 Cloud Run 部署开源的 Gemma 4?
这是我看完视频后思考最久的问题。直接对接 Google Gemini Enterprise API 不是最省事吗?干嘛还要自己在 Google Cloud Run 上托管一个开源的 Gemma 4 呢?运行 Cloud Run 也是要按需付钱的呀!
技术人的冷静分析: API 很香,但当应用走向“生产环境(Production)”时,企业算的是另一笔账。在 Cloud Run 上部署开源模型,拥有四大闭源 API 无法替代的护城河:
🧱 1. 深度定制与参数微调(Fine-tuning)的自由
通用大模型虽然什么都懂一点,但它不懂你们公司的内部黑话、内部备忘录或特定行业的潜规则。因为 Gemma 4 是开源的,你可以使用 PEFT(参数高效微调)或 LoRA 技术,在普通硬件上用私有数据集对它进行“特训”。
- *举个例子:* 金融公司可以用 SEC(美国证券交易委员会)的文件来微调 Gemma,让它秒变金融合规专家;游戏开发者甚至能微调它,让 NPC 具备傲娇或腹黑的说话风格。这种深度定制,是直接调用闭源 API 无法触及的。
💰 2. 精确匹配计算资源(Rightsizing Compute)
多智能体系统并发起来的请求量是非常恐怖的。如果无论请求大小都往庞大的通用大模型丢,Token 的账单能让你们 CFO 血压高到脑溢血。 而在 Cloud Run 上,你可以“精确配置你需要的算力”。简单的路由和分类交给量化版的 Gemma 2B,复杂的推理再交给 31B。只为实际消耗的资源买单,这才是精细化运营的王道。
🌊 3. 应对突发流量的极致弹性(Elasticity & Latency)
生产环境的流量就像海浪,平峰时风平浪静,一旦有大规模后台任务触发,流量会瞬间暴涨(即突发性流量)。Cloud Run 作为 Serverless(无服务器)计算平台,它的弹性扩展能力极强。 流量爆发现时,它能瞬间拉起多个带有 NVIDIA GPU(如 G4 实例) 的计算实例,满足严格的延迟服务级别目标(Latency SLOs);没人用的时候,它会自动缩容到接近零,绝不让你花冤枉钱。而且,G4 实例支持 NVIDIA Blackwell 架构的 P2P 直连技术,绕过 CPU 直接让多个 GPU 通信,延迟低到让人感动。
🔒 4. 把智能体视为“不可信”工作负载的安全自觉
视频特别强调了一句话,深深触动了我:“企业必须将智能体的工作负载视为‘不可信的’(Untrusted)。” 因为 Agent 具备自主推理和长周期执行的能力,一旦失控或遭受恶意的 Prompt 注入攻击,后果不堪设想。 在 Cloud Run 的容器隔离环境下,你可以把定制的模型权重死死锁在自己的 Cloud Storage 里,全程走 VPC(虚拟私有云) 内部网络传输。这赋予了架构师极高的权限去实施安全护栏(Guardrails)、进行深度调试(Debug)与审计控制(Auditability),完全符合企业最高级别的安全与合规要求。
🛡️ 架构师的彩蛋:防幻觉的“双雄博弈”设计
最后分享一个视频中非常高级的架构亮点:评估智能体(Evaluator Agent)。
多智能体系统最怕什么?最怕两个 Agent 之间玩“传话筒”游戏,互相传递幻觉(错误信息),或者大模型陷入无限思考循环,疯狂烧你的 Token。
为了解决这个痛点,设计师在“生成智能体”旁边,并列放置了一个“评估智能体”。这两个 Agent 就像是在玩一场博弈游戏:生成智能体给出答案,评估智能体负责挑刺、检查错误并修正 Prompt 塞回去。只有通过了评估智能体的无情审查,结果才会最终输出给用户。这种自我修正机制,优雅地打破了死循环,把幻觉(Hallucination)压制到了最低。
💡 总结
从“纯手工去官网下载 PDF 还要用肉眼看”到“Multi-agent 瞬间多模态并发生成决策报告”,技术带来的变革是震撼的。但作为工程人员,更让我兴奋的,是看到 Google ADK(编排)+ Gemma 4(大脑)+ Cloud Run(弹性基础设施) 这样一套成熟、解耦且兼顾成本与安全的黄金三角架构。
它告诉我们,未来的 AI 应用开发,不再只是比拼谁的 Prompt 写得漂亮,而是考验架构师如何将模型视为一种全新的计算资源,并在基础设施层进行精准的调度、算力匹配与安全隔离。
这场 AI Agent 的本番环境落地之战,才刚刚开始。你准备好重构你的系统了吗?欢迎在Facebook里跟我一起探讨!