
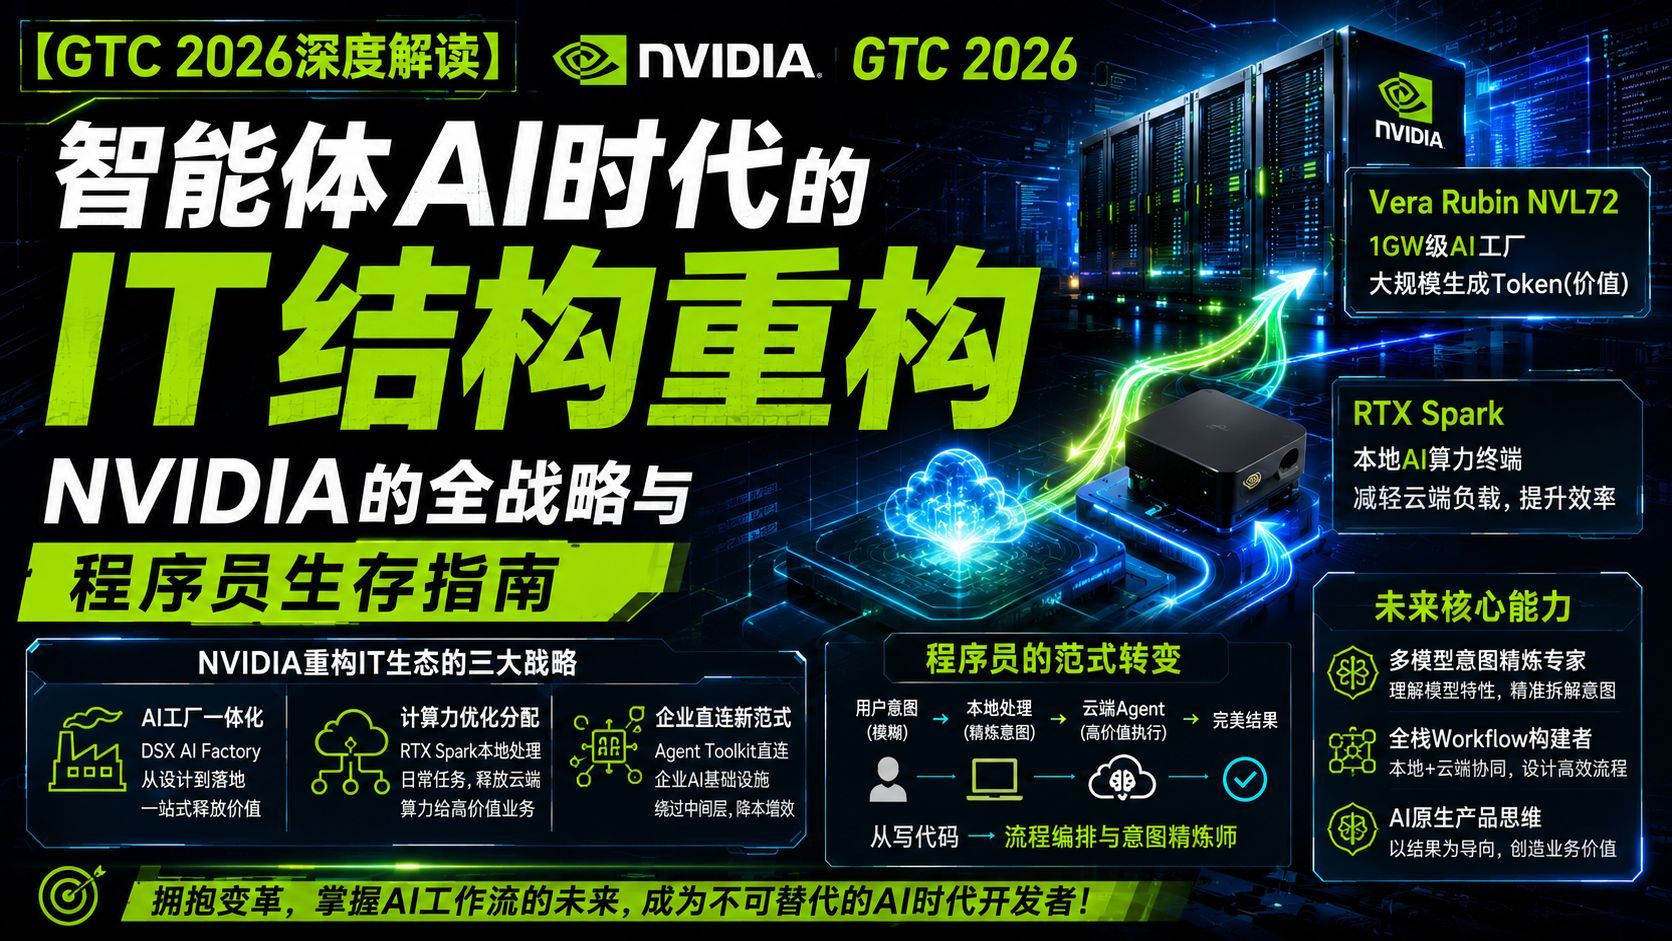
【GTC 2026深度解析】智能体AI时代的IT架构重组:NVIDIA(英伟达)的全方位战略与程序员生存指南
本文将深入剖析 NVIDIA GTC 2026 主旨演讲的核心内容,解读 AI 的演进如何从单纯的“对话”跨越到“自主行动(智能体/Agent)”的崭新阶段。文章将从工程师的专业视角,详细阐述硬件(Vera CPU、RTX Spark)如何被重新定义,以及传统的以云为中心的 IT 架构如何在本地边缘处理与 NVIDIA 独家生态的推动下发生重组。此外,本文还将全面涵盖未来开发者必备的工作流开发能力以及底层架构知识。

首先【NVIDIA GTC 2026】发布内容概述
英伟达(NVIDIA)CEO黄仁勋在 GTC Taipei 2026 的主题演讲中高调宣布:AI 已经超越了聊天机器人的范畴,“Agentic AI(代理式AI / 智能体AI)”的时代已正式全面到来。
本文并非简单的热点新闻罗列,而是将从工程师的视角,为您深度剖析其背后的技术脉络与故事:“为什么此时此刻,NVIDIA 要全线押注智能体 AI? ”以及“为此,他们又是如何重新定义硬件(Vera CPU 与 Vera Rubin)的?”。
1. 现有 AI 的痛点是什么?——“实用 AI”的爆发
过去几年的生成式 AI 狂潮确实带来了一场革命,但其交互模式仍局限于“人类输入提示词,AI 输出文本”的单次互动。然而,黄仁勋表示:“随着 Agentic AI 的到来,真正‘实用的 AI(Useful AI)’已经触手可及。”
智能体(Agent)绝非单纯的大语言模型(LLM),而是一个由以下组件构成的“全新计算模型”:
- 模型(大脑): 负责推理并制定计划。
- 安全套件/控制台(身体与系统): 管理短期记忆(工作内存)与长期记忆,并对整体流程进行编排。
- 工具与技能(道具): 能够自主操作电子表格、浏览器、数据库,乃至 NVIDIA 的 CUDA-X 库等。
“所谓‘AI 将夺走人类工作’的言论完全是无稽之谈。恰恰相反,AI 正在为企业雇佣更多软件工程师创造理由。”
令人惊叹的是,GitHub 上的开发者提交量(Commits)已从 2023 年的 3 亿次,暴涨至 2026 年初的近 3 倍。全球领着总计约 3 万亿美元薪酬的开发者们,在智能体 AI 的赋能下,竟然创造出了高达 9 万亿美元的生产力价值。
在工程师看来,这不仅意味着“编码的自动化”,更意味着我们正在步入一个连“系统的自动构建与验证”都由 AI 承包的全新时代。事实上,NVIDIA 已经与 Cadence 展开合作,构建了一款超级智能体,将芯片设计中的 RTL(寄存器传输级)验证周期从“数周缩短至数小时”。
2. 智能体都是“急性子”—— Vera CPU 诞生背后的逻辑
你可能会问:“智能体 AI 确实厉害,但硬件层面有什么变化吗?”这正是 NVIDIA 的绝活所在。
传统的 CPU 是“为人类”而设计的。人类生活在“秒”级世界中,因此云端采用划分线程和核心并按时出租的方式最高效。然而,AI 智能体却非常“缺乏耐心(Impatient)”。
当智能体调用工具或访问数据库时,纳秒级的延迟都会成为瓶颈。为此,NVIDIA 从零开始,专为智能体量身打造了“Vera CPU”。
💡 技术视角:Vera CPU 的“燃点”在哪里?
- 单线程性能推向极致: 为了不仅实现高吞吐量,更能以爆表的速度处理沉重的 Python 运行时及工具调用,其 IPC(每时钟周期指令数)被直接拉高到了“10”。
- 惊人的内存带宽: 采用 LPDDR5X,使峰值内存延迟相比 x86 降低了 40%。此外,消除了由于芯片组边界带来的损耗(Chiplet Tax),通过 3.6 TB/s 的单片网格结构(Monolithic Mesh Fabric)将 88 个 Olympus 核心完美结合。
- 流处理性能怪兽: 在面向纽约证券交易所的实时流处理测试中,其性能达到了现有 CPU 的 6 倍。
智能体 AI 是一种分布式计算模型。推理在 GPU(Vera Rubin)上完成,而工具调用和内存管理(KV 缓存)则由 CPU 负责,因此 CPU 与 GPU 之间需要极强的协同。Vera CPU 正是为了粉碎这个“智能体瓶颈”而诞生的西装怪兽。
3. RTX Spark —— 时隔 40 年的“个人电脑再发明”
在本次发布会中,最让我个人感到兴奋的其实是客户端(边缘端)的进化。
黄仁勋宣布:“微软与 NVIDIA 彻底重新发明了 PC。”而这一载体,正是搭载了全新芯片 “RTX Spark” 的次世代 PC。
- 配置参数: 这款与联发科(MediaTek)联合开发的定制芯片(N1X)内置了 6144 个 CUDA 核心、20 核 Grace CPU 以及 128GB 统一内存。其 AI 算力达到了恐怖的 “1 PFLOPS”。
- 本地智能体常驻: 用户无需再担心云端按量计费带来的“流量焦虑”,智能体可以 24 小时全天候在本地高效运转。
🛠️ 这将如何颠覆行业?
如今,我们的日常离不开打开应用、点击和打字。但在 RTX Spark 环境下,智能体将常驻于名为“Open Shell”的安全沙盒中,它可以代替你直接操作本地的 CAD 软件(如 Rhino)来设计房屋,甚至自动调用 Blender 完成渲染。
未来的 PC 将不再仅仅是一个工具,而是转变为“放置在机箱里的 R2-D2 或 C-3PO 般的个人 AI 助手”。
4. 开源模型与“物理 AI”的最前沿
对于软件工程师和机器人工程师来说,开源生态的强化同样不容错过。
- Neotron 3 Ultra: 这是一款采用了结合 SSM(状态空间模型)与 MoE(混合专家模型)混合架构的全新开源模型。得益于此,它比同类模型快 5 倍,且成本降低了 30%。更慷慨的是,NVIDIA 不仅开源了模型,连训练脚本和数据集也一并公开。
- Cosmos 3: 这是一个不仅能理解语言,还能理解“物理定律”的世界基座模型(World Foundation Model)。它不仅能生成视频和图像,更成为了机器人规划动作、进行模拟仿真的“物理 AI”基石。
- NVIDIA Isaac Groot: 这是一个面向人形机器人的开源参考平台。黄仁勋幽默地调侃道:“它身高 6 英尺,体重 150 磅,和我差不多(虽然前一个数字比我小,后一个数字比我大)。”这一充满趣味的机器人平台,将成为今后机器人研究的重要基石。
我的过度解读:英伟达 GTC 2026,不谈理想,只教你如何用“Agent化”掀翻旧 IT 秩序!
写在前面: *以下内容包含大量个人“过分解读”与野生技术解构。请注意甄别!!!*
*在视频种,黄老板在台上温文尔雅地感谢台湾供应链、高歌数学之美,但剥开那层科技大厂的温情面纱,我看到的却是一场不讲政治正确、不画虚无大饼,直击 IT 产业底层利益分赃与技术范式转移的盛宴。也令我更加地看清未来的路。*
2026 年的台北 GTC,在 10% 的台湾 GDP 预期增长率和满场的欢呼声中,拉开了一场史诗级的帷幕。
很多人还在看热闹,惊叹于 3nm 工艺、HBM4 内存、亦或是万亿级参数的超级计算机。但如果你仔细复盘整场演讲,就会发现黄老板这次带给全世界的讯息其实粗暴、直接、且极其真诚。
翻译成大白话就是:别扯那些弯弯绕绕的,我们的口号只有两个字——搞钱(Make Money)!搞钱(Make Money)!还是 TMD 搞钱(Make Money)!
为了带领全人类(尤其是买了英伟达显卡的金主爸爸们)一起合理合法、极其暴利地搞钱,我感受到在本次 Keynote 里,雷厉风行地干了三件惊天动地的大事。
一、 Vera Rubin 彻底量产:给顶级土豪量身定制的“数字印钞机”
那些手握重金、根本不懂什么叫深度学习,但有的是钱的企业家、Old Money 们,我感受到黄老板这次直接给你们把路铺平了。
别再去研究什么变压器(Transformer)、状态空间模型(SSM)了,听黄老板一句话:直接投钱,砸他那一整套 NVIDIA DSX AI Factory 方案!
NVIDIA DSX 蓝图 ──> Omniverse 数字化工厂模拟 ──> 物理工厂一键落地 ──> 狂吐 Token(金币)
黄老板在现场给你们算了一笔账:算力就是营收,功耗就是利润!
在 1GW 的电力极限下,你用便宜却低效的芯片就是犯罪。英伟达帮你把芯片(Vera Rubin NVL72)、机架、散热、供电、网络(CPO 光电共封装)全部打包成一架严丝合缝的机器。你只要把钱投进来,插上电,它就开始疯狂生产“Token”。
每一个 Token 在 2026 年的 Agent 时代都是可以直接变现的生产力。黄老板的人品和英伟达的垄断级生态就是最大的信用背书。
“买得越多,省得越多;投得越狠,赚得越爽!” 这不是传销,这是实打实的物理限制和工程极限带来的超额利润。
二、 掀翻桌子!黄老板要重整整个 IT 运作方式了
如果说第一点是给财阀们的财富大棒,那第二点,我感觉就是黄老板对整个 IT 生态的“清算”与“重建”。
2.1 净化端侧:别用我的核反应堆去查家谱和听笑话!
同样作为技术者,看最近民众访谈对AI的看法时,我的感受是“一群顶尖工程师,费尽千辛万苦、燃烧了成千上万吨煤炭和硅晶圆,制造出这么牛逼的 Vera Rubin 算力工厂,可不是为了让你们这帮一般民众在网页端问那些无聊的问题的!”
- “帮我查一下我的姓氏在历史上有什么名人?”
- “给我讲个谐音梗笑话?”
- “写一篇小作文,帮我把我爹送进警察局,然后让他既丢人又丢工作?”
这简直是对神圣算力的亵渎!更是对投资人钱包的无情践踏!
之前碍于行业整体的“AI平等”和“用户习惯培养”这种政治正确,大厂们只能打碎了牙往肚里咽,看着大笔大笔买来的高端算力被这些免费的、无意义的查询白白损耗,大企业用户根本赚不到钱。
2026 年,我感觉黄老板不装了,他要彻底切断这种浪费!
NVIDIA联手ARM和微软,整出了一个端侧超级大杀器:NVIDIA RTX Spark!
【NVIDIA RTX Spark】 = 20核 Grace CPU + Blackwell GPU (6144个CUDA核) + 128GB 统一内存 + 微软 Windows 代理式系统底层 + 运行在本地的 Neotron 3 旗舰模型
这是一颗拥有 1 Petaflop AI 算力、700 亿晶体管的怪兽级本地芯片。它的阳谋极其精妙:
- 算力分流(净化云端): 当你买了一台搭载 RTX Spark 的新 PC 时,你将直接在本地无网、无延迟、免流量费地运行相当于 2024 年 GPT 级别的本地大模型。外加内置的 Hermes Agent 和 Open Shell 智能体沙盒。那些无聊的日常闲聊、本地文件检索、修图画图、简单的代码跑跑,全部在你自己的电脑上用你自己的电去解决!把宝贵的“AI Factory(云端算力工厂)”腾出来,专门去跑企业级的高净值金融、医疗、重工业 Agent 业务。
- 重塑开发生态: 终端设备有了如此恐怖的本地算力,IT 开发的玩法彻底变了(我们第三部分细聊)。
- 贴脸开大,怒扇苹果: 这几年苹果靠着 Mac Mini 和 M 系列芯片在轻量级本地AI领域一家独大,极大地损害了英伟达家用级 GPU 的生意。RTX Spark 的诞生,直接联合 Windows 阵营,把苹果在端侧建立的高地一炮轰平!
2.2 斩断“云大厂”的过路费:NVIDIA Agent Toolkit for Enterprise AI
我觉得这个布局,是对传统云计算三巨头(AWS、GCP、Azure)最致命的致命一击。
在以前,一家企业想要开发 AI 服务,路径是这样的:
终端数据 -> 接入 AWS/GCP/Azure 平台 -> 调用云平台的 API -> 路由到后台的 NVIDIA 显卡集群 -> 再原路返回。
这特么不是脱裤子放屁吗?! 凭什么中间商要在英伟达的显卡和用户的终端之间,抽走一大笔“服务器管理与带宽费”?
这次发布会黄老板直接掏出了 NVIDIA Agent Toolkit for Enterprise AI!
【AI时代的直连通道】
RTX Spark(客户端设备)
  ↓
(直连) ←[跳过传统的第三方云数据中转与高额抽成]
  ↓
企业私有化/托管的 NVIDIA AI 算力底座 (DSXOS)
英伟达直接提供能够直达基建底层的 AI 服务开发框架。投钱买英伟达基建的公司,以后根本不需要依赖繁琐、昂贵的传统云厂商管理平台,省掉这笔巨额的“过路费”!让 2.1 提到的本地 RTX Spark 设备直接连上底层的 AI 算力工厂。
这一招大布局,再次用纯粹的技术和生态,保障了投资人的每一分钱都花在刀刃上,最大化地去搞钱!英伟达真特么讲究!
三、 变局已至:未来的 IT 程序员,该怎么活?
在这种宏大的“Agent化”和“算力净化”布局下,传统的 IT 开发模式将面临毁灭性的打击。
3.1 游戏规则的冷酷重构
未来,大公司买下英伟达的基建,构建专属的 “Agent AI 服务”(一种全新的、自闭环的服务形式)。
企业为了保证花大价钱买来的算力不被浪费、不被白嫖,他们将会关闭目前通过简单编程就能直接调用的“API”或“MCP”接口。
取而代之的,是底层代码的绝对隔离。他们会使用类似 VibeCoding 的工具,把底层代码完全锁死在沙盒里,不让非英伟达生态、或非专业的人看到一丝一毫。
企业只暴露一种以“升级版 Skills”或“AI CLI(智能体命令行标准)”存在的抽象交互协议。
3.2 客户端开发者的角色转变:“工作流开发”与“意图精炼师”
客户端程序员的工作,不再是“老老实实写代码去调 API”,你的核心工作变成了:工作流开发(Workflow Development)。
当用户在本地输入一个非常模糊、凌乱的意图时:
你不能直接把这个垃圾意图丢给昂贵的企业级云端 Agent,那是在浪费老板的 Token 钱!
你必须利用本地 RTX Spark 上的 Local Model 和 Harness 框架,在本地进行逐步的引导、纠错、沙盒演练和意图补充。
直到这个意图的信息丰富度和精准度达到了企业级 Agent 服务规定的“调用阈值”,才能触发一次高昂但绝对精准的云端 Agent 调用。
【未来的软件运行逻辑】
  [用户模糊意图输入]
       │
       ▼
  [本地 RTX Spark (Local LLM + Harness)] ── 逐步递进、自动补全、沙盒校验
       │
       ▼ (达到意图情报阈值)
  [云端 NVIDIA Agent Factory] ── 触发高净值、高精准调用,瞬间输出完美结果
四、 别等了,我们该怎么学、怎么准备?
这种玄幻的时代并不是十年后,随着 Vera Rubin 的量产和 RTX Spark 的发布,它就在眼前。作为一个普通开发者,要想不被淘汰,必须迅速切换赛道。
这里极力推荐使用 “XY 轴循序渐进学习法” 来扩充自己的知识面,迎接新挑战。 https://www.vibecodingjapan.com/blog/1779634570095?lang=zh
1. 成为“多模型意图精炼专家”(Y轴:技术深度与模型特性)
不要再一棵树上吊死,只研究 GPT 或某个单一闭源模型。
你要去深入了解各种 LLM 的物理特性,尤其是接下来的本地小模型、混合 SSM(状态空间模型)架构模型的性能边界。
你需要学会设计一套机制:
判断用户意图 -> 分流选择最省钱的本地小模型 -> 通过小模型反向逼问用户、补充上下文 -> 本地校验意图描述 -> 达成调用标准。
设计这种“意图解释增强器”是未来的铁饭碗。
2. 死盯着各种“Harness框架”(X轴:生态广度与系统架构)
“Harness 框架”就是 AI 时代的 Spring Boot,是 AI 时代的 Django。 谁能最快、最准地在本地切换 LLM、调度内存(KV Cache 压缩技术)、调用安全沙盒,谁就是王者。 牛逼的开发者,现在就去研究 Harness Engineering等底层演进,盯着行业里哪家出了新的、高效的 Harness 框架,第一时间跟进、死磕,建立技术壁垒。
3. 培养超越机器的“人类判断力”与“业务解构力”(XY轴形成的面积)
AI 可以帮你 VibeCoding 生成一万行代码,但它不知道这行代码在现实世界里能不能帮老板赚到钱。
利用 XY 轴学习法,迅速拉宽你的业务边界。去理解财务、去理解供应链、去理解硬件、去理解人类真正的、模糊的诉求。 用你的认知去框定 AI 应该去解决什么问题,用你的 XY 轴广度,去增大对于“AI 能做什么”的终极掌控力。 (换句话说,也就是当今最需要的人才:FDE!) https://www.vibecodingjapan.com/blog/1779372102828?lang=zh
结语
2026 年的台北 GTC,黄仁勋用一贯的微笑和近乎神迹的工程落地能力(2小时组装机架缩短至5分钟,量产 Vera Rubin),向全球宣告:
硅基智能的工厂已经全线开工,时代的列车没有售票员,谁先跳上车,谁就能分到第一波 Token 时代的红利。
这是一场属于勇敢者的“搞钱”游戏。程序员们,丢掉对旧代码的执念吧,带上你的 RTX Spark,去迎接工作流与智能体交织的璀璨明天!