
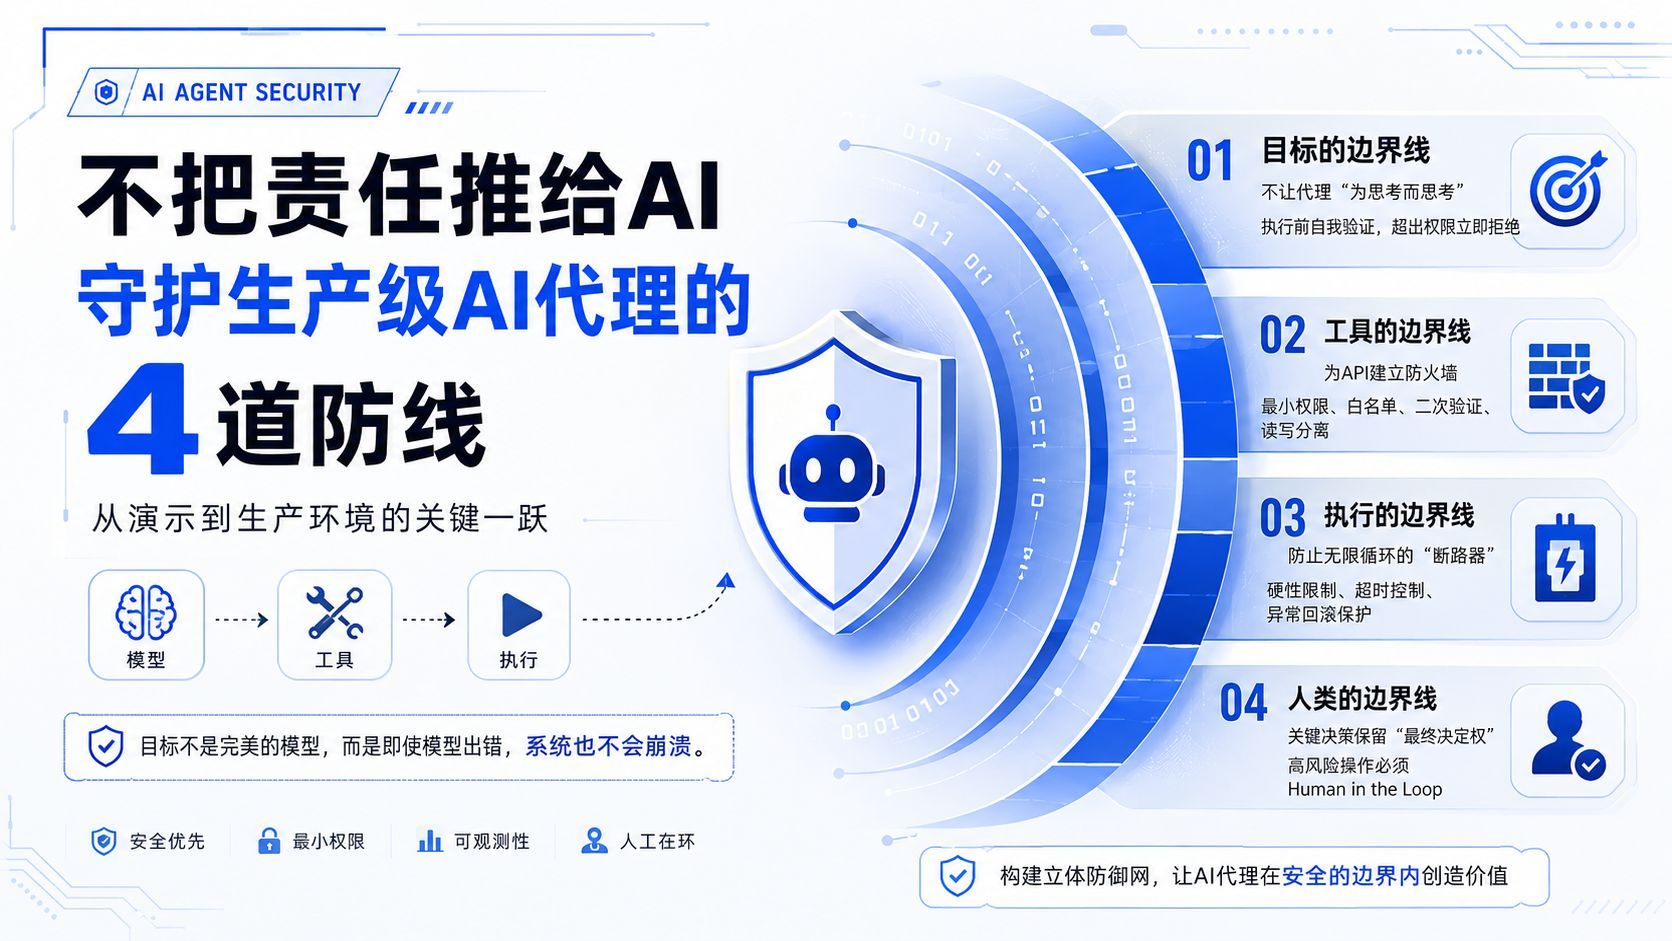
将AI智能体推向生产环境:构建稳健系统的四大防御壁垒
在将AI智能体部署到生产环境时,仅提升模型性能是不够的,必须构建系统化的防御机制。本文详细探讨了工程师应构建的四大防线:通过准则约束用户指令的“目标边界”、严格限制API调用权限的“工具边界”、防范无限递归的“执行边界”,以及对高风险操作实施人工介入的“人为边界”。这是实现安全智能体运维的实践设计指南。

原文出处:
Agent安全边界怎么考虑?
http://xhslink.com/o/4doh6LIeRiC

原文作者:
@小哲讲大模型
https://xhslink.com/m/5DPOhM4HRaI
别让 Agent 成为你的“背锅侠”:生产级 AI 代理的四大防御工事
如果你在最近的 AI 浪潮中还没写过一个 Agent,那你可能真的错过了这场狂欢。看着大模型(LLM)调用 API、读写文档、甚至还能帮你发邮件,那种感觉就像是给代码装上了外挂,确实“爽”到不行。
但作为工程师,如果你只看到了“爽”,那就太危险了。
在本地跑一个 Demo 是一回事,但要把 Agent 部署到生产环境,那是另一回事。很多人在设计 Agent 时,往往只关注“模型-工具-执行”这个简单的链路,仿佛只要让模型变聪明,一切就万事大吉。但这就像是给一个刚拿到驾照的实习生发了一辆兰博基尼,还允许他不看红绿灯直接上高速。
我们必须深入探讨一下如何构建一个稳健的 Agent。与其试图训练一个永远不会犯错的神级模型,不如构建一个即使模型犯错,也不会炸掉生产环境的系统。
第一层:目标边界——别让 Agent “为了思考而思考”
很多人觉得模型最危险,其实不然。当用户下达指令——比如“帮我把所有订单删掉”——如果你直接让模型去解析并执行,那就是灾难的开始。
Agent 的第一个准则就是:永远不要因为用户的一句话就直接执行。
我们需要一套“目标边界”。这本质上类似 Anthropic 提出的 Constitutional AI(宪法 AI)思路:通过预定义规则约束模型的行为,而不是让它自由发挥。在执行任何高风险指令前,Agent 必须先进行自我核查:这个指令在授权范围内吗?如果不是,直接拒绝,而不是盲目听从。
第二层:工具边界——给你的 API 装上 Firewall
很多人忽略了一个冷酷的事实:工具才是那个真正会“动手”的家伙。
模型只是动动嘴,而工具是那个真正删除数据库、发起支付请求或发送钓鱼邮件的“执行者”。在生产环境里,你必须建立“工具防火墙”:
- 读写分离: 允许读取数据库是基础,但写操作必须经过审批。
- 物理隔离: 删除数据?必须人工二次确认。
- 权限最小化: 支付操作必须强制二次验证。
- 白名单机制: 发邮件?只能发给预设好的白名单用户。
永远不要给 Agent 无限权限,这是 Agent 安全框架中最基础的原则。
第三层:执行边界——防止无限递归的“熔断器”
很多事故并不是因为目标错了,而是执行过程失控了。
想象一下,你的 Agent 原计划是修改一条记录,结果因为逻辑 Bug,陷入了无限循环调用,把数据库刷了 100 遍;或者原本想发一封通知邮件,结果因为超时重试机制没做好,给客户发了 1000 封垃圾邮件。
这就是为什么“执行边界”至关重要。你需要引入类似于微服务架构中的“熔断机制”:
- 硬限制: 限制最大调用步骤、Token 使用量和工具调用次数。
- 超时控制: 超时立即终止。
- 防回滚: 出现异常时,确保系统能自动回滚到安全状态。
不要让 Agent 无限思考,更不要让它无线执行。
第四层:人类边界——关键决策的“最终解释权”
最后,也是最重要的一层,就是“人类边界”(Human in the loop)。
无论你的 Agent 再聪明,对于转账、删库、修改合同、调整生产配置这类高风险操作,必须保留人类监督。Agent 的价值在于分析、总结和建议,但最终的“那个确认键”,必须留给真正负责任的人类。
总结:从 Demo 到生产的蜕变
很多人在设计 Agent 时,思路往往停留在“模型-工具-执行”的线性思维中。但要打造一个生产级的系统,你应该建立起一道立体的防御网:
- 目标边界: 别照单全收,先核实合法性。
- 工具边界: 严格的权限管理,把危险工具关进笼子。
- 执行边界: 熔断机制,防止失控的无限递归。
- 人类边界: 高风险决策,必须 Human in the loop。
正如 这份文档 中所强调的,不要妄想训练一个完美的模型,而要构建一个即使模型偶尔“发疯”,也能稳住局面的防线。这才是从 Demo 走向生产环境时,最容易被忽略,却也最重要的一课。