
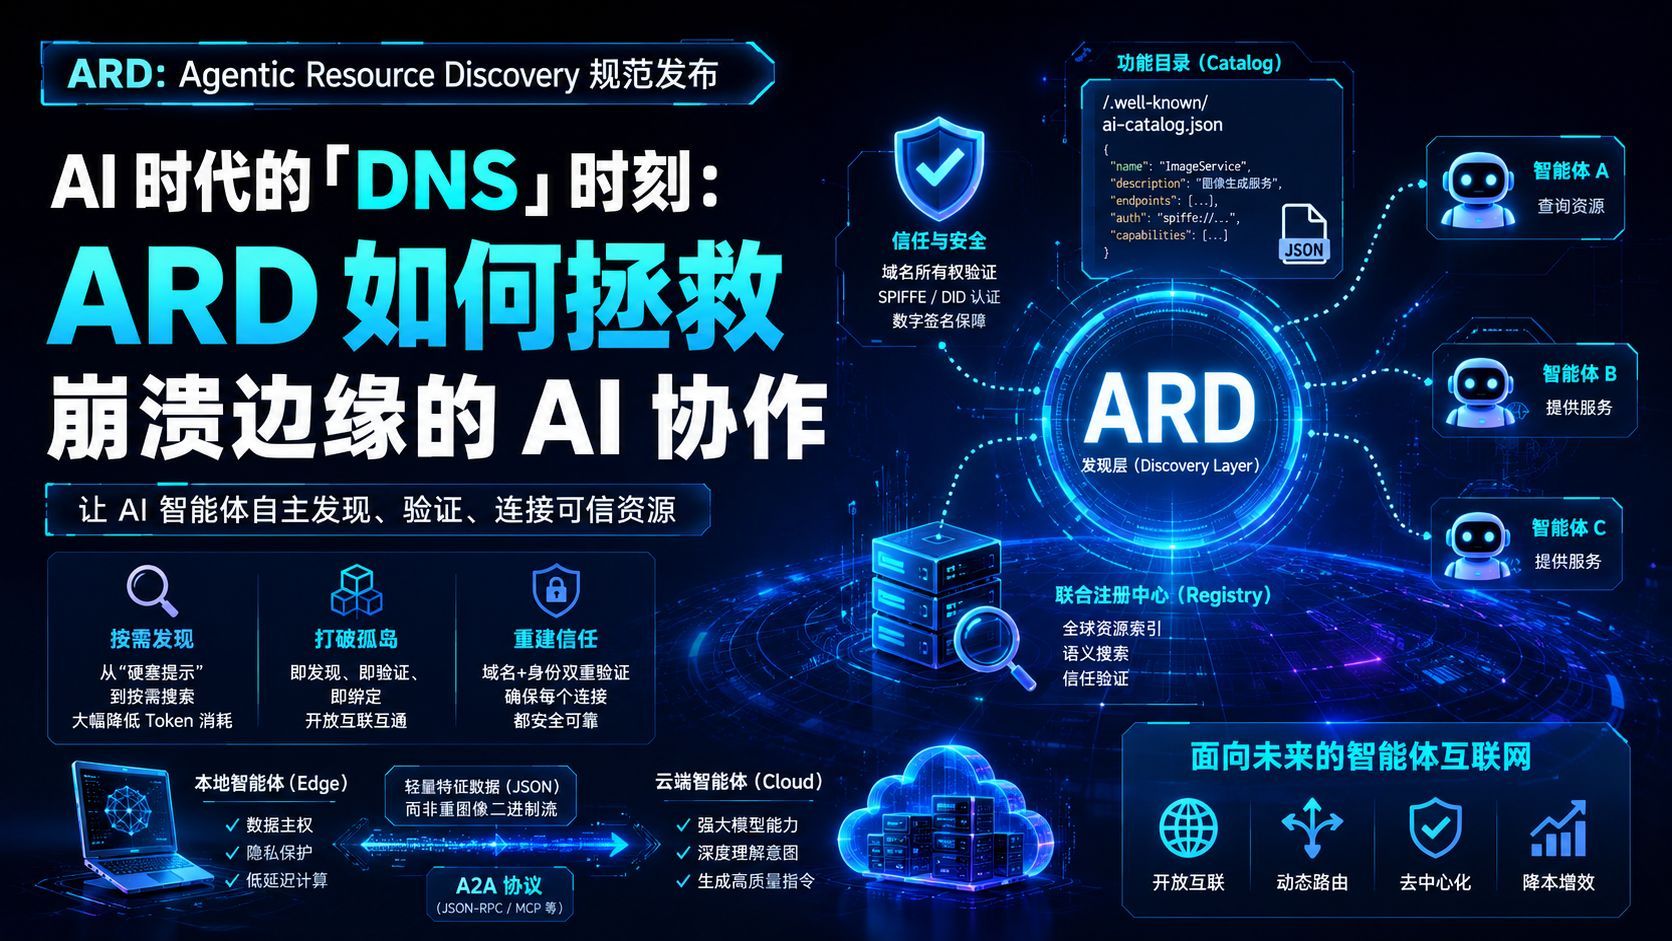
开启智能体协作新纪元:ARD(Agentic Resource Discovery)规范深度解析
面对AI Agent系统架构中工具臃肿、上下文窗口溢出的困境,Google、Microsoft与Hugging Face联合推出了“Agentic Resource Discovery (ARD)”规范。本文深入探讨了ARD如何通过类似于DNS的机制实现AI资源的自主发现与验证,解决多智能体生态中的互操作性与安全性问题,为构建去中心化的智能体互联网奠定基础。

智能体世界的“DNS”时刻:ARD 如何拯救濒临崩溃的 AI 协同?
作为一名 AI 工程师,你是否也有过这样的痛点?为了让智能体变得“全知全能”,我们不断地把各种 API 工具塞进它的系统提示词(System Prompt)里。起初还好,但随着工具数量增加,模型开始变得反应迟钝、推理能力下降,甚至对着简单的任务“产生幻觉”——这就是所谓的“上下文窗口膨胀”。
我们一直在等待一个标准,一个能让智能体在茫茫网海中自主发现、验证并调用外部能力的“互联网协议”。好消息是,由谷歌、微软、Hugging Face 等巨头联合推出的 智能体资源发现(Agentic Resource Discovery, 简称 ARD) 规范,终于来了。
为什么说 ARD 是多智能体生态的“救命稻草”?
在 ARD 出现之前,多智能体协作更像是一个“手动挡”时代。你需要预先配置好一切,硬编码每一个 API 的 URL 和密钥。一旦某个服务下线或者 API 变更,整个系统就会像多米诺骨牌一样崩塌。
ARD 的核心逻辑非常清晰:它不做运行时编排,它只负责“找”。
把它想象成互联网早期的 DNS。它不关心你发什么数据包,也不关心你怎么思考,它只负责回答一个核心问题:“谁能干这件事,而且我怎么确定它是安全的?”
ARD 解决的三大工程难题
- 从“暴力塞入”到“按需检索”:不再需要把成百上千个工具 Schema 塞给 LLM。ARD 让智能体在需要时,通过注册表(Registry)动态查找最匹配的资源,大幅节省了 Token 消耗,让模型保持清醒。
- 打破“孤岛效应”:告别“先安装、后使用”的死板流程。通过
ai-catalog.json文件和联合注册表,智能体可以实现“即时发现、即时验证、即时绑定”。 - 重建信任基石:跨组织协作最怕遇到恶意钓鱼节点。ARD 通过基于域名的所有权(Domain Ownership)和 SPIFFE/DID 身份验证,确保了每一次连接都经过了数字签名校验。
工程视角:从概念到落地
ARD 的物理本质非常接地气:一个托管在 /.well-known/ai-catalog.json 下的静态文件。这对于任何熟悉 Web 开发的工程师来说都极其友好。
它是如何运作的?
- 能力目录(Catalogs):就是那个
ai-catalog.json,它告诉外界:“我是谁,我能做什么,我的加密身份是什么。” - 联合注册表(Registries):这是 ARD 的“搜索引擎”,负责聚合全球的智能体资源,提供语义搜索和信任校验。
- 执行层(A2A 协议):记住,ARD 只是发现层。发现之后,真正的业务通信需要交给 Agent-to-Agent (A2A) 协议(如 JSON-RPC 或 MCP)去完成。
未来展望:边缘与云端的“视觉协同”
ARD 真正令人兴奋的地方,在于它如何赋能复杂的跨设备协作。
想象一个场景:本地智能体负责生成低分辨率的“视觉骨架”和构图特征,而云端智能体则负责理解用户的深度意图(如“赛博朋克风”、“霓虹雨夜氛围”)。
- 特征传输:本地智能体通过 ARD 找到云端智能体,建立连接。
- 意图融合:两端只传输极小的 JSON 特征数据(DataPart),而不是沉重的图像二进制流。
- 本地渲染:云端返回高精度的渲染指令(Prompt 参数、深度图),本地 Stable Diffusion 引擎负责最后的“像素级大作”。
这就是技术的魅力:云端的大模型提供了“灵魂”(意图与创造力),而边缘侧保留了“数据主权”(隐私与算力)。这种架构不仅极大降低了运营成本,还彻底消除了厂商锁定,让你的智能体可以根据实时性能动态切换服务商。
结语
ARD 的出现,标志着智能体生态从“史前时代”迈向了“互联时代”。对于我们这些开发者而言,是时候停止打造各种封闭的“AI 烟囱”,转而拥抱这种开放、可发现、可验证的协作规范了。
正如行业共识所言,ARD 的意义不在于构建某种应用,而在于为去中心化的智能体互联网铺设了最基础的“寻址轨道”。
想要了解更多关于这一规范的细节,可以查阅 ARD 技术标准文档)。让我们一起期待一个智能体能够自由协作的未来!
https://developers.googleblog.com/announcing-the-agentic-resource-discovery-specification/