
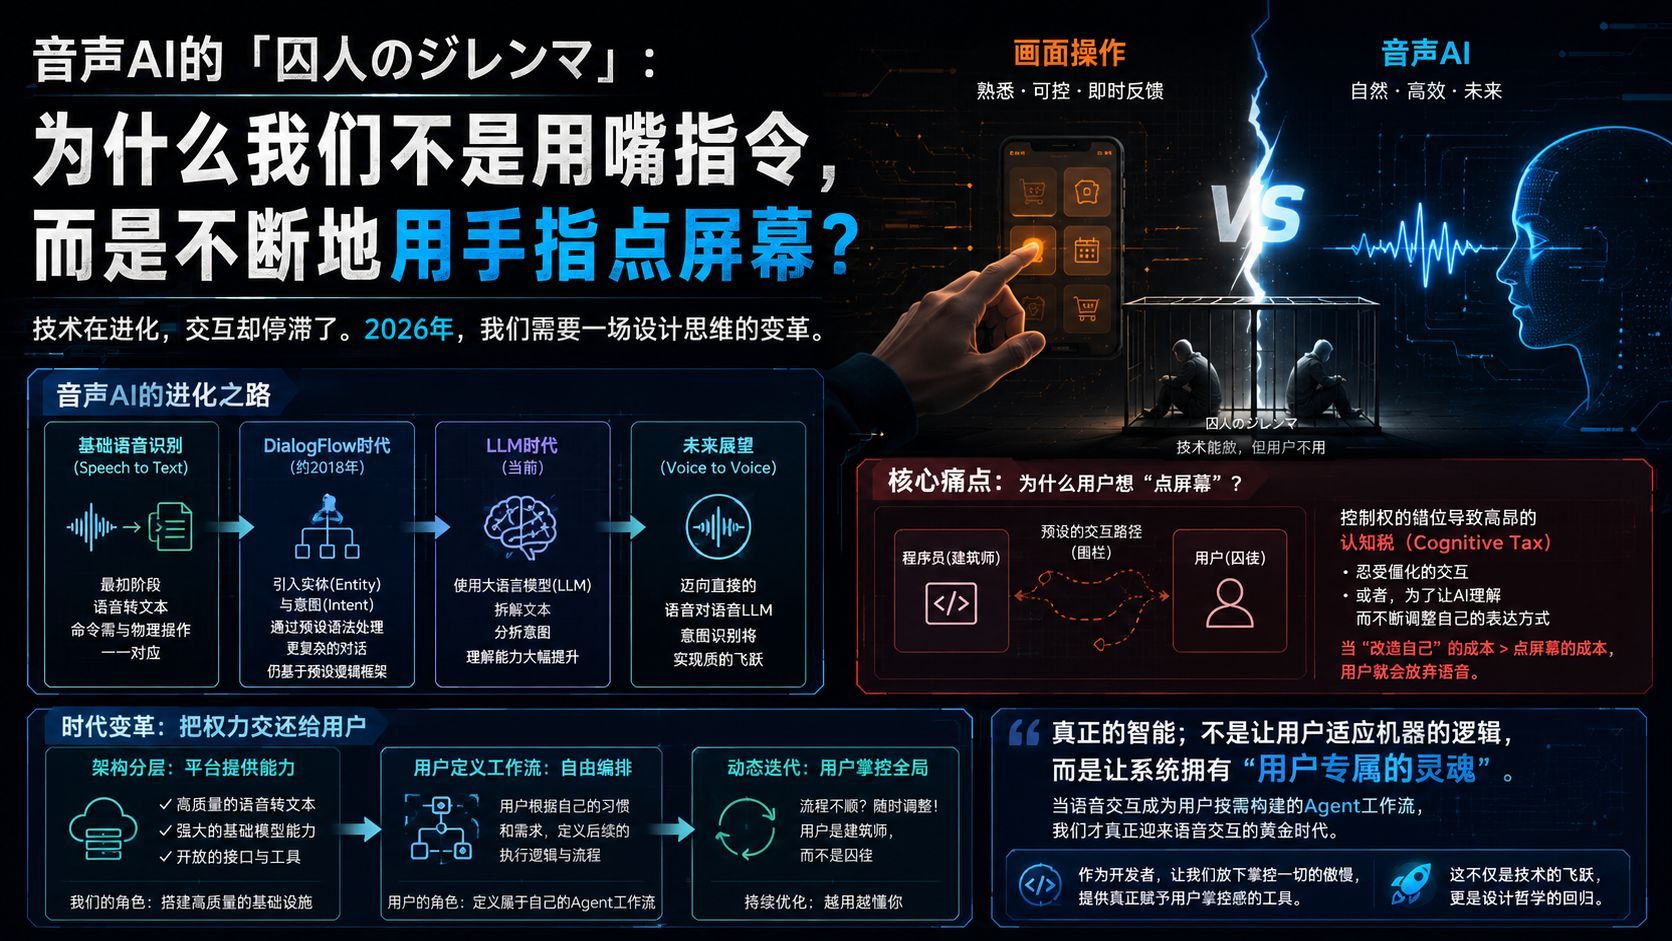
语音AI的“囚徒困境”:为什么我们更倾向于点击屏幕而不是口头指令?
尽管AI技术日新月异,语音交互仍未真正普及。其根本原因并非技术瓶颈,而是设计思维中的“囚徒困境”:程序员固化的逻辑强迫用户付出高昂的“认知税”来适应系统。本文探讨了从“预设指令”到“赋予用户权限”的范式转移,主张通过将工作流定义权交还给用户,构建真正符合个性化需求的语音AI体验。

语音AI的“囚徒困境”:为什么你还在点击屏幕,而不是用嘴指挥?
在2026年的当下,我们不得不承认一个略显尴尬的事实:尽管AI技术日新月异,但当我们想要完成一个稍微复杂的操作时,身体往往比嘴更诚实——我们依然习惯于伸出手指,点击屏幕。
语音AI,这个被视为“交互终极形态”的技术,为何至今难以真正普及?这不是技术能力的问题,而是我们作为开发者,在设计思维上陷入了一个漫长的“囚徒困境”。
语音AI的进化史:从听写到意图的博弈
回顾语音AI的进化路径,我们其实一直在“指令”与“理解”之间反复横跳:
- 基础语音识别(Speech to Text): 最早期的阶段,系统仅负责将语音转为文字,每一个指令都必须对应死板的物理动作。
- DialogFlow时代: 大约在2018年,我们引入了“实体”和“意图”概念。通过预设语法,系统终于能处理长句子了,但这依然是基于程序员预设的逻辑框架。
- LLM时代: 现在的我们,利用大语言模型对文本进行拆解和意图分析。
- 未来展望: 行业正在向直接的“Voice to Voice(语音对语音)”LLM迈进,届时意图识别将跨越式提升。
核心痛点:为什么用户总想“点击屏幕”?
作为工程师,我们往往自信地认为:“我的系统逻辑严密,预设了这么多功能,用户应该很方便才对。”
但真相恰恰相反。
语音AI未能普及的根本原因,在于用户与程序员之间的“控制权错位”。
在传统模式下,程序员就是那个“建筑师”,我们为用户设计了固定的交互模型。用户表面上是在指挥系统,实则被禁锢在我们预设的路径中。如果用户的真实需求超出了这些预设的“围栏”,或者交互方式让他们感到别扭,用户无法进行“软性调节”。
这导致了一个高昂的“认知税”:
- 用户要么忍受僵硬的交互;
- 要么花费大量精力去调整自己的措辞,试图“讨好”系统的逻辑。
当这种“为了让AI听懂而进行的自我改造”成本高于点击屏幕时,用户的选择显而易见:放弃语音。
跨时代的变革:将权力还给用户
如果我们要在2026年打造一款成功的音频AI产品,继续沿用“程序员预设一切”的设计范式注定会失败。
作为工程师,我们需要进行一场思维上的“权力移交”:将“Agent Workflow(代理工作流)”的定义权交还给用户。
这种新模式的核心在于:
- 架构分层: 我们的职责不再是预设交互路径,而是构建一套高质量的基础平台。它负责将语音转化为高精度的文字,并提供一个开放的接口。
- 用户定义工作流: 系统的后续执行逻辑,完全由用户根据自己的习惯来定义。
- 动态迭代: 用户不再是“囚徒”,而是“架构师”。如果某个流程不顺手,用户可以随时进行调整。
结语
真正的智能化,不是让用户去适应机器的逻辑,而是让系统拥有“用户专属的灵魂”。当语音交互不再是预设的命令,而是用户按照自身需求构建的Agent工作流时,我们才真正开启了音频交互的黄金时代。
作为开发者,是时候放下那种“一切尽在掌握”的傲慢,去交付一套真正让用户拥有掌控感的工具了。这不仅是技术的跃迁,更是设计哲学的一次回归。