
解读DiffusionGemma:超越逐字生成的并行推理革命
本文深度解析了DiffusionGemma,这是一种旨在突破传统自回归模型“逐字生成”瓶颈的新型推理方法。该模型采用“均匀状态扩散(Uniform State Diffusion)”技术,通过并行生成并微调256个token,成功将计算瓶颈从内存带宽转移至算力,实现了高达4倍的推理速度提升。此外,它还具备双向注意力机制带来的全局视野及再去噪(Re-Noising)带来的自我修正能力。通过vLLM即可部署,是提升大型模型推理效率的前沿技术。

作为开发者,我们似乎已经习惯了与“自回归(Autoregressive)”模型这种“逐字逐句”的特性共存。我们习惯了它为了生成一个句子,必须像挤牙膏一样,一个 token 接一个 token 地从内存中加载权重,然后痛苦地等待推理完成。
但如果我们换一种思路呢?如果模型不再是单纯的“接龙选手”,而是能够像画家一样,先铺开画布,再整体润色,那会怎样?这正是 DiffusionGemma: The Developer Guide 所带来的颠覆性改变。
为什么现在的模型“太慢了”?
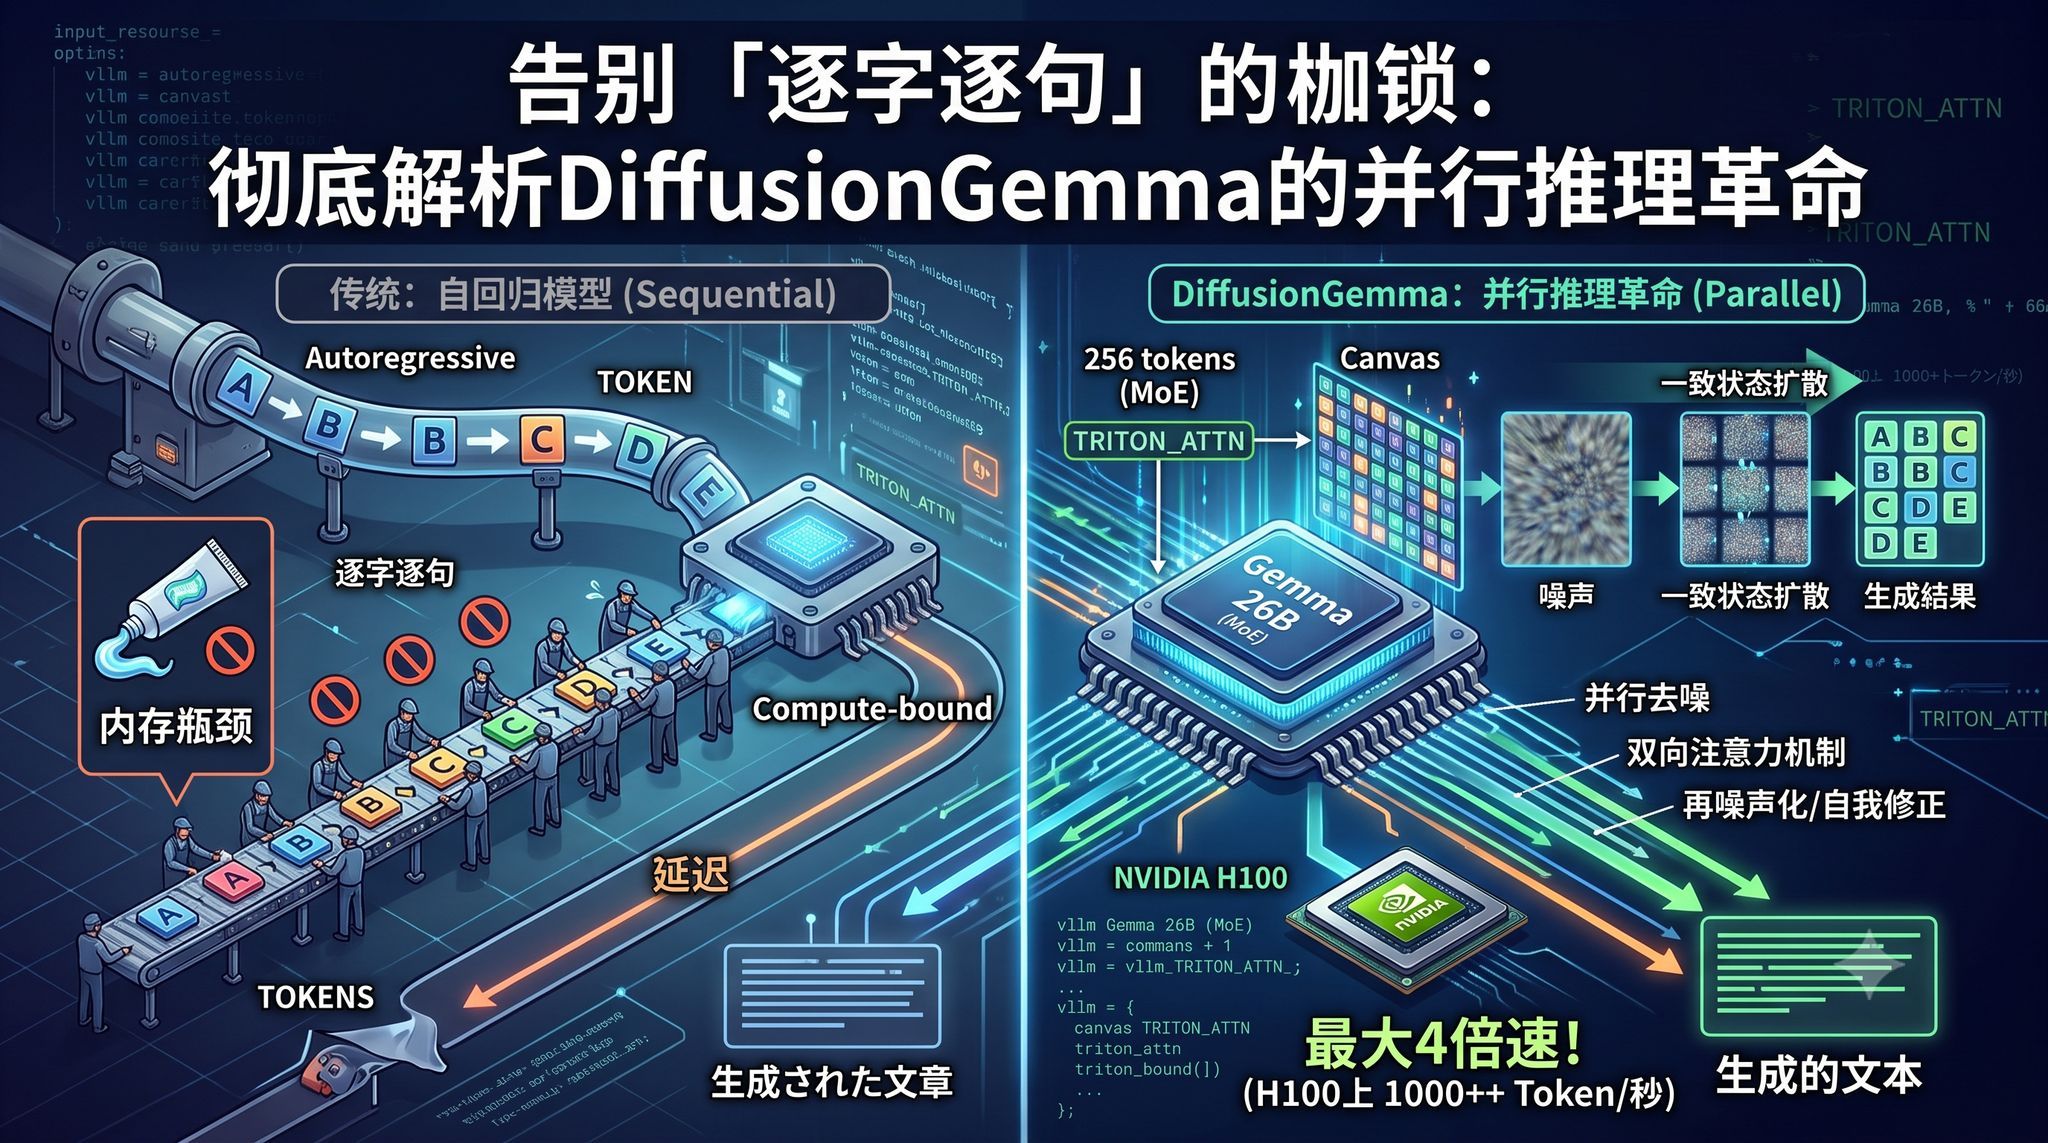
传统的自回归模型在 GPU 上运行,其最大的痛点往往不是计算能力不足,而是内存带宽限制。由于必须按顺序生成 token,模型必须反复从内存加载权重,这导致大量计算核心在等待数据时处于闲置状态。
DiffusionGemma 的出现,直接将瓶颈从内存带宽转移到了计算(Compute-bound)。通过并行生成和细化 256 个 token 的画布,它将原本“闲置”的张量核心利用了起来,实现了高达 4 倍的生成速度提升。在 NVIDIA H100 上,这甚至能达到每秒 1000+ token 的吞吐量。
从“接龙”到“全局协同”:DiffusionGemma 的魔力
DiffusionGemma 的核心在于统一状态扩散(Uniform State Diffusion)。它不是从左到右机械地输出,而是从一个充满随机噪声的“画布”开始,通过多次去噪迭代,让整个序列同时“聚焦”出正确的答案。
1\. 真正的“全局视野”
对于像 Sudoku(数独)这种存在严格约束的任务,传统模型往往因为“只能看过去,无法看未来”而显得手忙脚乱。DiffusionGemma 的\*\*双向注意力(Bidirectional Attention)\*\*机制改变了游戏规则。每一个 token 位置都能感知到画布上的所有其他位置,这意味着在处理约束问题时,它不再是盲人摸象,而是拥有了全局掌控力。
2\. 拥抱“知错能改”
传统模型生成的 token 一旦输出,就是“泼出去的水”,很难修正。而 DiffusionGemma 拥有\*\*重新加噪(Re-Noising)\*\*的能力。如果模型在迭代中对某个 token 的置信度下降,它完全有能力将其“擦除”并重新生成。这种自我纠错的能力,是自回归模型梦寐以求的。
3\. 长上下文的优雅平衡
为了处理长序列,DiffusionGemma 采用了“块自回归(Block Autoregressive)”策略。它将 256 个 token 作为一个块进行并行去噪,一旦确定,就将其提交到 KV 缓存中,然后再处理下一个块。这完美结合了扩散模型的并行速度与自回归模型的长序列稳定性。
工程师的“上手清单”
这不仅仅是一个研究模型,更是一个已经准备好投入生产的工具。它基于 Gemma 4 架构,是一个 26B 参数的混合专家模型(MoE),实际推理时仅激活 3.8B 参数,这意味着它能在 18GB VRAM 的限制下完成量化部署。
目前,开发团队已经与 vLLM 团队紧密合作,你可以直接通过 vLLM 进行部署:
vllm serve google/diffusiongemma-26B-A4B-it \
  --max-model-len 262144 \
  --max-num-seqs 4 \
  --gpu-memory-utilization 0.85 \
  --attention-backend TRITON_ATTN \
  --generation-config vllm \
  --hf-overrides '{"diffusion_sampler": "entropy_bound", "diffusion_entropy_bound": 0.1}' \
  --diffusion-config '{"canvas_length": 256}' \
  --enable-chunked-prefill
展望:这不是终点
DiffusionGemma 为我们展示了一种可能性:通过改变生成逻辑,我们可以在保持模型性能的同时,极大地提升推理效率。
作为一个开发者,看到这种从“本质”层面优化推理逻辑的创新,确实令人兴奋。毕竟,谁不想拥有一台既快又聪明,而且还懂得“三思而后行”的模型呢?