
构想未来:Voice to Action 技术理论与产业变革
本文提出了“Voice to Action(语音即行动)”的核心理论,旨在超越传统的“语音转文字”模式,实现系统对用户意图的深度解析与自动化执行。探讨了这一理念如何推动硬件创新、重塑开发者的工作重点,并展望了万物互联的智能社会愿景。

在当前人工智能技术发展的浪潮中,我提出了一个核心理论——Voice to Action(语音即行动)。这与现有的“Speech to Text”(语音转文字)、各类 AI Agent(智能体)或传统工作流(Workflow)有着本质的区别。这一理念起源于 2026 年末,旨在重新定义人与机器的交互方式。
一、 什么是 Voice to Action?
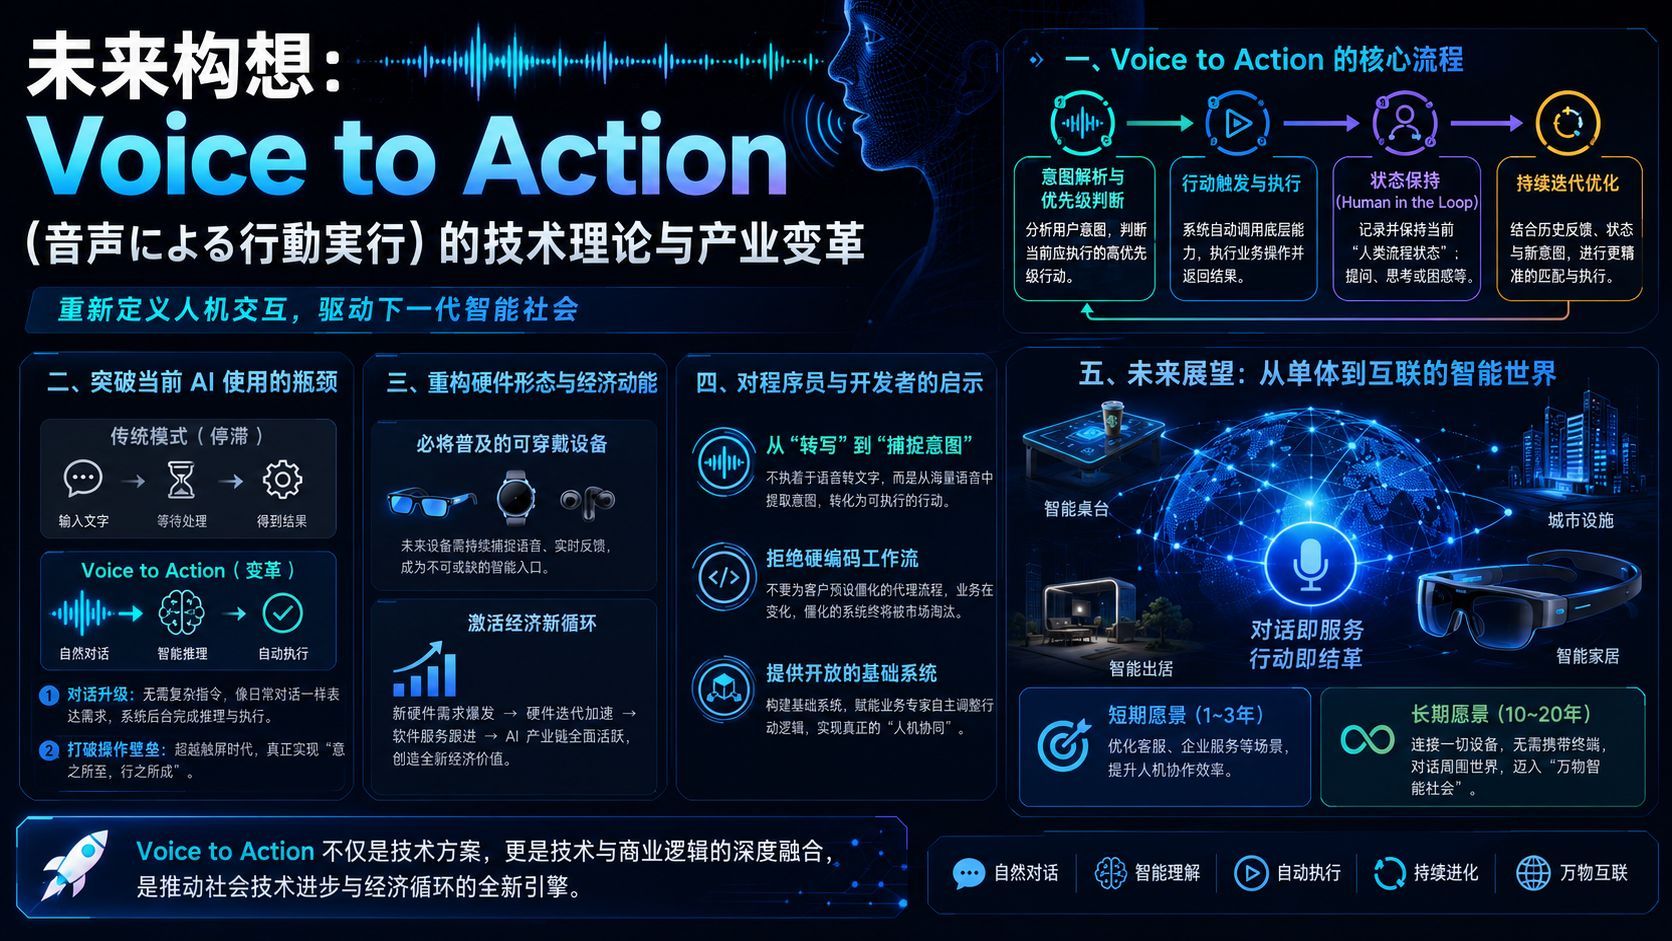
“Voice to Action”不仅仅是将语音转化为文字,其核心逻辑在于:用户通过语音表达意图,系统自动解析意图并触发相应的动作(Action)。
这一过程的完整闭环包括:
> 意图解析与优先排序:
系统分析用户语音中的核心意图,并判断当前最需要优先执行的“Action”。
> 动作触发与执行:
系统自动调用底层能力,执行相应的业务操作并返回结果。
> 状态保持(Human in the Loop):
在交互过程中,系统会记录并维护当前的“Human Flow(人机交互状态)”。它明确用户当前处于“正在提问”、“思考中”还是“不知所措”的状态。
> 持续迭代:
在下一次交互中,系统会结合上一轮的反馈(Feedback)、保存的“State(状态)”以及新感知到的意图,进行更精准的匹配和执行。
二、 突破当前 AI 使用的瓶颈
自 2023 年 ChatGPT 问世以来,人机交互方式其实陷入了某种停滞:人们依然停留在“输入一段话 -> 等待 -> 处理”的模式中。这种模式高度依赖用户的“提示工程(Prompt Engineering)”能力,即用户必须非常明确地告诉 AI 该做什么,这不仅效率低下,且让 AI 的使用显得枯燥且缺乏变革性。
Voice to Action 的变革在于:
1.交互升级:
用户无需学习复杂的指令,只需像平时说话一样表达需求,由系统后台负责猜想、解析与执行。
2.打破操作壁垒:
从 iPhone 时代开始,人机交互虽然经历了从按键到触屏的演变,但对于人的感官来说本质并未改变。Voice to Action 则是操作方式的下一次大变革,它让用户无需动手,实现真正的“意随心动”。
三、 硬件形态的重塑与经济动能
当前的智能手机和智能手表市场已趋于饱和,消费者换机动力不足。Voice to Action 理论的落地将推动硬件行业的全新爆发:
> 必需的穿戴设备:
未来的智能设备(如 AI 眼镜、具备显示功能的穿戴设备)将成为必需品。它们必须能够随时捕捉语音,并给予实时反馈,而不是简单的灯光闪烁。
> 经济循环的盘活:
这种新型设备将刺激消费电子市场的需求。当硬件迭代加速,软件服务厂商跟进,整个 AI 产业链将再次被盘活,从而创造新的经济价值。
四、 对程序员与开发者的启示
对于程序员而言,传统的“语音转文字”或“实时翻译”思维已经过时。未来的开发重点应当发生转变:
> 从“转录”转向“意图捕捉”:
开发者不应纠结于如何把话听懂并转成字,而应思考如何将海量的语音信息提炼为具体的“意图”,并转化为可执行的动作。
> 拒绝硬编码工作流:
这是开发者最容易踩的坑。不要试图为企业客户预设死板的 Agent Flow 或 Workflow。因为业务需求是不断变化的,死板的系统最终会被市场抛弃。
> 提供开放的系统:
程序员应当做的是构建一个“底层系统”,赋予懂业务的人(如客服、业务专家)自主调控 Action 的能力。让专业的人在 Human in the Loop 的环节中去配置和优化业务流程,实现真正的“强强联合”。
五、 展望未来:从单体到互联
Voice to Action 不仅仅是一个技术方案,它是未来 3 到 5 年内人工智能发展的风向标。
> 短期愿景:
通过 Voice to Action,优化现有的客服、企业服务等领域,提高人机协作效率。
> 长期愿景(10-20年):
随着技术演进,Voice to Action 将连接各类场景设备(如星巴克内的智能桌、城市中的各类设施)。届时,我们将进入一个“设备互联”的科幻时代——无需随身携带终端,只需开口,周围的感知系统即可协同处理,真正实现万物互联的智能社会。
综上所述,Voice to Action 代表了技术与业务逻辑的深度结合。这不仅是开发理念的更新,更是推动社会技术进步与经济循环的新动力。