
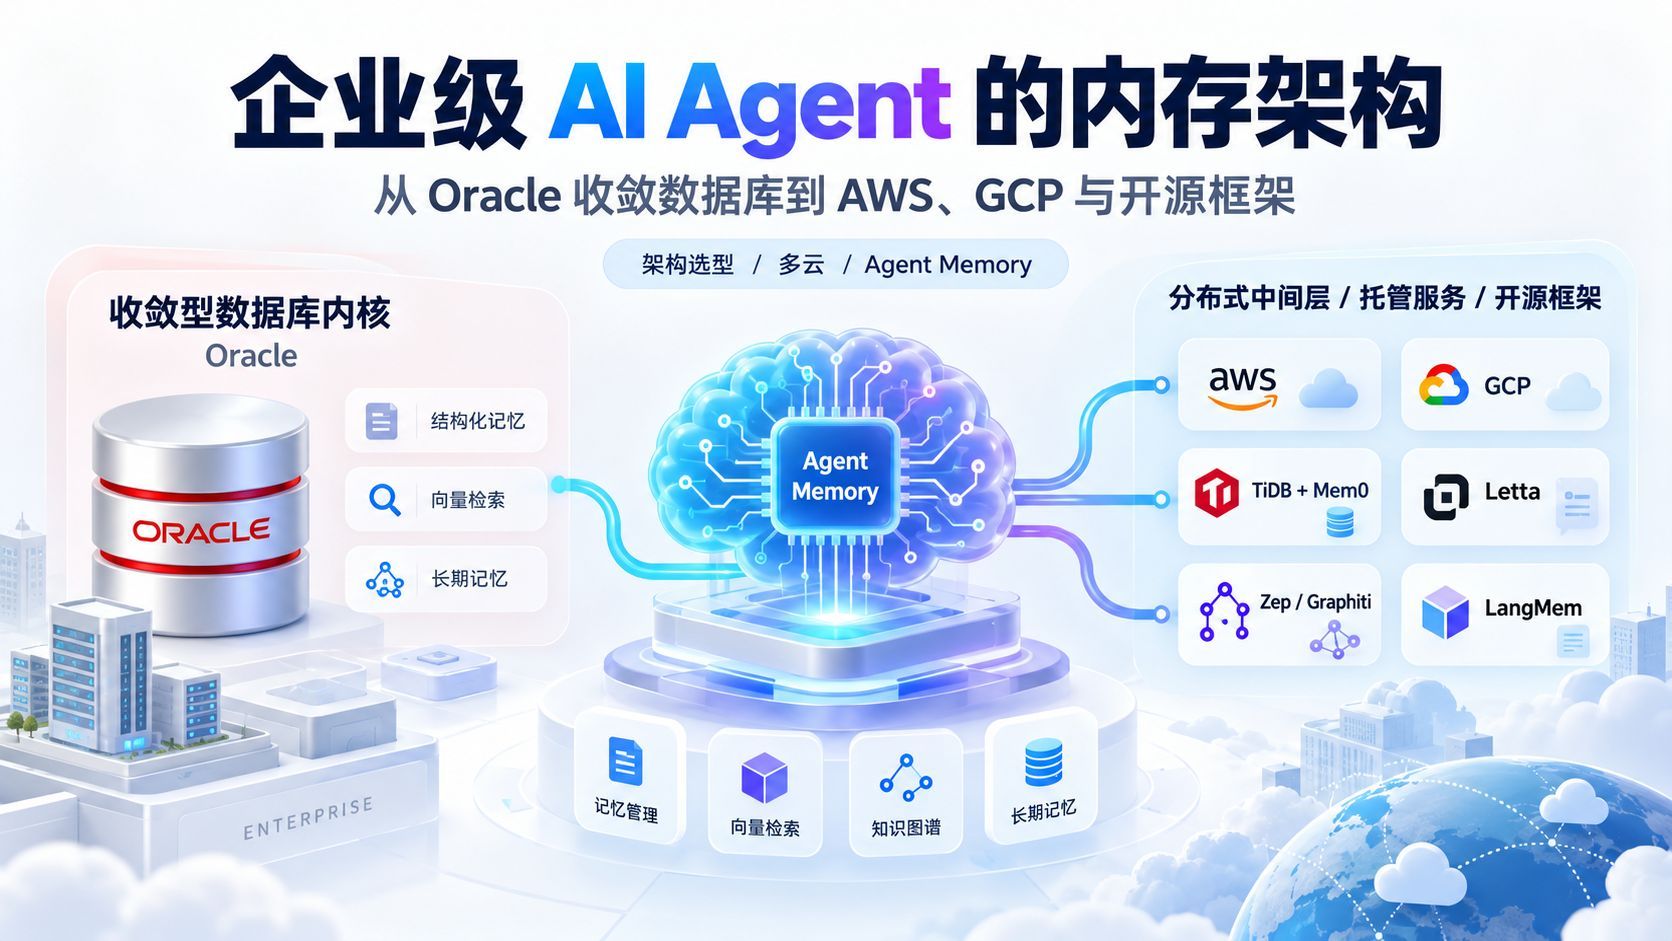
企业级 AI Agent 内存架构:Oracle、AWS、GCP 与开源方案的选型地图
当 AI Agent 开始承担跨天、跨周的长周期任务,内存便成为基础设施。本文梳理 Oracle AI Agent Memory 的收敛型数据库路线、TiDB Vector 加 Mem0 的分布式 HTAP 路线、AWS Bedrock AgentCore Memory 与 GCP Memory Bank 两套托管服务,并对比 Mem0、Letta、Zep/Graphiti、LangMem 四种开源框架,最后给出金融医疗、云原生、多租户 SaaS、强时序四类场景的选型参考与未来趋势。

企业级 AI Agent 的内存架构:从 Oracle 收敛数据库到 AWS、GCP 与开源框架
当 Agent 从"问答"变成"执行任务",内存成了瓶颈
大语言模型正在经历一次角色转变:从一次性的无状态问答,变成能够执行复杂、长周期任务的自律型 AI Agent。一旦 Agent 需要在几天甚至几周内持续跟踪同一件事,"记不住"就不再只是体验问题,而是系统能否成立的基础设施问题。
传统的 Prompt 拼接和简单向量检索增强生成(RAG)在单轮场景里够用,放到跨会话的长期任务里很快暴露出四类问题:上下文被无关内容稀释、检索延迟随数据量膨胀、数据在多个存储之间反复同步产生冗余,以及缺乏严格的数据治理与合规边界。
围绕这些瓶颈,主流云厂商和开源社区形成了两条明显不同的技术路线:
- 收敛型数据库内核(Converged Database Core):把 Agent 状态直接耦合进底层企业级数据库,代表是 Oracle AI Agent Memory;
- 分布式中间层与专有存储:用独立的中间层管理内存,后端接多种存储,代表是 AWS Bedrock AgentCore Memory、GCP Vertex AI Memory Bank,以及 Mem0、Letta、Zep/Graphiti、LangMem 等开源框架。
下面依次拆解这两条路线的架构原理、实现机制和适用边界,最后给出多云环境下的选型参考。
Oracle AI Agent Memory:把内存收敛进企业数据库
从"拼盘架构"到单一引擎
传统 Agent 内存系统通常是分散的拼盘:向量数据库存语义片段,图数据库维护实体关系,JSON 存会话历史和用户配置,关系型数据库处理业务交易。这种碎片化架构在企业级场景下带来三个连锁问题:运维复杂度高、重复的数据管道难以维护、权限与安全合规边界难以统一。
Oracle 的路线完全不同。它把 Oracle AI Agent Memory(搭载于 Oracle Database 23ai / Oracle AI Database)定位成企业 AI 系统的永续内存核心与第二系统级记录(System of Record)。借助原生收敛型数据库能力,单个引擎同时支持 Vector Search、JSON Document、Property Graph 和 Relational 四种数据模型。
对开发者而言,接入方式是 Python SDK,持久化内存层直接建在 Oracle AI Database 上,不需要把内存数据搬到外部服务再同步回来。内存数据与企业现有业务数据共用同一套存储引擎和索引机制,因此能同时拿到低延迟的上下文检索和强一致性保证。
两类内存与生命周期治理
Oracle 把 Agent 内存明确分成两类:
- 工作内存(Working Memory):跨会话保持任务上下文、交互状态、短期推理链和中间摘要,让 Agent 在中断后能精确恢复任务;
- 长期事实内存(Long-term Factual Memory):保存用户偏好、业务规则、历史任务结果以及随时间演进的事实。
检索层面不是只做向量相似度,而是把语义相似度、关键字精确度、元数据过滤、记录类型和显式内存作用域组合起来,提升复杂业务场景下的检索精度。
治理能力是它在企业市场的关键卖点。系统支持对内存碎片做显式作用域划分,分为 User(用户级)、Agent(智能体级)、Thread(线程级);当业务条件变更或用户要求行使"被遗忘权"时,可以执行级联删除与过期失效,避免留下孤立的失效碎片。这些能力继承企业级安全策略,例如行级安全与 KMS 加密。此外,它与 Oracle AI Database Private Agent Factory 深度集成,定义 Agent 时即可配置内存留存策略,指定会话状态与摘要的后端存储逻辑。
TiDB Vector + Mem0:用分布式 HTAP 换取云中立
TiDB Vector 在内存栈中的位置
如果企业追求云中立、高并发扩展,并且已经熟悉 MySQL 生态,那么在分布式 HTAP 数据库 TiDB 上扩展向量检索能力(TiDB Vector)是一条务实的路线。
纯向量数据库的短板在于:难以高效处理复杂的元数据过滤,也缺乏强一致性的事务更新。而 Agent 的内存记录从来不只是向量——每条记录还带着用户 ID、会话时间戳、租户隔离标签、访问控制列等大量关系数据。TiDB Vector 把高并发分布式 SQL 事务与高维向量检索放进同一个系统,并用分布式架构原生支持大规模多租户 Agent 内存的横向扩展。
Mem0 负责提取,TiDB 负责持久化
实际落地时,TiDB Vector 通常作为后端持久化存储,与 Mem0 这类轻量级内存中间层配合。Mem0 提供"提取与检索"(Extract-and-Retrieve)式的 API:新对话进来后,Mem0 内部调用 LLM 从文本中提取结构化事实,再把事实转成向量与 JSON 结构。把 TiDB Vector 配成 Mem0 的后端后,Mem0 的 CRUD(创建、读取、更新、删除)操作会直接映射成 TiDB 中的分布式向量与关系 SQL 操作。
这套组合的价值有两层。第一是多云可移植性:无论 Agent 部署在 AWS EKS、Google Cloud GKE 还是 TiDB Cloud 上,内存访问代码库可以保持统一。第二是实时分析:借助 HTAP 特性,分析系统可以直接对海量历史内存数据跑实时 SQL 统计——比如分析高频用户偏好趋势——而不影响在线 Agent 内存检索的低延迟响应。
AWS 与 GCP 的托管式 Agent Memory
对深度绑定公有云生态的企业,AWS 和 Google Cloud 都提供了平台级托管的 Agent 内存服务,目标是降低开发者的底层运维门槛,实现开箱即用的上下文持久化。
Amazon Bedrock AgentCore Memory
AWS 把 Agent 内存收进 Amazon Bedrock AgentCore 生态(包含 AgentCore Runtime、AgentCore Memory 与 AgentCore Observability)。它的设计清晰地割裂了"运行期隔离会话"和"持久化长效内存"两个概念。
运行期会话由 AgentCore Runtime 维护,带有严格的会话超时机制:默认 15 分钟,最高可扩展到 8 小时;原始事件数据在会话终止后或超过 TTL(通常 30 至 90 天)后自动清理。长期内存由 AgentCore Memory 提供,采用异步提取与固化机制——会话事件产生后,托管后台异步调用大模型,依据预定义的内存策略(Memory Strategies)从原始对话流中提取结构化洞察。
AWS 内置三种标准长期内存策略:
- 语义策略(Semantic Strategy):提取并保存对话中提及的事实与知识,例如记录客户公司的规模与跨区域办公室布局;
- 摘要策略(Summary Strategy):跨会话维护运行中的对话摘要,捕获核心决策与流程进展;
- 用户偏好策略(User Preferences Strategy):自动提取用户的行为偏好、语言风格或编码规范。
成本方面,AgentCore Memory 的主要开销来自内存整合(Consolidation)时的 Bedrock LLM 调用。存量内存规模较大时,AWS 建议引入基于相关性阈值的剪枝(Pruning)与定时合并策略,避免后台 token 消耗剧增。在多租户安全层面,开发者必须在应用层强行绑定 Session 与 Authenticated Owner(认证所有者),防止跨租户内存越权检索。
GCP Vertex AI Agent Engine Memory Bank
Google Cloud 在 Vertex AI Agent Engine 中提供 Memory Bank 托管服务,主要与 Google ADK(Agent Development Kit)及 Vertex AI Sessions 协同工作。
它的核心理念是动态事实提炼与智能去重合并。工作机制是:每当 Agent 与用户在 Vertex AI Sessions 中完成多轮对话,Session 数据会被提交至 Memory Bank;分析引擎自动提取结构化事实(如身份、饮食禁忌、房间偏好等),并与该用户 ID 下已有的历史内存进行对比。Memory Bank 不会机械地追加重复数据,而是自动执行合并(Consolidation)与更新。
检索支持两种范式:一是作用域检索(Scope-Based Retrieval),拉取特定用户的所有内存记录构建全局 Profile,适用于管理后台或全量上下文初始化;二是相似度检索(Similarity Search),基于向量语义匹配,针对特定问题快速抽取相关上下文,适用于高并发的实时对话交互。
四套方案对比
| 维度 / 平台 | Oracle AI Agent Memory | AWS Bedrock AgentCore Memory | GCP Vertex AI Memory Bank | TiDB Vector + Mem0 |
|---|---|---|---|---|
| 底层存储依赖 | Oracle AI Database 23ai(收敛引擎) | 托管式 AWS 存储 + Bedrock 模型 | Vertex AI Agent Engine 内置存储 | TiDB 分布式数据库(MySQL 协议) |
| 数据整合机制 | 数据库内原生多模态关联与检索 | 异步后台 LLM 提炼(语义/摘要/偏好) | 基于 Session 提取,智能去重与合并 | Mem0 提取层驱动,写入分布式 SQL |
| 多云与部署弹性 | OCI 最佳,支持 OCI Dedicated/Customer | 仅限 AWS 云原生环境 | 仅限 GCP Vertex AI 生态 | 跨云原生(AWS、GCP、自建 K8s) |
| 生命周期控制 | 级联删除,User/Agent/Thread 显式作用域 | TTL 自动过期、剪枝策略与 Guardrails | 针对 User ID 自动整合与去重 | CRUD 显式 API 控制,依赖数据库 TTL |
| 主要成本构成 | DB 实例/服务资源容量 | Bedrock LLM 异步 Consolidation Token | Agent Engine 托管 API 与推断费用 | TiDB 节点 Compute/Storage 资源 |
云中立与开源框架的四种内存架构
如果要在 AWS、GCP 或私有云上灵活自建 Agent 系统,开源社区里最具代表性的四种内存架构是 Mem0、Letta(原 MemGPT)、Zep/Graphiti 和 LangMem。它们在数据结构、更新机制和时序推理能力上有着本质区别。
Mem0:轻量级事实提取与向量内存
Mem0 的设计哲学是提供极简的"Drop-in"内存 API。它绕开复杂的操作框架模式,专注从对话流中提取原子事实(Atomic Facts),并把事实绑定到特定作用域(User、Agent、Session 或 App)。
新对话传入后,Mem0 调用 LLM 提炼短事实,转成 Embedding 存入向量数据库(支持 TiDB Vector、Qdrant、pgvector 等)。出现冲突事实时,它依赖 LLM 在写入时进行覆盖或原位更新(Update in place)。在 LongMemEval 等测试集中,Mem0 展现出较高的事实检索准确率,开箱即用的便捷性是其最大优势。
Letta:把 LLM 上下文当成操作系统的内存
Letta 继承 MemGPT 论文的经典思想,把 LLM 的上下文窗口比作操作系统的内存(RAM),把外部存储比作硬盘,并主张 Agent 应当具备自我编辑内存(Self-Editing Memory)的能力。它把内存划分为三个层级:
- 核心内存(Core Memory):常驻于 Prompt 上下文中,包含人设(Persona)与用户关键画像,Agent 可以通过调用工具(Tools)主动修改这一区域;
- 归档内存(Archival Memory):无限容量的外部向量存储,当 Core Memory 装不下时,Agent 可将信息分页(Page out)写入归档,并在需要时通过检索分页(Page in)读入上下文;
- 召回内存(Recall Memory):完整记录所有的会话历史日志。
Letta 内部采用类似于 Git 的文件与 Diff 追踪机制管理内存变更,适合构建长周期运行、具备自我进化能力的复杂 Agent。
Zep / Graphiti:双时序知识图谱
Zep 及其底层开源引擎 Graphiti 代表了 Agent 内存向图论与时序推理演进的方向。Zep 的核心判断是:传统的向量检索处理不了事实随时间演进与冲突的问题。例如"用户上个月住在北京,本月搬到了上海",如果只做向量匹配,Agent 会同时检索出两条相反的信息,导致 LLM 发生幻觉。
Graphiti 为图中的每一条边(关系)赋予精确的时间戳维度,包含两层时间:"事实生效时间"(Valid-From / Valid-To)以及"系统学习到该事实的时间"(Learned-At / Expired-At)。当接收到新的矛盾事实时,Graphiti 不会简单地删除旧数据,而是在图中将旧边的 Valid-To 标记为失效状态,同时建立新边。这种双时序模型不仅可以回答用户当前的状态,还可以精准回答系统在历史特定时刻的认知,极其适合金融、法律以及医疗等对审计溯源有硬性要求的企业场景。
LangMem:与 LangGraph 融合的三元内存
LangMem 由 LangChain 团队推出,目标是与 LangGraph 的持久化存储原语(BaseStore 与 Checkpointer)深度无缝协同。它把内存抽象拓展至三个维度:
- 语义内存(Semantic Memory):记录关于用户或环境的事实与偏好;
- 集锦内存(Episodic Memory):保存 Agent 过去执行特定任务的成功经验与思考链轨迹(Execution Traces),将其作为未来的少样本提示(Few-Shot Examples);
- 程序内存(Procedural Memory / System Instructions):通过 Prompt Optimizer API 分析历史对话与用户反馈,自动对 Agent 的 System Prompt 进行渐进式优化与重写。
四种开源框架对比
| 架构维度 | Mem0 | Letta (MemGPT) | Zep / Graphiti | LangMem (LangGraph) |
|---|---|---|---|---|
| 底层数据模型 | 向量嵌入 + JSON 提取事实 | 分层 State Blocks(Core/Archival) | 双时序知识图谱(Temporal Graph) | 三元内存(Semantic/Episodic/Procedural) |
| 检索路由模式 | 语义相似度(Vector Search) | 分页调度(Core 常驻 + Archival 检索) | 向量 + 混合文本 + 图遍历(Graph Traversal) | 语义匹配 + 少样本轨迹召回 |
| 冲突与作废机制 | 写入时基于 LLM 原位覆盖 | Agent 调用 Tool 手动编辑并记录 Git Diff | 图边缘标记时间戳失效(Valid-To) | 后台 LLM Pass 整理更新 Store 状态 |
| 程序/行为进化 | 仅限于事实数据更新 | 通过修改 Core Memory 改变人设 | 提取高阶 Observation 规则 | 原生提供 Prompt Optimizer 动态修改指令 |
| 典型后端适配 | 多种 Vector DB(含 TiDB Vector) | PostgreSQL / Git-backed Store | Neo4j / FalkorDB / Zep 云服务 | LangGraph BaseStore(Redis/Postgres) |
| 云平台兼容性 | 云中立,完全跨云 | 云中立,完全跨云 | 云中立,提供自建与 Zep Cloud | 云中立,完美适配 LangGraph 生态 |
多云选型:按数据合规与任务复杂度分流
架构选型没有通用最优解,关键是看企业现有的技术栈沉淀、数据合规要求以及业务任务的复杂程度。可以按四类场景分流。
金融、医疗等高度监管行业:核心诉求是严格的数据合规边界与零数据搬运。如果核心业务数据已经沉淀在 Oracle 数据库环境中,采用 Oracle AI Agent Memory(Oracle AI Database 23ai)是最直接的路径——直接在企业的 System of Record 上构建永续内存层,既避免了将敏感数据导出至外部第三方存储引发的合规风险,又直接继承了数据库原生的行级安全、审计日志与加密能力。
深度构建在 AWS 或 GCP 之上的云原生应用:采用托管级内存服务(AWS Bedrock AgentCore Memory 或 GCP Vertex AI Memory Bank)能够最小化底层运维负担。这类方案提供了预置的事实提取与自动合并逻辑,适合快速交付。但落地过程中,架构师必须在应用层显式实施租户所有权绑定,防止跨租户内存越权检索,同时需要建立内存剪枝机制,控制后台 LLM Consolidation 带来的 token 成本膨胀。
需要在 AWS、GCP 与私有云之间弹性部署的多租户 SaaS 平台:基于分布式 HTAP 数据库 TiDB Vector 配合 Mem0 或 LangMem 构筑内存层,是兼顾性能与跨云自由度的方案。TiDB Vector 提供了高并发的分布式 SQL 与向量联合检索能力,使企业不仅能为大量在线 Agent 提供低延迟内存 CRUD,还能使用标准 SQL 直接对全量历史内存数据执行实时分析。
涉及复杂供应链追踪、客户状态演进与法律风险排查等高度依赖时序逻辑的场景:Zep/Graphiti 的双时序知识图谱是更贴切的架构选项。传统向量数据库在面对频繁更替的事实信息时极易引发 LLM 幻觉,而双时序图谱能够精确记录关系的生效与失效时间,支持点在时间(Point-in-Time)历史查询,为要求严格审计的业务场景提供了可靠的演进痕迹与解释性。
结论:从"外部补丁"到"内生基础设施"
AI Agent 内存系统正在经历从"外部补丁"(Bolt-on Layer)向"深度内生"(Embedded Infrastructure)的架构转变。展望未来,有三个核心趋势值得关注。
第一,时序图与向量检索的深层次融合。单纯依赖向量相似度的内存提取机制正加速向双时序知识图谱靠拢,未来的企业级数据库与托管存储引擎将深度内生时序图推理能力,实现向量匹配与结构化图遍历的标准化统一。
第二,程序内存与自治优化的普及。Agent 内存将不再局限于保存静态的语义事实,而是开始大量保存过去的执行轨迹与成功经验(Episodic Memory),并通过自动化工具反馈持续修正 Agent 的 System Prompt 与行为策略,实现真正的自律进化。
第三,内存控制协议与接口的标准化。随着 Model Context Protocol(MCP)等开放传输协议的演进,Agent 内存的存储格式与访问接口正在趋向统一,这将允许内存数据在不同的云平台、托管服务与 Agent 框架之间进行安全、合规的流转与共享。