
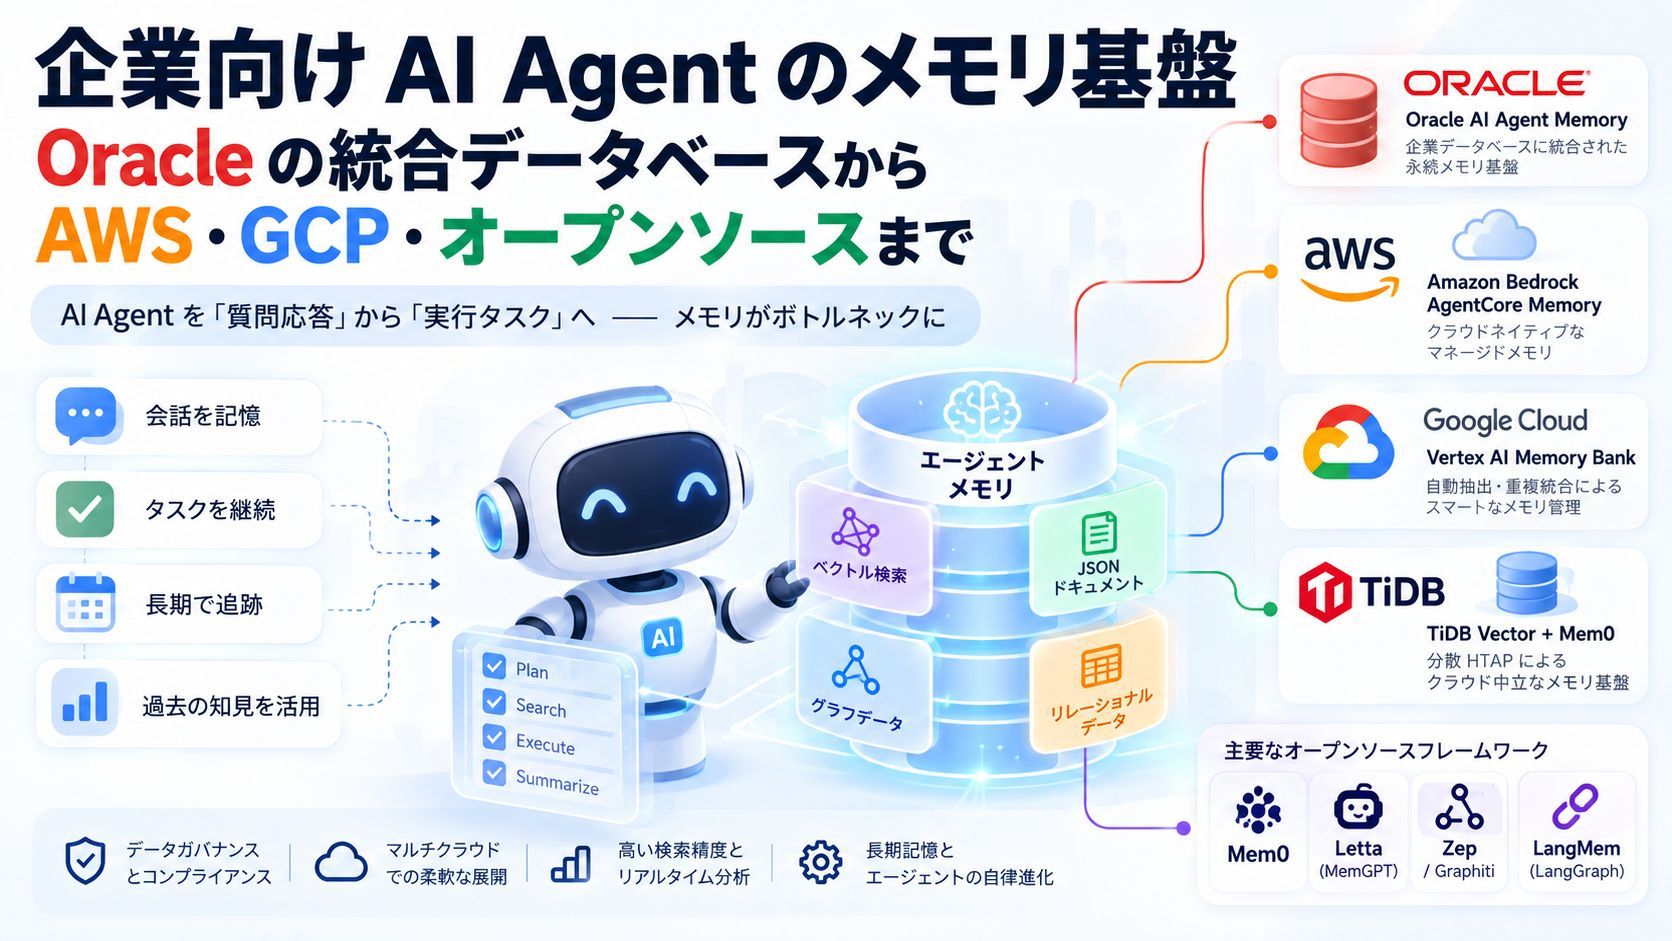
企業AI Agentのメモリアーキテクチャ最前線:Oracle収束DBからAWS・GCP・OSSまでの選定地図
AI Agentが長期タスクを担う時代、メモリは基盤インフラになる。Oracleの収束型DB、TiDB Vector+Mem0の分散HTAP、AWS Bedrock AgentCore MemoryとGCP Memory Bankのマネージド型、Mem0・Letta・Zep/Graphiti・LangMemのOSSを比較し、4シーン別の選定基準と今後の3趨勢を整理する。

企業向けAI Agentのメモリアーキテクチャ:Oracleの収束型データベースからAWS・GCP・オープンソースフレームワークまで
Agentが「Q&A」から「タスク実行」に変わるとき、メモリがボトルネックになる
大規模言語モデル(LLM)は、単発のステートレスな質疑応答から、複雑で長期間にわたるタスクを実行できる自律型AI Agent(エージェント)へと役割を変えつつある。Agentが数日、あるいは数週間にわたって同じ物事を追い続ける必要が出てくると、「覚えていない」ことはもはや体験の問題ではなく、システムが成立するかどうかを左右するインフラの問題になる。
従来のPrompt連結や単純なベクトル検索RAGは、単一ターンのシナリオでは十分に機能する。しかしセッションをまたぐ長期タスクになると、次の4つの問題がすぐに表面化する。無関係な内容でコンテキストが薄まる、データ量の増加に伴って検索レイテンシが膨らむ、複数のストレージ間でデータを繰り返し同期するために冗長性が生じる、そして厳密なデータガバナンスとコンプライアンス境界が欠ける、という4点だ。
こうしたボトルネックをめぐって、主要クラウド事業者とオープンソースコミュニティは、明確に異なる2つの技術路線を形成した。
- 収束型データベース・コア(Converged Database Core):Agentの状態を基盤となるエンタープライズデータベースに直接結合する路線。代表はOracle AI Agent Memory。
- 分散型ミドルウェアと専用ストレージ:独立したミドルウェアでメモリを管理し、バックエンドに多様なストレージを接続する路線。代表はAWS Bedrock AgentCore Memory、GCP Vertex AI Memory Bank、そしてMem0、Letta、Zep/Graphiti、LangMemなどのオープンソースフレームワーク。
以下では、この2つの路線のアーキテクチャ原理、実装メカニズム、適用範囲を順に分解し、最後にマルチクラウド環境での選定リファレンスを示す。
Oracle AI Agent Memory:メモリを企業データベースへ収束させる
「寄せ集めアーキテクチャ」から単一エンジンへ
従来のAgentメモリシステムは、多くの場合、分散した寄せ集めだ。ベクトルデータベースが意味的な断片を保存し、グラフデータベースがエンティティ間の関係を維持し、JSONが会話履歴とユーザー設定を保存し、リレーショナルデータベースが業務トランザクションを処理する。この断片化されたアーキテクチャは、エンタープライズの現場で3つの連鎖的な問題を引き起こす。運用が複雑になること、重複したデータパイプラインの維持が難しくなること、そして権限とセキュリティ・コンプライアンスの境界を統一しにくいことだ。
Oracleの路線はまったく異なる。Oracle AI Agent Memory(Oracle Database 23ai / Oracle AI Database上に搭載)を、企業AIシステムの永続メモリ・コア、そして第二のSystem of Record(システム・オブ・レコード)として位置づける。ネイティブな収束型データベース能力により、単一のエンジンがVector Search、JSON Document、Property Graph、Relationalという4つのデータモデルを同時にサポートする。
開発者にとっての接続手段はPython SDKで、永続メモリ層はOracle AI Database上に直接構築される。メモリデータを外部サービスへ移してから同期し直す必要はない。メモリデータは企業の既存業務データと同じストレージエンジンとインデックス機構を共有するため、低レイテンシのコンテキスト検索と強い一貫性保証を同時に得られる。
2種類のメモリとライフサイクル・ガバナンス
OracleはAgentメモリを明確に2つへ分類する。
- ワーキングメモリ(Working Memory):セッションをまたいでタスクのコンテキスト、対話状態、短期的な推論チェーン、中間サマリーを保持し、Agentが中断後もタスクを正確に再開できるようにする。
- 長期事実メモリ(Long-term Factual Memory):ユーザーの好み、業務ルール、過去のタスク結果、そして時間とともに変化する事実を保存する。
検索の層ではベクトル類似度だけを行うのではなく、意味的類似度、キーワードの正確さ、メタデータフィルタ、レコード種別、明示的なメモリスコープを組み合わせ、複雑な業務シナリオでの検索精度を高める。
ガバナンス能力は、エンタープライズ市場における重要な差別化点だ。メモリ断片に対して明示的なスコープを設定でき、User(ユーザー単位)、Agent(エージェント単位)、Thread(スレッド単位)に分けられる。業務条件の変更や、ユーザーによる「忘れられる権利」の行使に際しては、カスケード削除と期限切れ失効を実行し、孤立した無効な断片を残さない。これらの機能は、行レベルセキュリティやKMS暗号化といったエンタープライズ向けセキュリティポリシーを引き継ぐ。さらにOracle AI Database Private Agent Factoryと深く統合されており、Agentを定義する時点でメモリ保持ポリシーを設定し、会話状態とサマリーのバックエンド保存ロジックを指定できる。
TiDB Vector + Mem0:分散HTAPでクラウド中立を手に入れる
メモリスタックにおけるTiDB Vectorの位置づけ
クラウド中立、高並列スケール、そしてMySQLエコシステムへの親和性を求める企業にとって、分散HTAPデータベースTiDB上でベクトル検索機能を拡張するTiDB Vectorは、現実的な路線だ。
純粋なベクトルデータベースの弱点は、複雑なメタデータフィルタリングを効率的に処理しにくいこと、そして強一貫性のあるトランザクション更新を持たないことにある。一方でAgentのメモリレコードは決してベクトルだけではない。各レコードにはユーザーID、セッションのタイムスタンプ、テナント分離タグ、アクセス制御列といった大量のリレーショナルデータが付随する。TiDB Vectorは、高並列の分散SQLトランザクションと高次元ベクトル検索を同一システムに収め、分散アーキテクチャによって大規模マルチテナントのAgentメモリの水平スケールをネイティブに支える。
抽出はMem0、永続化はTiDB
実際の導入では、TiDB Vectorはバックエンドの永続ストレージとして、Mem0のような軽量なメモリミドルウェアと組み合わせることが多い。Mem0は「抽出と検索(Extract-and-Retrieve)」型のAPIを提供する。新しい会話が入ると、Mem0は内部でLLMを呼び出してテキストから構造化された事実を抽出し、その事実をベクトルとJSON構造に変換する。TiDB VectorをMem0のバックエンドとして設定すれば、Mem0のCRUD(作成・読み取り・更新・削除)操作は、TiDB内の分散ベクトルおよびリレーショナルSQL操作へ直接マッピングされる。
この組み合わせの価値は2層ある。第1はマルチクラウド可搬性だ。AgentをAWS EKS、Google Cloud GKE、TiDB Cloudのどこにデプロイしても、メモリアクセスのコードベースを統一できる。第2はリアルタイム分析だ。HTAPの特性により、分析システムはオンラインのAgentメモリ検索の低レイテンシ応答に影響を与えずに、膨大な過去メモリデータへ直接リアルタイムSQL集計を実行できる。たとえば頻出するユーザー嗜好のトレンドを分析する、といった用途が考えられる。
AWSとGCPのマネージド型Agent Memory
パブリッククラウドのエコシステムに深く依存する企業に向けて、AWSとGoogle CloudはどちらもプラットフォームレベルのマネージドAgentメモリサービスを提供し、開発者の基盤運用負荷を下げ、すぐに使えるコンテキスト永続化を目指している。
Amazon Bedrock AgentCore Memory
AWSはAgentメモリをAmazon Bedrock AgentCoreエコシステム(AgentCore Runtime、AgentCore Memory、AgentCore Observabilityを含む)に組み込んだ。その設計は「実行中の分離セッション」と「永続的な長期メモリ」という2つの概念を明確に切り離している。
実行セッションはAgentCore Runtimeが維持し、厳格なセッションタイムアウト機構を持つ。デフォルトは15分で、最大8時間まで拡張できる。元のイベントデータは、セッション終了後、またはTTL(通常30〜90日)を超えた後に自動でクリーンアップされる。長期メモリはAgentCore Memoryが担い、非同期の抽出と固化の仕組みを採用する。セッションイベントが発生すると、マネージドのバックグラウンドが非同期で大規模モデルを呼び出し、定義済みのメモリ戦略(Memory Strategies)に沿って元の会話ストリームから構造化された洞察を抽出する。
AWSは標準で3つの長期メモリ戦略を用意する。
- セマンティック戦略(Semantic Strategy):会話で言及された事実と知識を抽出・保存する。たとえば顧客企業の規模や地域をまたぐオフィス配置を記録する。
- サマリー戦略(Summary Strategy):セッションをまたいで進行中の会話サマリーを維持し、主要な意思決定とプロセスの進展を捉える。
- ユーザー嗜好戦略(User Preferences Strategy):ユーザーの行動嗜好、言語スタイル、コーディング規約を自動で抽出する。
コスト面では、AgentCore Memoryの主要な費用はメモリ統合(Consolidation)時のBedrock LLM呼び出しから生じる。既存メモリの規模が大きいシステムでは、AWSは関連性しきい値に基づく剪定(Pruning)と定時マージ戦略の導入を勧めており、バックグラウンドのtoken消費が急増するのを避ける。マルチテナントのセキュリティでは、開発者はアプリケーション層でSessionとAuthenticated Owner(認証済みオーナー)を強制的に紐づけ、テナントをまたいだメモリの権限外検索を防がなければならない。
GCP Vertex AI Agent Engine Memory Bank
Google CloudはVertex AI Agent Engine内でMemory Bankマネージドサービスを提供し、主にGoogle ADK(Agent Development Kit)およびVertex AI Sessionsと連携して動作する。
その中核理念は、動的な事実抽出とインテリジェントな重複排除・統合にある。仕組みはこうだ。AgentとユーザーがVertex AI Sessionsで複数ターンの会話を終えるたびに、SessionデータがMemory Bankへ送信される。分析エンジンが構造化された事実(身元、食事制限、部屋の好みなど)を自動抽出し、そのユーザーIDに既存の履歴メモリと照合する。Memory Bankは重複データを機械的に追記するのではなく、統合(Consolidation)と更新を自動で実行する。
検索は2つのパラダイムをサポートする。1つはスコープベース検索(Scope-Based Retrieval)で、特定ユーザーの全メモリレコードを取得してグローバルなProfileを構築する。管理画面や全量コンテキストの初期化に適する。もう1つは類似度検索(Similarity Search)で、ベクトルの意味的マッチングに基づき、特定の質問に対して関連コンテキストを素早く抽出する。高並列のリアルタイム対話に適する。
4つの選択肢の比較
| 次元 / プラットフォーム | Oracle AI Agent Memory | AWS Bedrock AgentCore Memory | GCP Vertex AI Memory Bank | TiDB Vector + Mem0 |
|---|---|---|---|---|
| 基盤ストレージ依存 | Oracle AI Database 23ai(収束エンジン) | マネージドAWSストレージ + Bedrockモデル | Vertex AI Agent Engine内蔵ストレージ | TiDB分散データベース(MySQLプロトコル) |
| データ統合メカニズム | データベース内のネイティブなマルチモーダル関連付けと検索 | 非同期バックグラウンドLLM抽出(セマンティック/サマリー/嗜好) | Sessionベースの抽出、インテリジェントな重複排除と統合 | Mem0抽出層が駆動し、分散SQLへ書き込み |
| マルチクラウドとデプロイ柔軟性 | OCIが最適、OCI Dedicated/Customerをサポート | AWSクラウドネイティブ環境に限定 | GCP Vertex AIエコシステムに限定 | クラウド横断ネイティブ(AWS、GCP、自建K8s) |
| ライフサイクル制御 | カスケード削除、User/Agent/Threadの明示的スコープ | TTL自動失効、剪定戦略とGuardrails | User ID単位の自動統合と重複排除 | CRUD明示API制御、データベースTTLに依存 |
| 主要コスト構成 | DBインスタンス/サービスリソース容量 | Bedrock LLM非同期Consolidation Token | Agent EngineマネージドAPIと推論費用 | TiDBノードのCompute/Storageリソース |
クラウド中立とオープンソースフレームワークの4つのメモリ構造
AWS、GCP、あるいはプライベートクラウド上でAgentシステムを柔軟に自建したい場合、オープンソースコミュニティで最も代表的な4つのメモリアーキテクチャは、Mem0、Letta(旧MemGPT)、Zep/Graphiti、LangMemだ。これらはデータ構造、更新メカニズム、時系列推論能力において本質的に異なる。
Mem0:軽量な事実抽出とベクトルメモリ
Mem0の設計哲学は、極めてシンプルな「Drop-in」メモリAPIを提供することにある。複雑な操作フレームワークのパターンを避け、対話ストリームから原子的事実(Atomic Facts)を抽出し、その事実を特定のスコープ(User、Agent、Session、App)へ紐づけることに集中する。
新しい会話が入ると、Mem0はLLMを呼び出して短い事実を抽出し、Embeddingに変換してベクトルデータベース(TiDB Vector、Qdrant、pgvectorなどをサポート)へ保存する。矛盾する事実が現れた場合、Mem0は書き込み時にLLMによる上書きや原位更新(Update in place)に依存する。LongMemEvalなどのテストセットで、Mem0は高い事実検索精度を示しており、すぐに使える手軽さが最大の強みだ。
Letta:LLMのコンテキストをOSのメモリとして扱う
LettaはMemGPT論文の古典的な思想を継承し、LLMのコンテキストウィンドウをオペレーティングシステムのメモリ(RAM)に、外部ストレージをハードディスクになぞらえ、Agentが自己編集メモリ(Self-Editing Memory)能力を持つべきだと主張する。メモリを3つの階層に分ける。
- コアメモリ(Core Memory):Promptコンテキストに常駐し、ペルソナ(Persona)とユーザーの重要プロファイルを含む。Agentはツール(Tools)を呼び出してこの領域を能動的に変更できる。
- アーカイバルメモリ(Archival Memory):容量無制限の外部ベクトルストレージ。Core Memoryに収まらないとき、Agentは情報をページアウト(Page out)してアーカイブへ書き込み、必要なときに検索してページイン(Page in)しコンテキストへ読み込む。
- リコールメモリ(Recall Memory):すべての会話履歴ログを完全に記録する。
Lettaは内部でGitに似たファイルとDiffの追跡機構を使ってメモリ変更を管理しており、長期間稼働し自己進化能力を持つ複雑なAgentの構築に適する。
Zep / Graphiti:双時間軸ナレッジグラフ
Zepとその基盤オープンソースエンジンGraphitiは、Agentメモリがグラフ理論と時系列推論へ進化する方向を代表する。Zepの中核的な判断はこうだ。従来のベクトル検索では、事実が時間とともに変化し衝突する問題を扱えない。たとえば「ユーザーは先月北京に住んでいて、今月上海へ引っ越した」というケースで、ベクトルマッチングだけを行うと、Agentは相反する2つの情報を同時に検索してしまい、LLMの幻覚を引き起こす。
Graphitiはグラフの各エッジ(関係)に正確なタイムスタンプ次元を与え、2層の時間を含める。「事実が有効な時間」(Valid-From / Valid-To)と「システムがその事実を学習した時間」(Learned-At / Expired-At)だ。新たな矛盾する事実を受け取っても、Graphitiは古いデータを単純に削除せず、グラフ内で旧エッジのValid-Toを失効状態としてマークし、同時に新しいエッジを張る。この双時間軸モデルは、ユーザーの現在の状態に答えられるだけでなく、歴史的な特定時点におけるシステムの認識を正確に答えられる。金融、法律、医療など、監査とトレーサビリティに厳格な要件がある企業シーンに非常によく合う。
LangMem:LangGraphと融合する三元メモリ
LangMemはLangChainチームが公開したもので、LangGraphの永続ストレージプリミティブ(BaseStoreとCheckpointer)と深くシームレスに連携することを目指す。メモリ抽象を3つの次元へ拡張する。
- セマンティックメモリ(Semantic Memory):ユーザーや環境に関する事実と嗜好を記録する。
- エピソードメモリ(Episodic Memory):Agentが過去に特定タスクを実行した成功経験と考えチェーンの軌跡(Execution Traces)を保存し、将来の少数ショット提示(Few-Shot Examples)として使う。
- プロシージャルメモリ(Procedural Memory / System Instructions):Prompt Optimizer APIを通じて履歴会話とユーザーフィードバックを分析し、AgentのSystem Promptを漸進的に最適化・書き換えする。
4つのオープンソースフレームワークの比較
| アーキテクチャ次元 | Mem0 | Letta (MemGPT) | Zep / Graphiti | LangMem (LangGraph) |
|---|---|---|---|---|
| 基盤データモデル | ベクトル埋め込み + JSON抽出事実 | 階層型State Blocks(Core/Archival) | 双時間軸ナレッジグラフ(Temporal Graph) | 三元メモリ(Semantic/Episodic/Procedural) |
| 検索ルーティング模式 | 意味的類似度(Vector Search) | ページング制御(Core常駐 + Archival検索) | ベクトル + ハイブリッドテキスト + グラフ走査(Graph Traversal) | 意味的マッチング + 少数ショット軌跡の想起 |
| 衝突と無効化のメカニズム | 書き込み時にLLMで原位上書き | AgentがToolを呼び手動編集しGit Diffを記録 | グラフエッジにタイムスタンプ失効をマーク(Valid-To) | バックグラウンドLLM PassでStore状態を整理・更新 |
| プログラム/行動の進化 | 事実データの更新に限定 | Core Memoryの変更でペルソナを変える | 高次のObservationルールを抽出 | Prompt Optimizerをネイティブ提供し命令を動的変更 |
| 典型的バックエンド適配 | 多様なVector DB(TiDB Vector含む) | PostgreSQL / Git-backed Store | Neo4j / FalkorDB / Zepクラウドサービス | LangGraph BaseStore(Redis/Postgres) |
| クラウド互換性 | クラウド中立、完全にクラウド横断 | クラウド中立、完全にクラウド横断 | クラウド中立、自建とZep Cloudを提供 | クラウド中立、LangGraphエコシステムに適合 |
マルチクラウド選定:データコンプライアンスとタスク複雑度で分流する
アーキテクチャ選定に万能の最適解はない。鍵となるのは、企業の既存技術スタックの蓄積、データコンプライアンス要件、業務タスクの複雑度だ。4つのシナリオに分けて考える。
金融・医療など高度に規制された業界:中核となる要求は、厳格なデータコンプライアンス境界とデータを一切持ち出さないことだ。中核業務データがすでにOracleデータベース環境に蓄積されているなら、Oracle AI Agent Memory(Oracle AI Database 23ai)が最も直接的な道だ。企業のSystem of Record上に直接、永続メモリ層を構築する。機密データを外部の第三者ストレージへ持ち出すことに伴うコンプライアンスリスクを避けつつ、データベースネイティブの行レベルセキュリティ、監査ログ、暗号化能力をそのまま継承できる。
AWSやGCP上に深く構築されたクラウドネイティブアプリ:マネージドメモリサービス(AWS Bedrock AgentCore MemoryまたはGCP Vertex AI Memory Bank)の採用は、基盤運用の負荷を最小化できる。こうした選択肢は事前定義された事実抽出と自動統合ロジックを備え、迅速な提供に適する。ただし導入の過程で、アーキテクトはアプリケーション層でテナント所有権の紐づけを明示的に実施し、テナントをまたぐ権限外のメモリ検索を防がなければならない。同時に、メモリ剪定の仕組みを設けて、バックグラウンドのLLM Consolidationによるtokenコストの膨張を抑える必要がある。
AWS、GCP、プライベートクラウド間で柔軟にデプロイする必要があるマルチテナントSaaSプラットフォーム:分散HTAPデータベースTiDB VectorとMem0またはLangMemを組み合わせてメモリ層を構築するのが、性能とクラウド横断の自由度を両立させる選択肢だ。TiDB Vectorは高並列の分散SQLとベクトルの複合検索能力を提供し、多数のオンラインAgentに低レイテンシのメモリCRUDを提供できるだけでなく、標準SQLで全量の過去メモリデータへ直接リアルタイム分析を実行できる。
複雑なサプライチェーン追跡、顧客状態の進展、法的リスク調査など、時系列ロジックに高度に依存するシーン:Zep/Graphitiの双時間軸ナレッジグラフがより適した選択肢だ。従来のベクトルデータベースは、頻繁に更新される事実情報に直面するとLLMの幻覚を引き起こしやすい。一方、双時間軸グラフは関係の有効化と失効の時刻を正確に記録し、Point-in-Time(時点)での履歴クエリをサポートする。厳格な監査が求められる業務シーンに、信頼できる進展の痕跡と説明可能性を提供する。
結論:「外部パッチ」から「内生的インフラ」へ
AI Agentのメモリシステムは、「外部パッチ(Bolt-on Layer)」から「深く内生したインフラ(Embedded Infrastructure)」へのアーキテクチャ転換を経験している。今後、注目すべき3つの中核トレンドがある。
第一に、時系列グラフとベクトル検索の深い融合。ベクトル類似度だけに依存するメモリ抽出機構は、双時間軸ナレッジグラフへ急速に近づいている。将来のエンタープライズデータベースとマネージドストレージエンジンは、時系列グラフ推論能力を深く内生させ、ベクトルマッチングと構造化グラフ走査の標準化された統合を実現する。
第二に、プロシージャルメモリと自律的最適化の普及。Agentメモリは静的なセマンティック事実の保存にとどまらず、過去の実行軌跡と成功経験(Episodic Memory)を大量に保存し、自動化ツールのフィードバックを通じてAgentのSystem Promptと行動戦略を継続的に修正し、真の自律的進化を実現するようになる。
第三に、メモリ制御プロトコルとインターフェースの標準化。Model Context Protocol(MCP)などのオープンな転送プロトコルの進化に伴い、Agentメモリの保存形式とアクセスインターフェースは統一へ向かっている。これにより、メモリデータが異なるクラウドプラットフォーム、マネージドサービス、Agentフレームワーク間を安全かつコンプライアンスに沿って流通・共有できるようになる。