
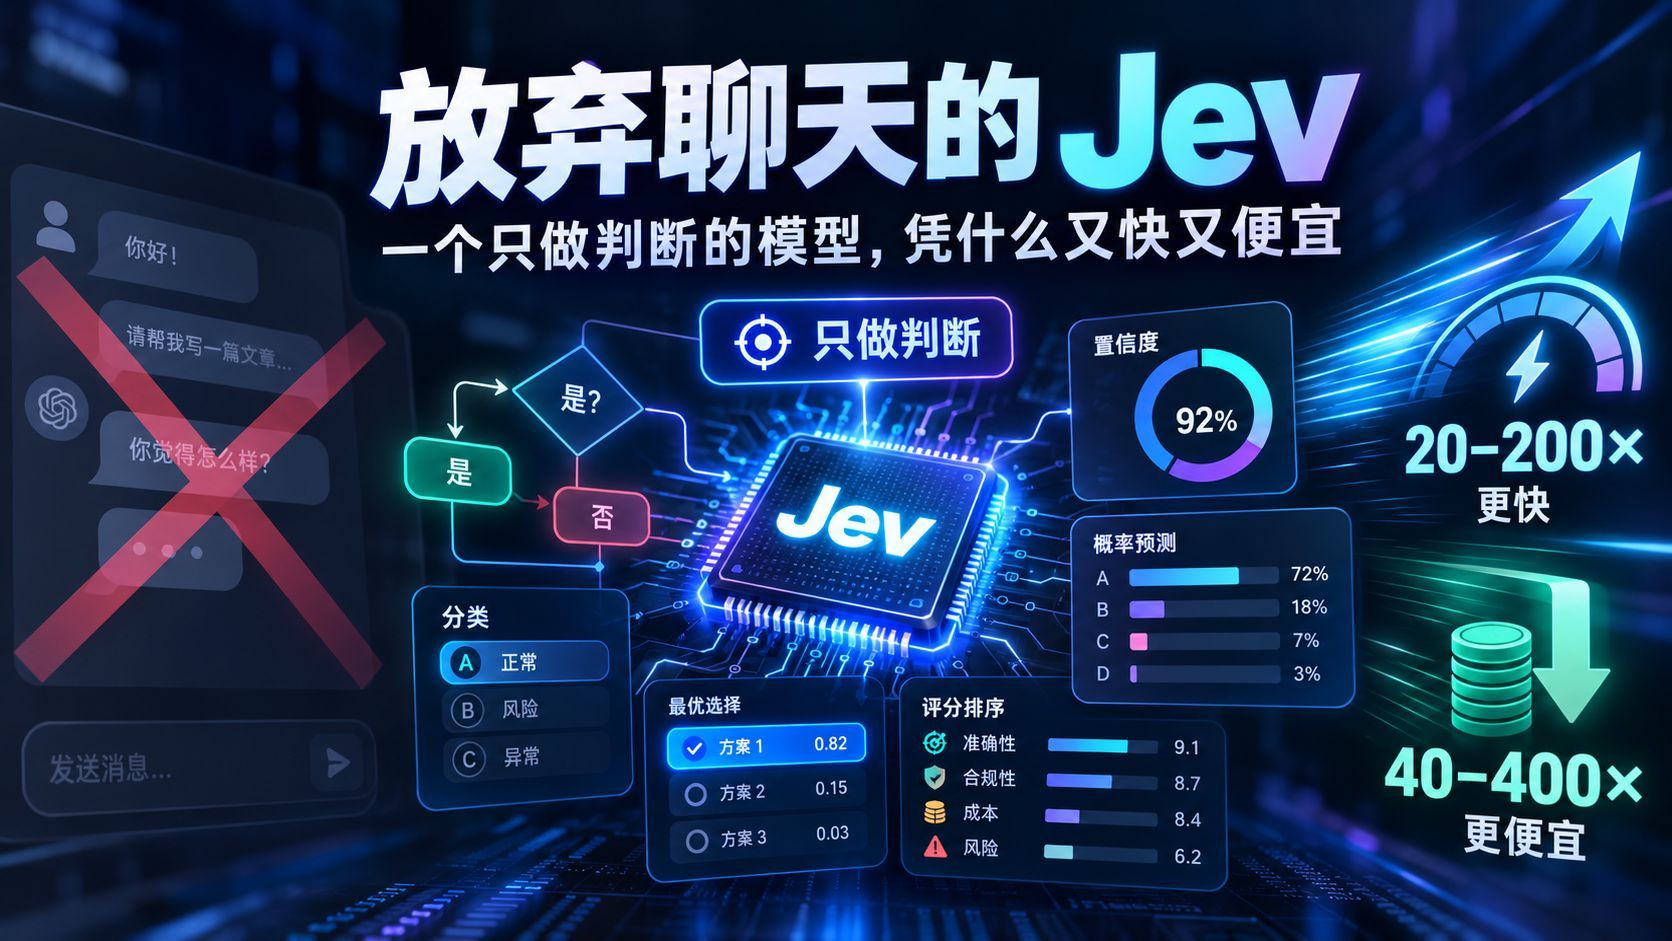
放弃聊天的 Jev:一个只做判断的模型,凭什么又快又便宜
TypeSafe AI 的新模型 Jev 不写文章,只返回判断和概率:官方测试中速度最高约为通用大模型的 193.6 倍,成本约为其 1/444.6,每百万输入 token 仅 0.042 美元,输出免费。它用 state 和 question 调用,以 Noul、Choice、Score 三种形式输出结果,并采用 RLCD 让概率直接用于自动分流,体现了判断、生成、执行的分工。

原文出处:JEV 为什么突然爆火 不会聊天,也不会写文章,Jev 为... https://xhslink.cn/o/9NWlow0VN9y 进入【小红书】发现更多内容~
放弃聊天的 Jev:一个只做判断的模型,凭什么又快又便宜
新模型 Jev 一发布,就拿出了很亮眼的成绩:速度做到通用大模型的 20 到 200 倍,成本却低了 40 到 400 倍。但这个模型不能陪你聊天,也不能给你写文章。作者去申请的时候,因为太火,官网一度停止注册。
那它到底靠什么做到又快又便宜?放弃了聊天之后,它还能做什么?
这个模式来自 TypeSafe AI。创始人 Diogo Almeida 是 InstructGPT 的共同作者之一——InstructGPT 教大模型听懂人的要求、按人的意思办事,也是后来 ChatGPT 的重要基础之一。离开 OpenAI 之后,他和团队花了两年的时间,做出了 Jev。
一、它只回答一件事:判断,以及判断的概率
先用一个小例子看它是怎么工作的。
小王邀请朋友来家里吃饭,菜刚上桌,朋友就到了。小王笑着说:“你可真会挑时间。”问一句:小王这句话是在表达不满吗?
把这个问题交给通用大模型,它会回答“不是”,后面再附上一段判断理由。同样的问题交给 Jev,回答只有一个字——“否”,以及这个结论成立的概率,没有任何多余的解释。
这就是 Jev 的设计目标:专门为软件里的结构化决策而生。你给它背景,告诉它要判断什么,再把允许的答案规定好,它返回结果和概率。调用方式也很简单,只需要两样东西:一个是 state(状态),就是你想让它分析的上下文信息;另一个是 question(问题),就是你想让它回答的问题。有了 question,你还要规定好它可以怎样回答。
目前 Jev 有 3 种回答形式:
- Noul:判断一句话成不成立,返回它成立的概率。刚才“小王是否在表达不满”就属于这一类。
- Choice:在预设选项里做选择,返回选中的选项、置信度以及各选项的概率分布。
- Score:按预设标准打分,比如一档到五档,返回分数和各档位的概率。
二、为什么更快更便宜:它不写作文,只在选项上算概率
看到这里你可能会问:我让大模型按照这个格式回答,不也行吗?当然行。但 Jev 要证明的是:同样做这些判断,它能不能更快、更便宜。
传统大模型的输出是一道问答题。它一个 token 一个 token 地把文本写出来;即使你只要求它回答“是”或“否”,它也要先生成文本,再按你约束的格式转换成答案。Jev 的做法完全不同:它围绕规定好的答案,直接在预定选项上输出概率分布,而不是逐字生成文本。
单看一道题,你可能感觉不到区别。但如果系统里有大量反复发生的判断——每一封邮件、每一条客服消息、每一次 Agent 操作——Jev 低耗时、高准确率的价值就会体现出来。按官方测试,它的速度最高约为通用大模型的 193.6 倍,成本约为其 1/444.6,每百万输入 token 收费 0.042 美元,输出免费。当然,官方也说明,并不是所有任务都能获得同样的提升。
三、关键在训练目标:从“让人满意”到“校准判断”
那 Jev 是怎么实现这个效果的?这要回到模型的训练目标上。
通用大模型常见的训练方式是 RLHF 和 RLVR。RLHF 是人类反馈强化学习,可以粗略地理解成:让人去比较几种回答,再根据这些反馈调整模型,让它学会什么样的回答更让人认可。RLVR 则用可验证的结果来奖励模型,比如算式有没有算对、写出来的程序能不能通过测试。
TypeSafe 把 Jev 的训练方式叫做 RLCD,即面向校准决策的强化学习。它既训练模型做判断,也训练模型给出与判断对应的概率。这个概率不只是告诉你哪个选项更可能,还希望告诉你到底有多大的可能。校准的意思是:在大量被模型赋予 80% 概率的判断中,实际发生的比例也应该接近 80%。所以这个概率数值可以直接使用。比如用来分流:判断客户有退款意愿的概率大约 80%,就自动处理;低于 50%,就转人工。
创始人为什么选这个方向?作者看了他在 YouTube 上的一段演讲,态度有些激进。他提出一个问题:为什么 AI 能解决很难的数学问题,客服里一些看似简单的决策却还是需要有人盯着?
这背后是“让人满意”和“自动运行”的区别。基于人类反馈的强化学习,从设计之初的目标就是贴合人的偏好。所以你跟 AI 聊天、让它帮你写代码,人始终都要在场:回答好不好,你可以判断,不满意还能让它改。但真正的自动化,最好是在后台一直运行,不用每一步都去检查。这就解释了 Jev 为什么这么重视决策:它希望模型除了给答案,还能把不确定性表达清楚,让软件据此决定——是继续执行,还是补充信息,还是交给人来处理。
四、它和传统分类器有什么不同
你可能还会问:传统的分类器机器学习不也能输出概率吗?Jev 有什么不一样?
区别还是在训练方式。过去常见的做法,是拿一批标好的垃圾邮件和正常邮件数据,训练一个专门识别垃圾邮件的模型;它通常围绕固定任务训练,换了业务场景或标签,往往需要重新标注数据、重新训练。Jev 不一样的地方在于,它仍然具备大模型式的语义理解和泛化能力,开发者可以用提示词描述不同的判断任务,不必为每个新任务重新训练模型。
五、用在哪里:软件里能读懂上下文的“智能分支”
虽然 Jev 不能聊天,但它的适用场景不少,这也是它能活下来的原因之一。可以把它想象成软件里一个能读懂上下文的智能分支语句:需要判断决策的场景都可以使用。
- 做消息分类;
- 给大模型做内容质检;
- 对大模型生成的内容打分;
- 做 Agent 的决策中间层,判定该用哪个工具、判断操作风险等。
GitHub 上已经有很多项目接入了它,也出现了不少好玩的玩法。
Browser Use 团队做了一个浏览器 Agent:7.1 秒就在 Google Flights 上搜完一次航班,成本只有约 0.003 美元。Jev 负责选择要操作哪个页面元素;需要输入文字的时候,再交给一个小语言模型生成。
还有一个微信回复助手:它读取电脑屏幕上的聊天文字,让 Jev 判断对方的意图和情绪;再配合大模型起草三条回复,用 Jev 排序;你选中其中一条,就能填进微信输入框。
更好玩的是一个博物馆潜入游戏:玩家可以换装、拿证件、制造声响;保安收到周围的动静后,让 Jev 判断这个人可不可疑、有没有威胁,接下来再决定采取什么行动。
六、怎么拿到 API Key
因为前面说的太火,官网一度暂停注册。除此之外,还可以通过 OpenRouter 或 Vercel AI SDK 获得。最简单的方式是通过官方的 Playground:左侧填入上下文和问题,右侧看结果。
七、它会替代大模型吗
前面这些项目其实已经给了一个答案:它们在尝试做分工——Jev 做判断,大模型生成文字,普通程序执行操作。
也有评论把它看成是能力与效率之间的一种取舍。过去大家都在追求更高的智能,对“能力够用、输出很短、想要很快”这个方向投入不足;Jev 受到关注,说明这种需求一直存在。
TypeSafe 把 Jev 这类模型叫做 System 1 Model,灵感来自丹尼尔·卡尼曼的《思考,快与慢》。卡尼曼把人的思考方式分成系统一和系统二:系统一快速、自动、凭直觉;系统二需要集中注意力,一步一步分析。Agent 也需要知道,哪些事情需要快判断,哪些事情需要慢推理。
或许我们看 AI 时,常常问它能解决多难的问题;到了 Agent 真正替人做事的时候,还得再问一句:它能不能把时间和算力花在真正需要的地方。