
チャットを捨てた Jev:判断だけに特化したモデルは、なぜ速くて安いのか
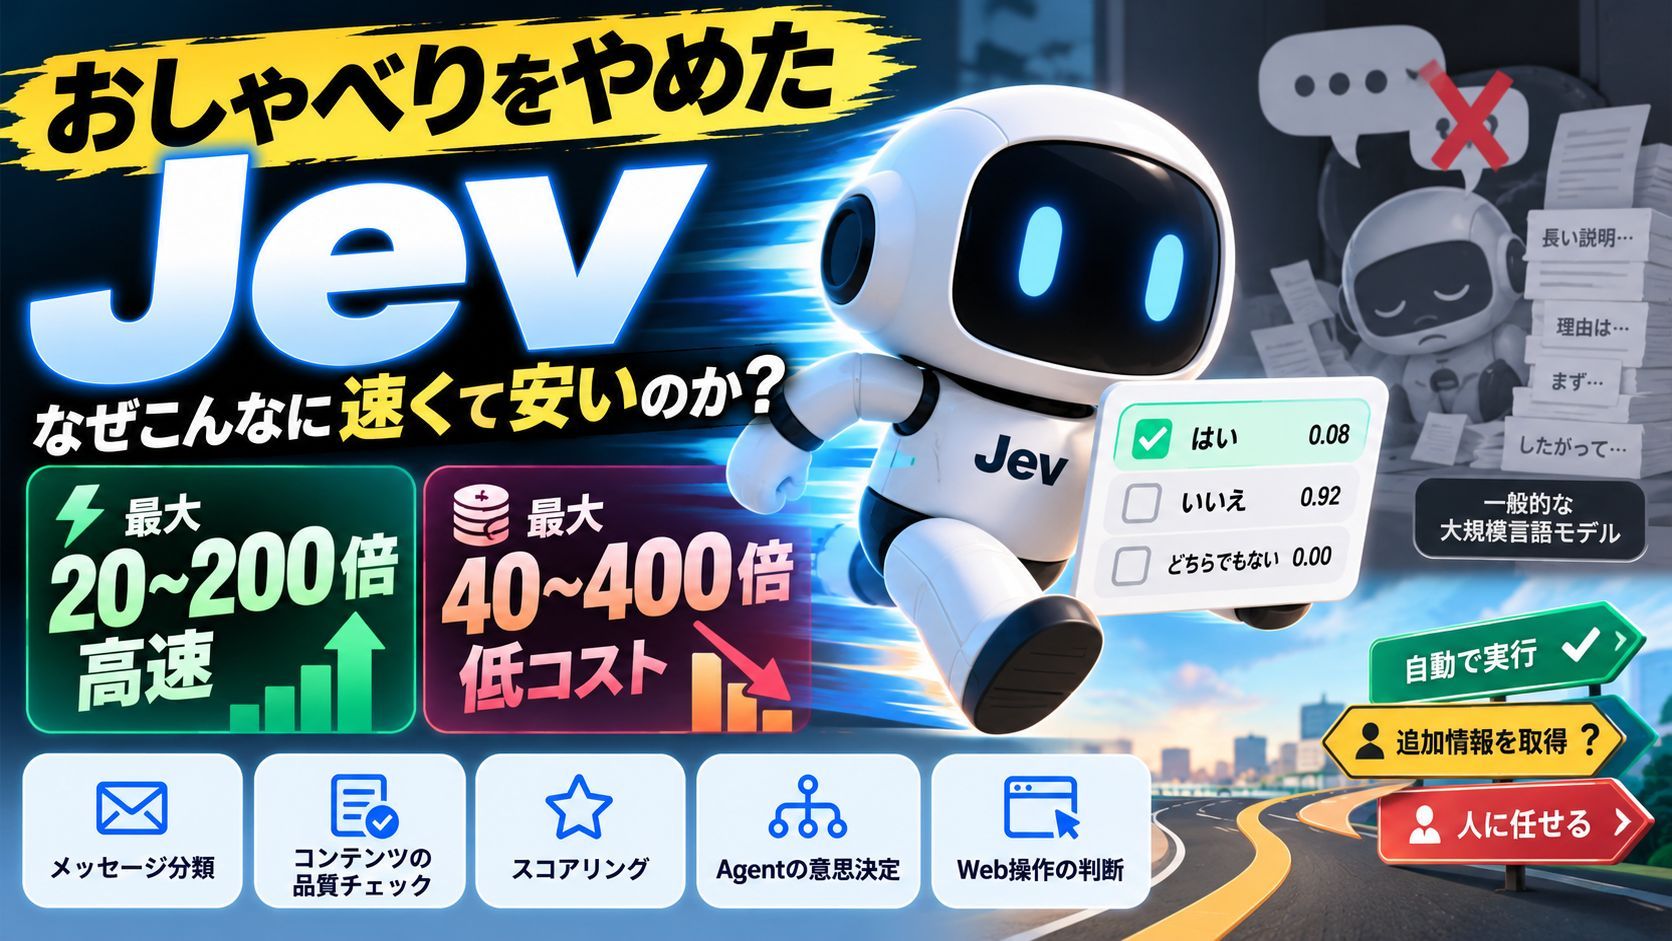
TypeSafe AI の新モデル Jev は文章を生成せず、判断とその確率だけを返す。汎用 LLM より最大 193.6 倍速く、コストは約 444.6 分の 1、入力 100 万トークン 0.042 ドル、出力は無料。state と question を渡し、Noul・Choice・Score の 3 形式で答える。RLCD で較正された確率は、そのまま分流の閾値に使える。判断・生成・実行の分業を担う System 1 モデル。

チャットを捨てた Jev:判断だけに特化したモデルは、なぜ速くて安いのか
新しいモデル Jev は、公開されるやいなや非常に目覚ましい成績を打ち出しました。速度は汎用の大規模モデルの 20〜200 倍、コストは 40〜400 分の 1 です。しかしこのモデルは、あなたと雑談することもできなければ、記事を書くこともできません。筆者が申し込もうとしたときには、人気が集中したために公式サイトの新規登録が一時停止していました。
では、いったい何によって速く、安くしているのか。チャットを諦めたあと、何ができるのか。
このモデルを生んだのは TypeSafe AI です。創業者の Diogo Almeida は InstructGPT の共同開発者の一人で、InstructGPT は大規模モデルに人間の要求を理解させ、指示どおりに動かすことを教えるもので、後の ChatGPT の重要な土台の一つにもなりました。OpenAI を離れたあと、彼とチームは 2 年をかけて Jev を作り上げました。
一、返すのは判断と、その確率だけ
まず小さな例で、どのように動くのかを見てみましょう。
王さんが友人を家に招いて食事をしていました。料理がちょうど食卓に並んだところで友人が到着します。王さんは笑いながら「よくタイミングを見計らったね」と言いました。さて、王さんのこの一言は不満を表しているでしょうか。
この質問を汎用の大規模モデルに投げると、「いいえ」と答えたうえで、その判断理由を続けて説明します。同じ質問を Jev に投げると、返ってくるのは「否」という一言と、その結論が成り立つ確率だけです。余計な説明は一切ありません。
これが Jev の設計目標です。ソフトウェアの構造化された意思決定のために作られています。背景を渡し、何を判断してほしいかを伝え、許される答えを決めておくと、結果と確率を返します。呼び出し方も非常に簡単で、必要なものは二つだけです。一つは state(状態)、つまり分析してほしい文脈情報です。もう一つは question(質問)、つまり答えてもらいたい問いです。question があれば、どのように答えられるかを決めておく必要があります。
現在 Jev には 3 種類の回答形式があります。
- Noul:ある文が成り立つかどうかを判断し、それが成り立つ確率を返します。先ほどの「王さんは不満を表しているか」はこの種類です。
- Choice:あらかじめ用意した選択肢から選び、選んだ選択肢、信頼度、各選択肢の確率分布を返します。
- Score:決められた基準で採点します。たとえば 1〜5 段階で、点数と各段階の確率を返します。
二、なぜ速くて安いのか:文章を書かず、選択肢の上で確率を計算する
ここまで見て、こう思うかもしれません。大規模モデルにこの形式で答えさせればいいのでは、と。もちろんそれも可能です。しかし Jev が示そうとしているのは、同じ判断をするときに、より速く、より安くできるかどうかです。
従来の大規模モデルの出力は問答形式です。トークンを一つずつ書き出していきます。たとえ「はい」か「いいえ」だけを答えさせても、いったんテキストを生成し、それを指定された形式に変換してから出力します。Jev のやり方はまったく違います。決められた答えを中心に、あらかじめ用意した選択肢の上で直接、確率分布を出力するのです。一文字ずつテキストを生成するのではありません。
一問だけを見れば、違いは感じられないかもしれません。しかしシステムの中に、繰り返し発生する判断が大量にあるなら——メール一通ごと、カスタマーサポートのメッセージ一件ごと、Agent の操作一回ごとに——Jev の低遅延・高精度という価値が効いてきます。公式のテストでは、速度は汎用の大規模モデルの最大約 193.6 倍、コストは約 444.6 分の 1 で、入力は 100 万トークンあたり 0.042 ドル、出力は無料です。もちろん、すべてのタスクで同じ改善が得られるわけではない、と公式も注記しています。
三、鍵は学習目標:「人を満足させる」から「判断を較正する」へ
では Jev はどうやってこの効果を実現しているのか。ここでモデルの学習目標に戻ります。
汎用の大規模モデルでよく使われる学習方法は RLHF と RLVR です。RLHF は人間のフィードバックによる強化学習で、ざっくり言えば、人に複数の回答を比較してもらい、そのフィードバックに基づいてモデルを調整し、どんな回答がより人に受け入れられるかを学ばせるものです。RLVR は検証可能な結果でモデルに報酬を与えます。たとえば計算式が正しく解けたか、書いたプログラムがテストを通るか、といったものです。
TypeSafe は Jev の学習方法を RLCD、すなわち較正された意思決定のための強化学習と呼んでいます。判断を下すことと、その判断に対応する確率を出すことの両方を学習します。この確率は、どの選択肢がより可能性が高いかを教えるだけでなく、どれほど可能性が高いのかまで教えようとします。較正とは、モデルが 80% の確率を付けた判断が大量にあるとき、実際にそれが起こる割合も 80% に近づくことを意味します。だからこの確率の数値をそのまま使えます。たとえば振り分けに使えます。顧客に返金の意思がある確率がおよそ 80% なら自動処理し、50% を下回るなら人に回す、という具合です。
創業者はなぜこの方向を選んだのか。筆者は彼の YouTube での講演を見ましたが、その姿勢はやや過激でした。彼はこう問いかけます。なぜ AI は難しい数学の問題を解けるのに、カスタマーサポートの一見簡単な意思決定には、まだ人が見張っていなければならないのか。
その背後には「人を満足させること」と「自動で動くこと」の違いがあります。人間のフィードバックに基づく強化学習は、設計の当初から人の好みに合わせることが目標でした。だから AI とチャットしたり、コードを書かせたりするときには、人は常にその場にいる必要があります。回答がよいかどうかは自分で判断できますし、不満なら直させることもできます。しかし本当の自動化は、バックグラウンドで動き続け、いちいち確認しなくてもよいのが理想です。Jev が意思決定をこれほど重視する理由がここにあります。モデルには答えを出すだけでなく、不確実性をはっきり表現してほしい。ソフトウェアはそれに基づいて、そのまま実行を続けるのか、情報を補うのか、人に渡すのかを決められます。
四、従来の分類器との違いは何か
もう一つ疑問が浮かぶかもしれません。従来の分類器による機械学習も確率を出せるのではないか。Jev とは何が違うのか。
違いはやはり学習方法にあります。これまでよくあったのは、ラベル付けされたスパムメールと正常なメールのデータを使い、スパムを識別する専用モデルを訓練するやり方です。これは通常、固定されたタスクを中心に訓練されるため、業務の場面やラベルが変わると、データを集め直して再学習する必要があります。Jev が違うのは、大規模モデル並みの意味理解と汎化の能力を持ち、開発者がプロンプトでさまざまな判断タスクを記述でき、新しいタスクごとにモデルを再学習しなくてよい点です。
五、どこで使うのか:ソフトウェアの中の、文脈を読める「賢い分岐」
Jev はチャットできませんが、応用できる場面は少なくありません。それが生き残れる理由の一つでもあります。ソフトウェアの中にある、文脈を読める賢い分岐文だと考えてみてください。判断や意思決定が必要な場面ならどこでも使えます。
- メッセージの分類
- 大規模モデルのコンテンツ品質チェック
- 大規模モデルが生成した内容の採点
- Agent の意思決定の中間層として、どのツールを使うかの判定や操作リスクの判断など
GitHub ではすでに多くのプロジェクトがこれを取り入れており、面白い使い方も登場しています。
Browser Use チームはブラウザ Agent を作りました。Google Flights で一度のフライト検索を 7.1 秒で終え、コストはわずか約 0.003 ドルでした。Jev はどのページ要素を操作するかを選び、文字入力が必要な場面では小さな言語モデルに生成を任せます。
微信(WeChat)の返信アシスタントもあります。パソコンの画面上のチャット文字を読み取り、Jev が相手の意図と感情を判断します。さらに大規模モデルと組み合わせて三つの返信を起草し、Jev が順位を付けます。その中から一つを選べば、WeChat の入力欄にそのまま入れられます。
さらに遊び心があるのは、博物館への潜入ゲームです。プレイヤーは着替えたり、証明書を手に入れたり、物音を立てたりできます。警備員が周囲の物音を察知すると、Jev にこの人物が疑わしいか、脅威があるかを判断させ、次にどの行動を取るかを決めます。
六、API キーの入手方法
前述のとおり人気が集中したため、公式サイトは一時的に新規登録を停止していました。それ以外では、OpenRouter や Vercel AI SDK から入手できます。最も簡単な方法は公式の Playground です。左側に文脈と質問を入力し、右側で結果を確認します。
七、大規模モデルを置き換えるのか
ここまでのプロジェクトが、すでに一つの答えを示しています。彼らは分業を試みています。Jev が判断し、大規模モデルが文章を生成し、普通のプログラムが操作を実行する、という形です。
能力と効率の間のトレードオフだと評する声もあります。これまでは誰もがより高い知能を追求してきましたが、「能力は十分で、出力は短く、とにかく速く」という方向への投資は不足していました。Jev が注目されたことは、そうした需要がずっと存在していたことを示しています。
TypeSafe は Jev のようなモデルを System 1 Model と呼んでいます。着想はダニエル・カーネマンの『ファスト&スロー』から来ています。カーネマンは人の考え方をシステム 1 とシステム 2 に分けました。システム 1 は速く、自動的で、直感によるもの。システム 2 は注意を集中して、一歩ずつ分析するものです。Agent もまた、どの物事を速く判断し、どの物事をゆっくり推論すべきかを知る必要があります。
私たちは AI を見るとき、それがどれほど難しい問題を解けるかをよく尋ねます。しかし Agent が本当に人のために動く段階になると、もう一つ尋ねる必要があります。それは、時間と計算資源を、本当に必要な場所に使えるのか、と。