
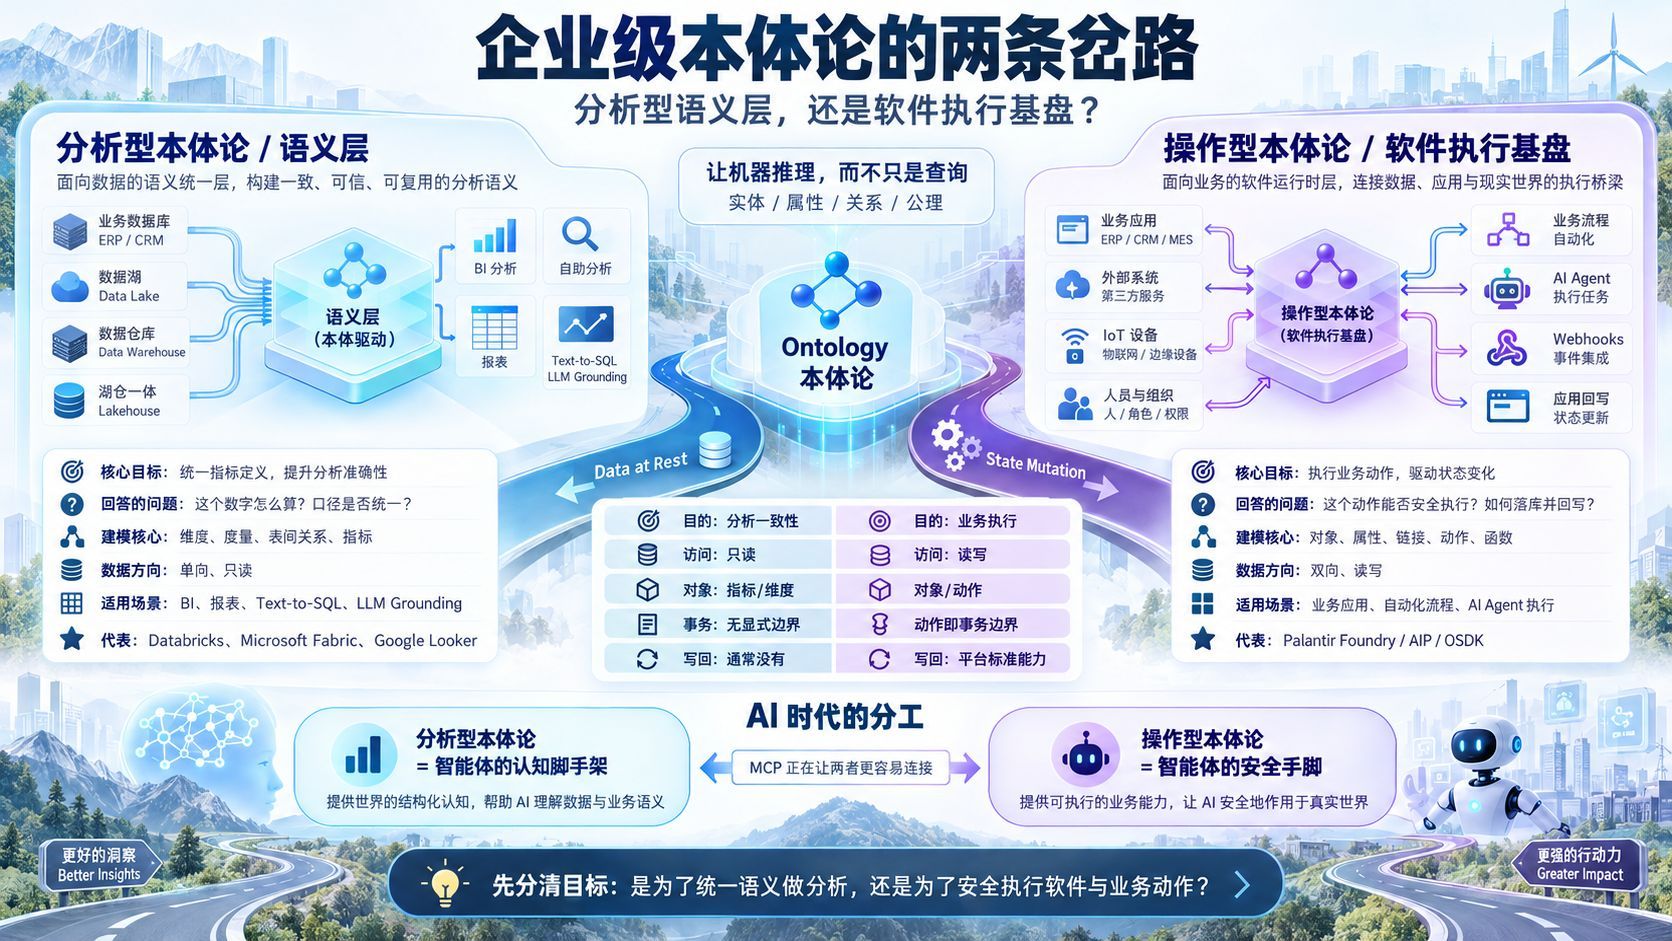
企业级本体论的两条岔路:分析型语义层,还是软件执行基盘
本体论在企业 IT 中分化为两条路线。分析型语义层统一指标定义,以只读方式支撑 BI、Text-to-SQL 与 LLM 的上下文接地;操作型本体论则把状态变更事务、事前校验、外部系统写回与类型安全的 OSDK 代码生成整合成业务应用的执行基盘。Databricks、Microsoft、Google Cloud 的能力本质上是前者的延伸,Palantir 则是后者的代表,并以 CQRS 与决策血缘实现企业级读写分离。本文梳理两者的结构差异、AI 智能体时代的分工,以及企业架构选型矩阵。

企业级本体论的两条岔路:分析型语义层,还是软件执行基盘
当一位企业架构师说「我们要建一套本体论(Ontology)」时,他指的是什么?这个看似简单的问题,在过去十几年里已经分裂出两个几乎不相干的答案:一边是让数据和指标说得清、算得准的分析型语义层,另一边是让业务对象能被程序安全地读写、驱动状态变化的操作型本体论。同为「本体论」,前者最终长成了 BI 与数据分析的底座,后者却长成了软件开发与运行平台。理解这条分水岭,比记住任何一家厂商的产品清单都重要。
一、本体论的原义:让机器「推理」,而不是「查询」
计算机科学与知识工程里的 ontology 脱胎于哲学上的存在论,但它被信息系统接受的方式很技术化。Tom Gruber 给出的经典定义是:本体论是「概念化的显式规范」(an explicit specification of a conceptualization)。这里的「概念化」,是对某个领域内被假定的实体(Entity)、其性质与属性(Property)、实体之间的关系(Relation),以及从逻辑上约束它们的公理(Axiom)所做的一次系统化抽象。
1990 年代到 2000 年代,W3C 的语义网构想把它形式语言化,产出了 RDF、RDFS 和 OWL。这一脉络中,本体论的核心能力是两件事。第一是基于描述逻辑(Description Logics)的演绎推理:从形式化的知识结构中自动导出新的逻辑真伪与分类。第二是开世界假设:没有被描述的信息不被当作「假」,而是当作「真伪不明」。也就是说,它的目标一开始就不是把数据查出来,而是把知识放进一个能自动推论的体系里。
二、进入企业之后:为什么严格公理走不进生产系统
学术研究追求强推理与普遍的知识共享,产业界的企业 IT 则要为可用性买单。在真实的企业数据基盘上全面套用 OWL 那套严格公理,会带来三个直接后果:计算量急增、事务性能劣化、模式(Schema)演进变得僵硬。理想很完整,但代价无法承受。
于是,企业信息系统里的「本体论」被重新诠释,并分成了两大潮流。
第一条潮流,是从商业智能(BI)、数据仓库和数据湖仓的演进中派生出来的分析型语义层(Analytical Semantic Layer)。它的做法是把物理的关连表与分布式存储的连接关系藏到后面,把业务指标(KPI)的计算逻辑和维度集中管理,从而向分析师和报表工具投射出一套一致的「意义」。它回答的是「这个数字到底怎么算、口径是不是全公司统一的」。
第二条潮流,是以业务运营执行和定制应用构建为主旨的操作型本体论(Operational Ontology)。它把现实世界的业务实体抽象成带有行为(Behavior)的数字对象,把状态迁移、事务一致性、与外部系统的双向写回一并纳入,成为软件开发的后端。它回答的是「这个业务动作能不能被安全地执行、执行完怎么落库、怎么回写到别的系统」。
前者的进化轴上站着 Databricks、Google Cloud、Microsoft 的一系列数据平台;后者的代表是 Palantir。这两条路线并非同一件事的深浅之分,而是设计目标的分歧。
| 分类潮流 | 起源与主要影响 | 主要目的 | 数据操作性 | 代表技术 |
|---|---|---|---|---|
| 知识工程/学术型 | 人工智能、语义网、数理逻辑 | 知识共享、概念分类、逻辑演绎推理 | 静态模型(公理定义) | W3C OWL, RDF, Protégé, SPARQL |
| 分析型(语义层) | BI、数据仓库、指标层 | 统一指标定义、自动生成查询、探索分析 | 原则上只读(面向分析的投射) | LookML, dbt Semantic Layer, Databricks Metric Views, Fabric IQ |
| 操作型(业务执行/应用基盘) | 面向对象设计、DDD、分布式事务 | 业务自动化、应用开发、闭环控制 | 读写(双向回写、状态迁移) | Palantir Foundry / AIP, OSDK |
三、Palantir:把本体论做成一个分布式对象运行时
Palantir(Foundry 与 AIP)提供的 Ontology,与一般数据仓库或 BI 工具提供的语义层有本质区别。它在官方架构里被定义为「组织的手术层(Operational Layer for the organization)」。用该公司 10-K 和设计规范里的话说:一般的本体论停留在「对数据做体系化的语境映射」,而它自己的 Ontology 是「把决策中的数据、逻辑和行动整合成企业的基础表达」。
它的设计意图是给企业造一个动态数字孪生。它坐在物理数据集、虚拟表和机器学习模型之上,把产线、飞机、维修件、客户、供应商这些现实实体具象化为「对象」。所以在 Palantir 眼里,本体论不是一张用来可视化数据的静态图,而是一个能「做决策、并把结果落回业务」的动态执行基盘。
名词与动词:静态语义与动态行为
Palantir Ontology 的内部结构被整理成类似自然语言的「名词」与「动词」模型,这和软件工程里的面向对象编程(OOP)与领域驱动设计(DDD)在结构上是对应的。
名词,也就是静态语义要素,包括四类:对象类型(Object Types)是现实实体或事件的模式定义;属性(Properties)规定其字段;链接类型(Link Types)以图结构承载对象之间一对一、一对多、多对多的关系;接口(Interfaces)则是对多个不同对象类型强制统一行为与数据形状的抽象层,本质就是软件设计里的接口模式。
动词,也就是动态要素(Kinetic Elements),由动作类型(Action Types)和函数(Functions)组成。函数是用 TypeScript 或 Python 写的计算逻辑,接收对象或对象集作为输入,做派生值计算和校验。而真正把 Palantir 从纯数据基盘升格为软件开发基盘的,是动作类型。
动作、事务边界与副作用
在 Palantir 中,一个动作(Action)被定义为「基于用户定义逻辑,修改一个或多个对象属性的一笔单一事务」。动作类型把四个组成部分紧紧绑在一起:
- 参数(Parameters):带类型的输入值,也可以直接把对象本身作为参数接收。
- 规则(Rules):指定新建对象、修改已有对象、删除、建立或删除链接这些基本操作;复杂逻辑则调用函数。
- 提交条件(Submission Criteria):在动作执行前做业务校验,把违反业务策略的非法状态变更挡在事务开始之前。
- 副作用(Side Effects):动作确认时执行的外部联动处理,例如发通知、调用 Webhook。
它的事务边界和数据持久化方式很有特点。用户执行动作时,修改并不会直接写回支撑对象的原始数据集。变更指令先进入一个叫「漏斗(Object Data Funnel)」的排队与索引服务,再以低延迟记录到对象数据库(Object Storage v2 或 Phonograph)的索引和写回数据集(Writeback Dataset)中。这样一来,分析用的原始数据不会被污染,对象层又能保证毫秒级的读写。
在与外部核心系统的整备上,「写回 Webhook(Writeback Webhooks)」会在 Ontology 内部对象变更发生之前先行执行。只有对 SAP 等 ERP、Salesforce 等 CRM 的 API 调用成功了,Foundry 内的对象更新才会提交,从而在外部系统和 Foundry 之间维持一种实用的分布式事务一致性。与之相对,还有在动作执行后异步、尽力而为处理的「副作用 Webhook(Side-effect Webhooks)」,让团队可以按业务要求做不同的容错设计。
OSDK:让 Foundry 变成无头 BaaS
Palantir 被视为开发基盘的决定性原因,是 Ontology SDK(OSDK)的存在。OSDK 从集中建模的 Ontology 中抽出某个应用边界所需的类型定义,为 TypeScript、Python、Java 自动生成完全类型安全的客户端 SDK。
传统企业开发里,开发者得自己配数据库连接、搭 ORM、写 SQL/REST 包装、再实现一套访问控制。而在采用 OSDK 的架构里,Foundry 本身就充当一个无头(headless)的 BaaS:前端开发者只调用生成的类型安全 API,认证、授权、行列级安全、事务校验、审计日志都在背后自动生效。
再往上,无论是低代码搭业务应用的 Workshop、做事件驱动流程自动化的 Automate,还是把 LLM 与带类型的对象和动作直接对接的 AIP Logic,所有平台功能都共用 Ontology 作为运行时对象模型。换句话说,Palantir 的 Ontology 不是分析的终点,而是快速、可靠地组装企业软件的「分布式面向对象操作系统」。
四、三大云厂商:本体论现在住在哪里
如果不把「分析型语义层」当成本体论,就会误解云厂商的产品。它们的本体论能力,基本都指向分析与上下文接地(Grounding)。
Databricks:Unity Catalog Semantics 与 Genie Ontology
Databricks 的路线是从湖仓架构上的治理元数据出发,向自然语言分析和智能体接地扩展。核心是 Unity Catalog Semantics 与 Genie Ontology。
Unity Catalog Semantics 给目录里的表和视图附上以人为中心的业务逻辑。指标视图(Metric Views)把 KPI(聚合数值与分析轴)定义为可复用的 SQL 对象,执行查询时动态展开 SQL,从而保证不同分析工具算出来的结果一致。域(Domains)按业务组织或目的对数据资产做逻辑分组;页面(Pages)记录业务术语的权威定义,成为 AI 工具参照的正确上下文;认证与非推荐标记则显式说明组织官方背书的数据资产是哪些。
架在这层人工建模之上的是 Genie Ontology。它为 Databricks Genie(自然语言分析智能体)提供业务上下文,是一个统一的上下文求解引擎。它不只是一本静态定义词典,还会从组织内的查询日志、表间连接历史、使用频率这些实际使用情况中,用名为 Ontorank 的算法动态推断并加权上下文。
但 Databricks 的本体论本质上是为「高级只读分析」和「提升 Text-to-SQL 精度」服务的语义基盘。Unity Catalog 管理的主键、外键约束在很多情况下仍只是信息性的(Informational),并没有把 Palantir 那种带事务的动作执行、副作用控制、数据写回的应用执行层装进去。
Microsoft:从 Azure Digital Twins(DTDL)到 Fabric IQ Ontology
Microsoft 的本体论是两条脉络在融合:一条来自 IoT 与空间建模,另一条来自以 Power BI 和 Fabric 为中心的数据分析。
历史上,它面向 IoT 和智能楼宇制定了 DTDL(Digital Twins Definition Language),在 Azure Digital Twins 上对物理资产的关系与遥测建模。DTDL 除了遥测、属性、关系,还能定义命令(Command),从 IoT 设备控制的角度看,确实带有一点运营性格。
而最新的企业数据平台战略落在 Microsoft Fabric IQ 的「本体论(Ontology item,预览)」。Fabric IQ 是在 OneLake 上构建业务语义模型的工作负载:它把实体类型、属性、关系从物理表里脱开定义,支持继承与命名空间复用。本体论定义本身不持有数据,而是虚拟地绑定(Data Binding)到 OneLake 里的 Lakehouse、Warehouse、Eventhouse,或者 Power BI 语义模型。它还能直接继承既有 Power BI 语义模型里定义的 DAX 度量作为本体论指标;需要多跳路径查找时,则投影到 Fabric Graph 执行引擎查询。
Fabric IQ 的本体论可以通过与 Fabric Activator 的集成,定义一部分「按条件触发告警」这类偏运营的动作;但从系统整体架构看,它更像「为分析可视化引擎和 Data Agent 提供业务上下文的层」。数据的物理持久化和事务处理交给下层存储,本体论本身并不直接充当定制应用的有状态后端。
Google Cloud:LookML、Knowledge Catalog 与 Spanner / BigQuery Graph
GCP 的本体论式做法不是推出一个叫 Ontology 的统一产品,而是把分析语义层、元数据治理和原生图数据库技术松散地组合起来。
分析语义层的中枢是 Looker 的 LookML。它把维度、度量、关系声明为代码,动态生成 SQL,是语义层的元祖,也被定位成把 Gemini 等生成式 AI 接地到业务指标上的管控基盘。
数据治理方面,原来的 Dataplex 演进为 Google Knowledge Catalog,承担技术元数据、业务词汇表、数据质量规则和血缘(Lineage)的统一管理。
更高级的关系建模由 Spanner Graph 和 BigQuery Graph 提供。它们支持国际标准 ISO GQL(图查询语言),可以对关系型数据直接套用属性图模型。一个值得注意的设计模式是,Yahoo 等先行案例提出双结构:用 Spanner Graph 记录运营意义上的真相(Operational Truth),用 BigQuery Graph 作为积累决策历史与审计血缘(Decision Lineage)的上下文图。
可以看出,GCP 提供的是极其坚固的基础组件——分布式事务引擎、数据仓库、语义 BI;但把「业务对象的行为」和「写回事务」一并统一抽象的应用层本体论框架并不存在,集成工作留给使用企业自己开发。
五、两种本体论的结构性对比
把各家的概念摊在一起看,分析型本体论与操作型本体论之间,存在一道关于数据架构根本的思想断层。
分析型本体论,是给数据仓库或数据湖里的「静止数据(Data at Rest)」赋予意义。它关心的是计算逻辑的统一(让全公司对「销售额」的定义一致)和查询生成的效率。数据流基本是单向的:从存储到看板,或者作为提示上下文喂给 LLM,前提是只读。
操作型本体论则面向业务的「动态状态变化(State Mutation)」和流程的闭环控制。它把数据仓库持有的聚合数据与 ERP、CRM 等核心业务系统持有的事务数据整合成对象,把用户或智能体做出的决策(Action)立即反映为状态,并写回外部系统。
两者的数据流差异很直观。分析型本体论在物理数据存储之上放一个虚拟语义层,查询发生时动态展开成 SQL,单向地被 BI、报表、LLM 消费。操作型本体论则不然:数据不仅从核心系统和物理存储同步到对象层,当应用或 AI 智能体对动作层执行事务时,会经由 Funnel 服务即时反映到对象层,同时通过 Webhook 等双向写回外部核心系统,形成一个闭环。
| 比较项 | 分析型本体论 / 语义层 | 操作型本体论 |
|---|---|---|
| 主要厂商与技术 | Databricks(Unity Catalog, Genie);Microsoft(Fabric IQ);Google Cloud(LookML, Dataplex) | Palantir(Foundry Ontology, AIP, OSDK) |
| 主要设计目的 | 保证指标计算一致、提升 Text-to-SQL 精度、探索分析 | 执行业务运营、构建定制应用、闭环自动化 |
| 建模核心 | 维度、度量(聚合函数)、表间连接 | 对象、属性、链接、动作、函数 |
| 数据访问方向 | 单向、只读(生成分析查询) | 双向、读写(编辑对象并回写源系统) |
| 事务边界 | 不存在(依赖查询引擎侧的 ACID 特性) | 以动作为单位,显式管理事务边界与事前校验 |
| 写回(Writeback) | 无(需另配反向 ETL 或调度器) | 平台标准能力(Funnel 服务、Writeback Webhooks) |
| 软件开发体验 | BI 开发、SQL 查询、看板嵌入、REST 查询 | OSDK 生成完全类型安全的客户端 SDK,可当 BaaS 用 |
| 变更追踪与审计 | 数据血缘(表/列级转换历史) | 决策血缘(谁、何时、基于哪个数据版本执行) |
| 主要终端用户 | 数据分析师、BI 工程师、信息查阅型业务层 | 一线操作员、全栈工程师、执行业务的 AI 智能体 |
CQRS 与决策的持久化
换到软件设计论的视角,Palantir 的特点是把企业规模的 CQRS(Command Query Responsibility Segregation,命令查询职责分离)实现在平台层。
分析型语义层只承担 CQRS 里「查询(读模型)」的优化。Palantir 则把查询(由 Object Set Service 提供低延迟检索与聚合)和命令(由 Actions Service 与 Funnel 完成写入和副作用执行)彻底分开,并分别为两者分配优化过的存储和校验流水线。
更值得注意的是它「决策的持久化(Decision Capture / Decision Lineage)」的思路。传统数据基盘里,人看完分析看板做出判断,再用邮件传达或在核心系统里手工录入,于是「这个决定是基于什么数据上下文做出的」这类语境信息就丢失了。而在操作型本体论中,所有动作都经过 Ontology,决策的参数、执行者、所参照的对象版本,以及由此产生的状态变化,会被记录成不可分割的审计日志(Action Log),并作为可供再学习的数据资产积累下来。
六、生成式 AI 与智能体时代:认知的脚手架与安全的手脚
生成式 AI 和自主智能体的兴起,反而扩展了本体论的存在意义。单一的 LLM 既无法理解业务语境(会幻觉),也没有对外部世界施加副作用的安全手段。在这个语境下,分析型与操作型本体论对智能体而言是互补而分工不同的。
分析型本体论(如 Databricks Genie Ontology、Fabric IQ)是智能体的「认知与推理脚手架(Grounding Context)」。当智能体接到一个业务询问时,Unity Catalog 的 Metric Views 和 Pages 介入其中,让它不必自己编造不准确的 SQL,而是用组织认可的公式和连接条件生成准确回答。
操作型本体论(如 Palantir AIP)则提供智能体的「安全的手脚(Tool Use / Action Space)」。如果智能体要自主决策,例如「为防止缺货而向供应商追加下单」,那么允许它对原始数据库发 UPDATE,或者无限制地调用 API,都会带来灾难性的系统风险。在操作型本体论里,暴露给智能体的只有内置了前置条件、类型定义、授权校验和审批策略的动作类型。智能体只能把动作的参数填好并提交,安全性因此在结构上得到保证。
MCP 推动的相互连接
随着 Anthropic 提出的 MCP(Model Context Protocol)等标准开放协议普及,把各平台本体论接到智能体上的动作也在推进。Palantir 官方提供「Palantir MCP」,让本地开发环境(IDE)或 AI 智能体可以经由 OSDK 把 Ontology 的对象检索和动作执行当作工具来调用。Microsoft 同样推出「Fabric IQ Ontology MCP」,目标是让 Microsoft Copilot Studio 或外部智能体能够横跨 OneLake 上的本体论定义进行参照。企业系统中,上层智能体运行环境与下层语义/动作基盘的解耦正在加速。
企业的架构选型矩阵
企业设计数据与 AI 基盘时,该选哪种本体论,或该怎么并用,强依赖于组织的课题领域和目标系统需求。
| 企业主要需求与状况 | 最合适的架构方针 | 主要技术构成示例 | 理由与取舍 |
|---|---|---|---|
| 以统一报表/BI 为主要目标(解决全公司指标不一致、推动分析民主化) | 单独引入分析型语义层 | Databricks Unity Catalog、LookML、dbt Semantic Layer | 如果不需要业务写回,直连湖仓的分析层 TCO 最低、运营摩擦最小。 |
| 以 Microsoft 产品群为核心的企业(最大化 OneLake / Power BI 投资) | Fabric 集成型本体论 | Microsoft Fabric IQ、Fabric Graph、Fabric Activator | 可以把 Power BI 既有的 DAX 资产直接复用为本体论指标,生态亲和性极高。 |
| 一线运营需要即时变革(复杂业务应用开发、即时写回) | 全栈操作型本体论 | Palantir Foundry / AIP、OSDK | 充当 BaaS,能把应用开发工时降低一个数量级,但需要接受平台锁定与成本。 |
| 混合型(活用既有湖仓)(大规模存储在云端,业务执行分离) | 分析与操作分层并用的架构 | Databricks / BigQuery(底层存储)+ Palantir / 定制 BaaS(执行层) | 数据积累与重型机器学习流水线跑在开放湖仓,只在需要业务动作的领域覆盖操作层。 |
七、结语
Databricks、Microsoft、Google Cloud 提出的本体论看起来像在做数据分析,而 Palantir 的本体论看起来像软件开发基盘——这个观察准确抓住了各基盘背后系统设计思想与对象领域的差异。
云厂商的本体论,本质上是「分析型语义层」的延长线。它们的职责,是给孤岛化的巨大数据仓库和湖仓赋予统一的语义(维度、度量、关系),以只读方式支持 SQL 生成、BI 报表标准化,以及 LLM 推理中的上下文接地。
而 Palantir 构建的 Ontology,超出了概念定义的范畴,把状态变更事务、前置条件校验、面向外部核心系统的写回 Webhook,以及类型安全的代码生成工具链(OSDK)整合成一个「操作型本体论」,事实上就是企业应用的执行基盘。它不是用来「看」数据的静态镜头,而是让业务对象能被程序「驱动」的分布式运行时。
在生成式 AI 与自主智能体逐渐成为常态的企业系统里,两者的边界正通过 MCP 等标准化被部分接通,但「静态查询优化」与「动态事务执行」这个核心功能的差异依然清晰。企业架构师需要做的,是分清「为了让词义对齐、支撑分析与推理的本体论」和「为了安全组装驱动业务的软件的本体论」——这两种设计意图,并据此选择匹配需求的架构组合。