
エンタープライズ・オントロジーの二つの分岐点:分析型セマンティック層か、ソフトウェア実行基盤か
「オントロジー」は企業ITで二つの潮流に分かれた。指標定義を統一し分析とLLMの文脈接地を支える分析型セマンティック層と、状態変更・事前検証・外部書き戻し・型安全なSDK生成を一体化し業務アプリの実行基盤となる操作型オントロジーである。クラウド各社は前者の延長上にあり、PalantirはCQRSと意思決定の永続化まで含めて後者を実装する。両者の構造差と選定指針を整理する。

エンタープライズ・オントロジーの二つの分岐点:分析型セマンティック層か、それともソフトウェア実行基盤か
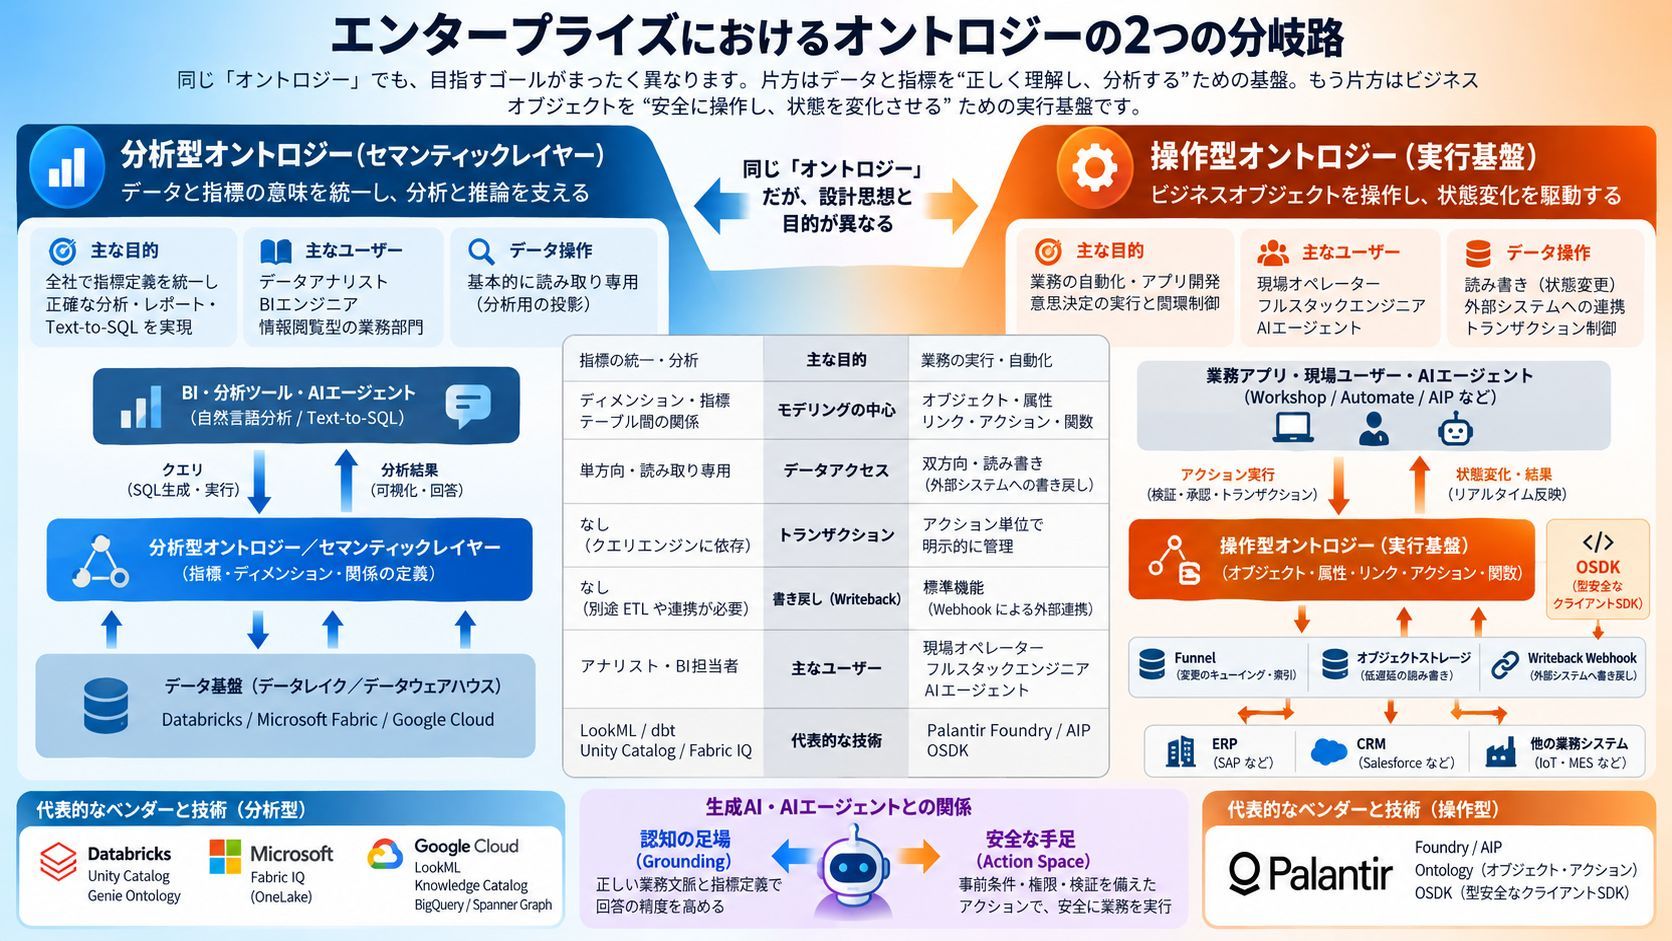
企業のアーキテクトが「我々はオントロジー(Ontology)を構築する」と言うとき、それは何を指しているのだろうか。この一見単純な問いには、ここ十数年でほぼ無関係な二つの答えが生まれている。一つは、データと指標を正しく説明し、正確に計算するための分析型セマンティック層。もう一つは、業務オブジェクトをプログラムから安全に読み書きし、状態変化を駆動する操作型オントロジーである。同じ「オントロジー」でありながら、前者は結局 BI とデータ分析の基盤に育ち、後者はソフトウェア開発・実行基盤へと育った。この分水嶺を理解することは、どのベンダーの製品リストを覚えるよりも重要である。
1. オントロジーの原義:機械に「推論」させることであり、「検索」ではない
計算機科学と知識工学における ontology は、哲学の存在論を母体としつつも、情報システムに受け入れられる過程で非常に技術的な性格を帯びた。Tom Gruber による古典的な定義はこうである。オントロジーとは「概念化の明示的な仕様(an explicit specification of a conceptualization)」である。ここでいう「概念化」とは、ある領域で想定される実体(Entity)、その性質や属性(Property)、実体間に成り立つ関係(Relation)、そしてそれらを論理的に制約する公理(Axiom)を体系化した抽象モデルを指す。
1990年代から2000年代にかけて、W3C のセマンティックウェブ構想はこれを形式言語化し、RDF、RDFS、OWL を生み出した。この系譜におけるオントロジーの中核能力は二つある。第一は、記述論理(Description Logics)に依拠した演繹的推論であり、形式化された知識構造から新たな論理的真偽や分類を自動導出する。第二は開世界仮説であり、記述されていない情報を「偽」ではなく「真偽不明」として扱う。つまり、その目的は最初からデータを検索することではなく、知識を自動推論できる体系に載せることであった。
2. 企業に入ってから:なぜ厳密な公理は本番システムに入らないのか
学術研究は強い推論と普遍的な知識共有を追求するが、産業界のエンタープライズ IT は可用性のコストを払わなければならない。現実の企業データ基盤に OWL の厳密な公理体系を全面適用すれば、三つの直接的な帰結を招く。計算量の急増、トランザクション性能の劣化、そしてスキーマ進化の硬直化である。理想は完結しているが、代償は払えない。
こうして企業情報システムにおける「オントロジー」は再解釈され、二つの大きな潮流に分かれた。
第一の潮流は、ビジネスインテリジェンス(BI)、データウェアハウス、データレイクハウスの進化から派生した分析型セマンティック層(Analytical Semantic Layer)である。これは物理的なリレーショナルテーブルや分散ストレージの結合関係を背後に隠し、業務指標(KPI)の計算ロジックとディメンションを集中管理することで、アナリストやレポートツールに対して一貫した「意味」を投射する。答えるのは「この数値は結局どう計算され、口径は全社で統一されているのか」である。
第二の潮流は、業務オペレーションの実行とカスタムアプリケーションの構築を主眼とする操作型オントロジー(Operational Ontology)である。現実世界の業務実体を振る舞い(Behavior)を持つデジタルオブジェクトとして抽象化し、状態遷移、トランザクション整合性、外部システムへの双方向書き戻しを一体として扱い、ソフトウェア開発のバックエンドとなる。答えるのは「この業務アクションは安全に実行できるのか、実行後どう永続化され、他システムへどう書き戻されるのか」である。
前者の進化軸上には Databricks、Google Cloud、Microsoft の一連のデータプラットフォームが並び、後者の代表は Palantir である。この二つの路線は同じものの深浅ではなく、設計目標の分岐である。
| 分類潮流 | 起源と主な影響 | 主な目的 | データ操作性 | 代表技術 |
|---|---|---|---|---|
| 知識工学・学術型 | 人工知能、セマンティックウェブ、数理論理学 | 知識共有、概念分類、論理的演繹推論 | 静的モデル(公理定義) | W3C OWL, RDF, Protégé, SPARQL |
| 分析型(セマンティック層) | BI、データウェアハウス、メトリクス層 | 指標定義の統一、クエリ自動生成、探索分析 | 原則リードオンリー(分析用の射影) | LookML, dbt Semantic Layer, Databricks Metric Views, Fabric IQ |
| 操作型(業務執行/アプリ基盤) | オブジェクト指向設計、DDD、分散トランザクション | 業務自動化、アプリ開発、閉ループ制御 | リード/ライト(双方向書き戻し、状態遷移) | Palantir Foundry / AIP, OSDK |
3. Palantir:オントロジーを分散オブジェクトランタイムにする
Palantir(Foundry と AIP)が提供する Ontology は、一般的なデータウェアハウスや BI ツールが提供するセマンティック層とは本質的に異なる。公式アーキテクチャでは「組織のオペレーショナル層(Operational Layer for the organization)」と定義されている。同社の 10-K と設計仕様の言葉を借りれば、一般的なオントロジーが「データに対する体系的な文脈マッピング」にとどまるのに対し、自社の Ontology は「意思決定におけるデータ、ロジック、アクションを企業の基礎的表現へ統合するもの」である。
その設計意図は、企業に動的デジタルツインを構築することにある。物理データセット、仮想テーブル、機械学習モデルの上に位置し、製造ライン、航空機、保守部品、顧客、サプライヤーといった現実の実体を「オブジェクト」として具象化する。したがって Palantir にとってオントロジーは、データを可視化するための静的なグラフではなく、「意思決定を行い、その結果を実業務に落とし込む」動的な実行基盤なのである。
名詞と動詞:静的セマンティクスと動的振る舞い
Palantir Ontology の内部構造は、自然言語の「名詞」と「動詞」に似たモデルとして整理されている。これはソフトウェア工学のオブジェクト指向プログラミング(OOP)やドメイン駆動設計(DDD)の構造と対応する。
名詞、すなわち静的セマンティック要素は四種類ある。オブジェクトタイプ(Object Types)は現実の実体やイベントのスキーマ定義であり、プロパティ(Properties)はその属性を規定する。リンクタイプ(Link Types)はオブジェクト間の一対一、一対多、多対多の関係をグラフ構造として保持する。インターフェース(Interfaces)は複数の異なるオブジェクトタイプに対して共通の振る舞いとデータ形状を強制する抽象化層であり、本質的にソフトウェア設計のインターフェースパターンである。
動詞、すなわち動的要素(Kinetic Elements)は、アクションタイプ(Action Types)とファンクション(Functions)で構成される。ファンクションは TypeScript や Python で書かれた計算ロジックで、オブジェクトやオブジェクトセットを入力として受け取り、派生値の計算やバリデーションを行う。そして Palantir を純粋なデータ基盤からソフトウェア開発基盤へと昇格させている中核が、アクションタイプである。
アクション、トランザクション境界、副作用
Palantir におけるアクション(Action)は「ユーザー定義のロジックに基づき、一つまたは複数のオブジェクトのプロパティを変更する単一のトランザクション」と定義される。アクションタイプは四つの構成要素を密結合する。
- パラメータ(Parameters):型付けされた入力値で、オブジェクトそのものをパラメータとして受け取ることもできる。
- ルール(Rules):オブジェクトの新規作成、既存オブジェクトの変更、削除、リンクの作成・削除という基本操作を指定し、複雑なロジックではファンクションを呼び出す。
- 提出基準(Submission Criteria):アクション実行前に業務バリデーションを行い、業務ポリシーに反する不正な状態変更をトランザクション開始前に遮断する。
- 副作用(Side Effects):アクション確定時に実行される外部連携処理(通知送信や Webhook 呼び出しなど)。
トランザクション境界とデータ永続化の方式は特徴的である。ユーザーがアクションを実行しても、変更はオブジェクトを支える元データセットへ直接書き込まれるわけではない。変更命令はまず「ファンネル(Object Data Funnel)」と呼ばれるキューイングとインデックスのサービスに入り、そこからオブジェクトデータベース(Object Storage v2 または Phonograph)のインデックスと書き戻しデータセット(Writeback Dataset)へ低レイテンシで記録される。これにより、分析用の元データを汚すことなく、オブジェクト層でミリ秒単位の読み書きが保証される。
外部基幹システムとの整合性を保つため、「書き戻し Webhook(Writeback Webhooks)」は Ontology 内部のオブジェクト変更が起こる前に先行実行される。SAP などの ERP や Salesforce などの CRM への API 呼び出しが成功して初めて、Foundry 内のオブジェクト更新がコミットされる。こうして外部システムと Foundry の間に実用的な分散トランザクション整合性が保たれる。対照的に、アクション実行後に非同期でベストエフォート処理する「副作用 Webhook(Side-effect Webhooks)」も用意されており、業務要件に応じた耐障害性設計が可能になっている。
OSDK:Foundry をヘッドレス BaaS にする
Palantir が開発基盤と見なされる決定的な理由は、Ontology SDK(OSDK)の存在である。OSDK は集中管理された Ontology から、特定のアプリケーション境界に必要な型定義を抽出し、TypeScript、Python、Java 向けに完全に型安全なクライアント SDK を自動生成する。
従来のエンタープライズ開発では、開発者がデータベース接続設定、ORM の構成、SQL/REST のラッパー作成、アクセス制御の実装を個別に行う必要があった。OSDK を採用したアーキテクチャでは、Foundry 自体がヘッドレスな BaaS として機能する。フロントエンド開発者は生成された型安全な API を呼ぶだけで、認証、認可、行・列レベルのセキュリティ、トランザクション検証、監査ログ記録が背後で適用される。
さらに、ローコードで業務アプリを構築する Workshop、イベント駆動のワークフローを自動化する Automate、LLM を型付けされたオブジェクトとアクションに直結させる AIP Logic に至るまで、すべてのプラットフォーム機能が Ontology を共通のランタイム・オブジェクトモデルとして使う。言い換えれば、Palantir の Ontology は分析の終着点ではなく、エンタープライズソフトウェアを迅速かつ堅牢に組み上げるための「分散オブジェクト指向オペレーティングシステム」なのである。
4. 三大クラウド:オントロジーは今どこに住んでいるか
「分析型セマンティック層」をオントロジーと見なさなければ、クラウド各社の製品を誤解することになる。彼らのオントロジー能力は、ほぼ分析と文脈接地(Grounding)に向いている。
Databricks:Unity Catalog Semantics と Genie Ontology
Databricks の路線は、レイクハウス上のガバナンスメタデータから出発し、自然言語分析とエージェントの接地へ拡張する方向にある。中核は Unity Catalog Semantics と Genie Ontology である。
Unity Catalog Semantics は、カタログ内のテーブルやビューに人間中心の業務ロジックを付与する。メトリックビュー(Metric Views)は KPI(集計値と分析軸)を再利用可能な SQL オブジェクトとして定義し、クエリ実行時に動的に SQL を展開することで、分析ツール間で計算結果が一致することを保証する。ドメイン(Domains)は業務組織や目的に応じてデータ資産を論理的にグループ化し、ページ(Pages)は業務用語の権威ある定義を記述して AI ツールが参照する正しい文脈となる。認証・非推奨フラグは、組織が公式に保証するデータ資産を明示する。
この人手でモデリングされた層の上に展開されるのが Genie Ontology である。Databricks Genie(自然言語分析エージェント)に業務コンテキストを提供する統合コンテキスト解決エンジンであり、静的な定義辞書にとどまらない。組織内のクエリログ、テーブル間の結合履歴、利用頻度といった実利用の状況から、Ontorank と呼ばれるアルゴリズムでコンテキストを動的に推論し重み付けする。
しかし Databricks のオントロジーは、本質的に「高度な読み取り専用分析」と「Text-to-SQL の精度向上」のためのセマンティック基盤である。Unity Catalog が管理する主キー・外部キー制約は依然として情報提供用(Informational)にとどまる場合が多く、Palantir のようなトランザクションを伴うアクション実行、副作用制御、データ書き戻しのアプリケーション実行層は組み込まれていない。
Microsoft:Azure Digital Twins(DTDL)から Fabric IQ Ontology へ
Microsoft のオントロジーは二つの系譜が融合しつつある。一つは IoT と空間モデリング、もう一つは Power BI と Fabric を中心とするデータ分析である。
歴史的には、IoT やスマートビルディング向けに策定された DTDL(Digital Twins Definition Language)を中核とし、Azure Digital Twins 上で物理資産の関係やテレメトリをモデリングしてきた。DTDL はテレメトリ、プロパティ、リレーションシップに加えてコマンド(Command)も定義でき、IoT デバイス制御の観点では一部に運用的な性格を持つ。
最新のエンタープライズデータプラットフォーム戦略は、Microsoft Fabric IQ の「オントロジー(Ontology item、プレビュー)」に置かれている。Fabric IQ は OneLake 上に業務の意味論的モデルを構築するワークロードであり、エンティティタイプ、プロパティ、リレーションシップを物理テーブルから切り離して定義し、継承と名前空間による再利用を可能にする。オントロジー定義自体はデータを保持せず、OneLake 内の Lakehouse、Warehouse、Eventhouse、あるいは Power BI セマンティックモデルへ仮想的にバインド(Data Binding)される。既存の Power BI セマンティックモデルで定義された DAX メジャーをオントロジー指標として直接継承でき、多段ホップのパス探索が必要な場合は Fabric Graph 実行エンジンへ投影してクエリを実行する。
Fabric IQ のオントロジーは、Fabric Activator との統合を通じて「条件判定によるアラート発火」のような運用寄りのアクションを一部定義できる。しかしシステム全体のアーキテクチャとしては、「分析・可視化エンジンと Data Agent に業務コンテキストを提供する層」としての性格が極めて濃い。データの物理永続化とトランザクション処理は下位ストレージに委ねられており、オントロジー自体がカスタムアプリケーションのステートフルなバックエンドとして直接機能するわけではない。
Google Cloud:LookML、Knowledge Catalog、Spanner / BigQuery Graph
GCP のオントロジー的アプローチは、「Ontology」という単一の統合製品を出すのではなく、分析セマンティック層、メタデータガバナンス、ネイティブなグラフデータベース技術を疎結合に組み合わせて構成される。
分析セマンティック層の中枢は Looker の LookML である。ディメンション、メジャー、リレーションシップをコードとして宣言し SQL を動的生成する、セマンティック層の元祖であり、Gemini などの生成 AI を業務指標に接地させるための統制基盤と位置づけられている。
データガバナンスでは、従来の Dataplex が Google Knowledge Catalog へと進化し、技術メタデータ、ビジネス用語集、データ品質ルール、リネージの統合管理を担う。
より高度な関係モデリングを提供するのが Spanner Graph と BigQuery Graph である。国際標準規格である ISO GQL(グラフ問い合わせ言語)をサポートし、リレーショナルデータに直接プロパティグラフモデルを適用できる。注目すべき設計パターンとして、Yahoo などの先進事例は二重構造を提唱している。運用上の真実(Operational Truth)の記録に Spanner Graph を用い、意思決定の履歴と監査リネージ(Decision Lineage)を蓄積するコンテキストグラフとして BigQuery Graph を用いるというものである。
このように GCP は極めて堅牢な基盤コンポーネント(分散トランザクションエンジン、データウェアハウス、セマンティック BI)を提供するが、「業務オブジェクトの振る舞い」と「書き戻しトランザクション」までを一括して抽象化するアプリケーション層のオントロジー枠組みは存在せず、統合は利用企業の個別開発に委ねられている。
5. 二つのオントロジーの構造的比較
各社の概念を並べると、分析型オントロジーと操作型オントロジーの間には、データアーキテクチャの根幹に関わる思想的断層がある。
分析型オントロジーは、データウェアハウスやデータレイク内の「静止したデータ(Data at Rest)」に意味を与える。関心は計算ロジックの統一(全社で「売上」の定義を一致させること)とクエリ生成の効率にある。データフローは基本的に一方通行で、ストレージからダッシュボードへ、あるいは LLM のプロンプトコンテキストとして消費され、読み取り専用が前提となる。
操作型オントロジーは、業務の「動的な状態変化(State Mutation)」とワークフローの閉ループ制御を対象とする。データウェアハウスが持つ集計データと、ERP や CRM などの基幹業務システムが持つトランザクションデータをオブジェクトとして統合し、ユーザーやエージェントが下した意思決定(Action)を即座に状態として反映し、外部システムへ書き戻す。
両者のデータフローの違いは明快である。分析型オントロジーは物理データストアの上に仮想的なセマンティック層を置き、クエリ発行時に SQL へ動的展開して、BI、レポート、LLM へ一方通行で消費される。操作型オントロジーはそうではない。データは基幹システムや物理ストアからオブジェクト層へ同期されるだけでなく、アプリケーションや AI エージェントがアクション層に対してトランザクションを実行すると、Funnel サービスを介してオブジェクト層へ即時反映され、同時に Webhook などを通じて外部基幹システムへ双方向に書き戻され、閉ループを形成する。
| 比較項目 | 分析型オントロジー / セマンティック層 | 操作型オントロジー |
|---|---|---|
| 主要ベンダー・技術 | Databricks(Unity Catalog, Genie)、Microsoft(Fabric IQ)、Google Cloud(LookML, Dataplex) | Palantir(Foundry Ontology, AIP, OSDK) |
| 主な設計目的 | 指標計算の一貫性確保、Text-to-SQL 精度向上、探索分析 | 業務オペレーションの実行、カスタムアプリ構築、閉ループ自動化 |
| モデリングの中核 | ディメンション、メジャー(集計関数)、テーブル間結合 | オブジェクト、プロパティ、リンク、アクション、ファンクション |
| データアクセスの方向性 | 一方通行・リードオンリー(分析クエリの生成) | 双方向・リード/ライト(オブジェクト編集と元系への書き戻し) |
| トランザクション境界 | 存在しない(クエリエンジン側の ACID 特性に依存) | アクション単位で明示的な境界と事前検証を管理 |
| 書き戻し(Writeback) | なし(別途リバース ETL やオーケストレータが必要) | プラットフォーム標準(Funnel サービス、Writeback Webhooks) |
| ソフトウェア開発体験 | BI 開発、SQL クエリ、ダッシュボード埋め込み、REST クエリ | OSDK による完全型安全なクライアント SDK 生成、BaaS 的利用 |
| 変更追跡と監査性 | データリネージ(テーブル/列レベルの変換履歴) | デシジョンリネージ(誰が、いつ、どのデータ版で実行したか) |
| 主なエンドユーザー | データアナリスト、BI エンジニア、情報閲覧型ビジネス層 | 現場オペレーター、フルスタックエンジニア、業務執行 AI エージェント |
CQRS と意思決定の永続化
ソフトウェア設計論の視点に移すと、Palantir の特徴はエンタープライズ規模の CQRS(Command Query Responsibility Segregation:コマンドクエリ責務分離)をプラットフォーム層で実装している点にある。
分析型セマンティック層は CQRS のうち「クエリ(読み取りモデル)」の最適化だけを担う。Palantir はクエリ(Object Set Service による低レイテンシの検索・集約)とコマンド(Actions Service と Funnel による書き込み・副作用実行)を完全に分離し、それぞれに最適化されたストレージと検証パイプラインを割り当てる。
さらに際立つのは「意思決定の永続化(Decision Capture / Decision Lineage)」という思想である。従来のデータ基盤では、人が分析ダッシュボードを見て判断を下し、それをメールで伝えたり基幹システムへ手入力したりするため、「その決定がどのようなデータコンテキストに基づいて下されたか」という文脈情報が失われていた。操作型オントロジーでは、すべてのアクションが Ontology を通るため、意思決定のパラメータ、実行者、参照したオブジェクトのバージョン、そして結果として生じた状態変化が、不可分な監査ログ(Action Log)として記録され、再学習のためのデータ資産として蓄積される。
6. 生成 AI・エージェント時代:認知の足場と安全な手足
生成 AI と自律型エージェントの台頭は、むしろオントロジーの存在意義を広げている。単体の LLM は業務の文脈を理解できず(幻覚を起こす)、外部世界に副作用を及ぼす安全な手段も持たない。この文脈において、分析型と操作型のオントロジーは、エージェントにとって相補的でありながら異なる役割を担う。
分析型オントロジー(Databricks Genie Ontology や Fabric IQ など)は、エージェントにとっての「認知と推論の足場(Grounding Context)」として機能する。エージェントが業務上の問い合わせを受けたとき、Unity Catalog の Metric Views や Pages が介在することで、不正確な SQL を自前で捏造することなく、組織が認めた数式と結合条件で正確な回答を生成できる。
操作型オントロジー(Palantir AIP など)は、エージェントにとっての「安全な手足(Tool Use / Action Space)」を提供する。エージェントが自律的に意思決定し、例えば「欠品を防ぐためにサプライヤーへ追加発注する」という行動を取ろうとする場合、生のデータベースへ UPDATE を発行したり、無制限に API を呼び出したりすることを許せば、破滅的なシステムリスクを伴う。操作型オントロジーでは、エージェントに公開されるのは、事前条件、型定義、認可チェック、承認ポリシーが組み込まれたアクションタイプだけである。エージェントはアクションのパラメータを埋めて送信することしか許されず、安全性が構造的に担保される。
MCP による相互接続の進展
Anthropic が提唱した MCP(Model Context Protocol)などの標準オープンプロトコルが普及するにつれ、各プラットフォームのオントロジーをエージェントに接続する動きが進んでいる。Palantir は公式に「Palantir MCP」を提供し、ローカル開発環境(IDE)や AI エージェントが OSDK を介して Ontology のオブジェクト検索やアクション実行をツールとして呼び出せるようにしている。Microsoft も「Fabric IQ Ontology MCP」を投入し、Microsoft Copilot Studio や外部エージェントが OneLake 上のオントロジー定義を横断的に参照できるアーキテクチャを目指す。企業システムでは、上位のエージェント実行環境と下位のセマンティック/アクション基盤の疎結合化が加速している。
企業におけるアーキテクチャ選定マトリクス
企業がデータ・AI 基盤を設計する際、どのオントロジーを採るか、あるいはどう併用するかは、組織の課題領域と目標とするシステム要件に強く依存する。
| 企業の主な要件・状況 | 最適なアーキテクチャ方針 | 主な技術構成例 | 理由とトレードオフ |
|---|---|---|---|
| レポーティング/BI の統一が主目的(全社指標の不一致解消、分析の民主化) | 分析型セマンティック層の単独導入 | Databricks Unity Catalog、LookML、dbt Semantic Layer | 業務書き戻しが不要なら、レイクハウス直結の分析層が最も TCO が低く運用摩擦も少ない。 |
| Microsoft 製品群が中心の企業(OneLake/Power BI 投資の最大化) | Fabric 統合型オントロジー | Microsoft Fabric IQ、Fabric Graph、Fabric Activator | Power BI の既存 DAX 資産をそのままオントロジー指標として再利用でき、エコシステム親和性が極めて高い。 |
| 現場オペレーションの即時変革(複雑な業務アプリ開発、即時書き戻し) | フルスタック操作型オントロジー | Palantir Foundry / AIP、OSDK | BaaS として機能するためアプリ開発工数を桁違いに削減できるが、プラットフォームロックインとコストの受容が必要。 |
| ハイブリッド型(既存レイクハウスの活用)(大規模蓄積はクラウド、業務執行は分離) | 分析と操作の階層的併用アーキテクチャ | Databricks / BigQuery(基盤蓄積)+ Palantir / カスタム BaaS(執行層) | データ蓄積と重い機械学習パイプラインはオープンなレイクハウスで回し、業務アクションが必要な領域にだけ操作層を被せる。 |
7. おわりに
Databricks、Microsoft、Google Cloud が提示するオントロジーはデータ分析に見え、Palantir のオントロジーはソフトウェア開発基盤に見える。この観察は、各基盤の背後にあるシステム設計思想と対象領域の違いを的確に捉えている。
クラウド各社のオントロジーは、本質的に「分析型セマンティック層」の延長線上にある。その役割は、サイロ化した巨大なデータウェアハウスやレイクハウスに統一された意味論(ディメンション、メジャー、関係性)を与え、SQL 生成、BI レポートの標準化、そして LLM 推論における文脈接地を読み取り専用で支えることにある。
一方、Palantir が構築した Ontology は、概念定義の枠を超え、状態変更トランザクション、事前条件のバリデーション、外部基幹系への書き戻し Webhook、そして型安全なコード生成ツールチェーン(OSDK)を一体化した「操作型オントロジー」であり、事実上のエンタープライズアプリケーション実行基盤である。それはデータを「見る」ための静的なレンズではなく、業務オブジェクトをプログラムから「動かす」ための分散ランタイムとして機能している。
生成 AI と自律型エージェントが定着していく企業システムにおいて、両者の境界は MCP などの標準化によって部分的に接続されつつあるが、「静的なクエリ最適化」か「動的なトランザクション執行」かという中核機能の違いは依然として明確である。企業のアーキテクトに求められるのは、「言葉の意味を揃え、分析と推論を支えるためのオントロジー」と「業務を動かすソフトウェアを安全に組み上げるためのオントロジー」という二つの設計意図を峻別し、要件に合ったアーキテクチャ構成を選ぶことである。