
AI Director:把「一句话生成视频」拆成一条可复核的制片流水线
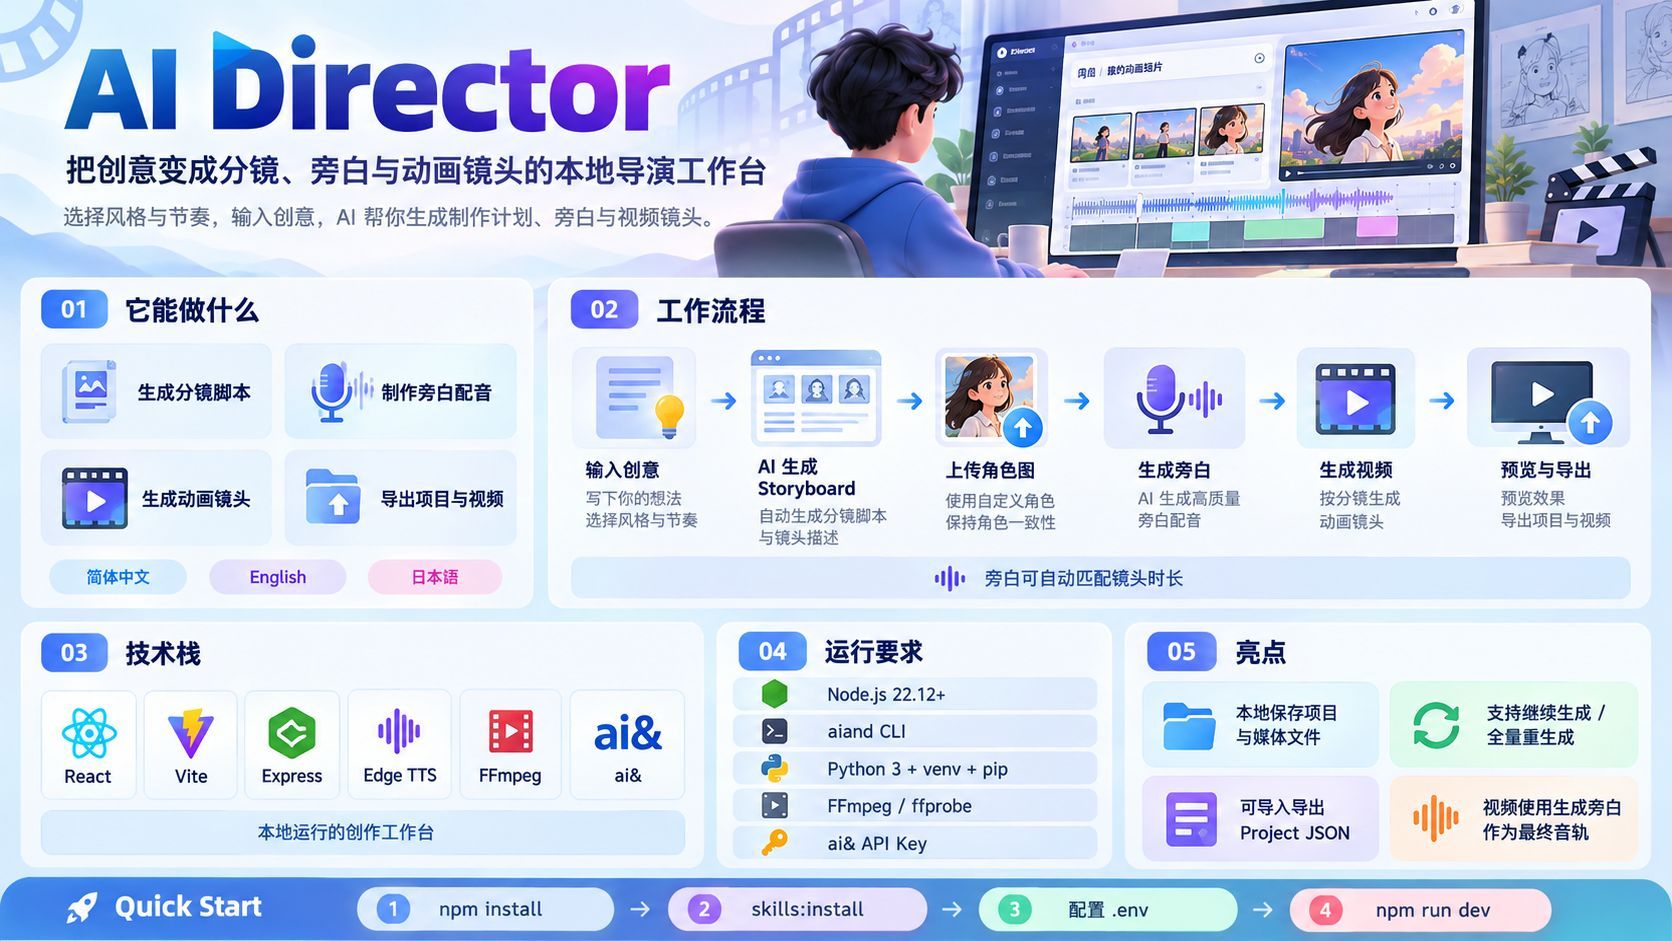
AI Director 是一个跑在本地的导演工作台,把想法拆成分镜、角色、配音和镜头。它用通过校验的项目 JSON 约束 AI 输出,以 Edge TTS 生成旁白并按镜头时长调整语速,再通过 ai& 的 MiniMax H3 生成视频。本文梳理它的制作流程、时间轴处理、付费任务的边界、本地优先的数据设计,以及显式加载并校验 Skill 的工程取舍。

AI Director:把「一句话生成视频」拆成一条可复核的制片流水线
AI Director 是 Hackson '+81 Builders: Make Tokyo a Builder City' 上的一个项目。它想处理的,是一个常被「生成」二字遮住的问题:一条片子真正的难点,往往不在第一个镜头出来之前,而在它出来之后。旁白比镜头长了两秒怎么办?第二个镜头里的角色,和第一个还是同一张脸吗?关掉浏览器再打开,改过的台词、选好的声音、已经付费提交的任务还在不在?
一句话生成视频的演示很直观,但它交付的是一个镜头,不是一条片子。AI Director 的选择相反:把导演的工作拆成几个可以分别检查的环节——分镜、角色、配音、镜头、导出——做成一个跑在本地的导演工作台。项目地址是 perfact-tang/AIDirector_AI-81builders。
先有可校验的分镜,才有片子
AI Director 的入口不是上传素材,而是把要拍的东西写清楚。用户先选视觉风格——写实 3D、日式动画或 2.5D——再选镜头节奏,5 秒或 10 秒一档,然后输入想法。AI 据此起草整份制作计划,包括分镜、角色、旁白和每个镜头的提示词。
真正关键的是下一步:返回的不是一段看起来像分镜的自由文本,而是项目 JSON。后端会加载内置的 direct-h3-storyboards Skill,把它里面的说明、参考资料和 JSON 模板读进模型上下文,再用 validate_storyboard.mjs 校验输出;校验不通过时最多重试两次。只有通过校验的结构,才会进入工作台。
这个选择看起来只是工程细节,实际上决定了产品形态。自由文本只能被阅读,结构化的项目才能被逐项修改、被后续步骤消费、被导出后再打开。分镜不是给 AI 看的草稿,而是整条流水线的第一份合同。
五个环节,人始终在回路里
接下来的流程更像制片,而不是抽卡:
- 分镜与角色:审阅 AI 起草的角色和镜头,修改台词、提示词、时长与画幅。
- 角色图:复制角色的图像提示词,到惯用的外部服务生成图片,再上传并保存。应用本身不生成角色图,这一步刻意留在外面,把图像模型的选择权交给使用者。
- 配音:逐个镜头编辑台词、选择声音,可以单条生成,也可以整批生成。语音由 Edge TTS 合成。
- 镜头:检查镜头提示词、首帧提示词、时长和宽高比。每个视频使用该镜头当前的旁白,以及提示词中提到的角色的已保存图像作为参考;如果镜头里没有角色,则需要一张场景参考图。视频通过 ai& 的 Videos API、由 MiniMax H3 生成。
- 预览与导出:用顺序播放的音频、视频播放器检查成片,把生成文件打包成 ZIP 下载,并保存项目 JSON。
人没有在某个「一键生成」的按钮前消失,而是被安排在每一个需要判断的位置:角色像不像、旁白顺不顺、镜头提示词是否准确、哪一条要重来。AI 负责起草和生成,导演负责判断和取舍。
让旁白服从剪辑,而不是让剪辑迁就旁白
配音是这条流水线里最容易暴露问题的一环。TTS 按文本生成音频,它不知道这个镜头只有 5 秒;而分镜的时长又可能在上游被改动。若不处理,结果只有两种:要么切掉旁白,要么把镜头拉长。
AI Director 的做法是给每条新生成的旁白做一次时长适配。系统拿它和镜头当前时长比较,包括之后在分镜工作区里改过的时长:
- 已经合适的,保持原速。
- 超长的,用 FFmpeg 的
atempo滤镜加速,初始倍率是「原始时长 / 目标时长」。 - 加速后再测一次,必要时修正;剩余的空隙用一小段静音补足。
- 不切断语音内容来强行对齐。
界面会显示原始时长、最终时长和实际应用的倍率,这些值也会写进导出的项目 JSON。测量用的是解码后的音频样本,而不是容器里报告的时长,避免 MP3 编码器补帧造成的误判;视频提交前和把旁白恢复到最终视频时,用的也是同一套测量。
还有一层缓存:原始 TTS 文件保留在本地,修改目标时长时可以复用原录音,不必为同一段文本和声音再请求一次。这既省时间,也省调用成本。对一个需要反复调整节奏的剪辑过程来说,这比「生成得更快」更实际。
停止生成,不等于取消已经提交的任务
视频生成可能产生 API 费用,因此批量操作被拆成两种模式:继续生成保留已有结果,只补缺失或修改过的镜头;从头重新生成会重做所有合格镜头,但旧视频会保留到新结果成功替换为止。
停止的语义也按本地和远端分开。停止配音会同时取消正在工作的本地进程;停止视频只能阻止继续提交,已经送到 ai& 的任务无法取消,可能仍在后台处理。应用会保留已有任务 ID 用于恢复,也不会在导入项目时自动重放付费提交队列。
这套设计承认了一个现实:生成请求一旦发出,状态就不完全由本地控制。遇到状态不确定的提交,正确做法是先去 ai& 控制台确认,再决定是否新建任务,而不是反复点击生成、制造重复扣费。费用与条款需要在生成前确认:账户定价在工作区里查看;如果服务要求,视频服务条款也要由使用者本人在 ai& 控制台接受。
本地优先,具体到每一个文件
AI Director 的前端是 React + Vite,后端是 Express。开发时前端跑在 5173,后端跑在 3001,/api 请求由前端代理到本地后端。API Key 只放在后端的 .env 里,不进入任何 VITE_ 变量,避免被打包进浏览器代码。
数据的落点也被明确划分:
| 数据 | 位置 |
|---|---|
| 创作简报与界面语言 | 浏览器 localStorage |
| 上传的图片、工作区修改、生成的音频 | 浏览器 IndexedDB |
| 原始与调整后的 MP3 | .local/audio/ |
| 视频任务记录、源视频、最终 MP4 | .local/videos/ |
| 安装后的 Skill | .local/skills/direct-h3-storyboards/ |
项目 JSON 可以携带角色图和配音,但视频始终是单独的本地文件。换一台电脑时,需要下载视频 ZIP,并保留 .local/videos/;清空浏览器数据则会删掉浏览器里的草稿和工作区记录。脚本生成的任务记录只存在后端内存里,重启后端前应先导出已完成的项目。
这些边界也解释了数据去了哪里:脚本简报会发给 ai&,配音文本会发给微软的 Edge TTS,请求生成视频时参考素材会发给 ai&。本地优先不等于完全离线,它意味着哪些东西留在本机、哪些东西必须出门,至少是清楚的。
Skill 是契约,不是一段提示词
direct-h3-storyboards 不是随手塞进系统提示词的一段说明。它有自己的目录,包含指令、参考资料、JSON 模板、校验器和测试;npm run skills:install 把它复制到项目的 .local/skills/ 下,安装过程在本地完成,不发网络请求,npm run skills:verify 则用来比对安装副本与内置源文件是否一致。
运行时,后端按固定顺序解析这份 Skill:先看 DIRECTOR_SKILL_PATH,再看项目里安装的副本,最后回退到仓库内置的源目录。它不依赖 CLI 的自动 Skill 发现,而是显式读取指令、必需参考和项目模板,再对模型输出执行校验。这样做的代价是要自己维护加载逻辑,好处是行为更可预测:同样的 Skill 版本、同样的模板、同样的校验,换一个模型或换一次运行,产出结构更不容易悄悄漂移。
这也意味着 Skill 的边界必须说清楚。仓库里的 Skill 描述了更广的语音和音乐规划流程,但这个应用目前只执行 Edge TTS 和 ai& 的 MiniMax H3,不会运行那些额外的生成器。把「文档里写了」和「产品真的会做」分开,比让读者自己猜要诚实。
它不做什么
- 不生成角色图。角色图必须由使用者在外部服务生成后上传;没有角色的镜头,需要自备场景参考图。
- 不是云端服务。前后端都面向本地使用,使用期间要保持终端运行。
- 不把视频放进项目 JSON。项目可以重新打开,但视频要靠本地文件和 ZIP 备份恢复。
- 不自动重放付费任务。导入项目不会重新提交生成请求。
- 不把界面语言等同于内容语言。底部可以在简体中文、English、日本語之间切换,但这只改变界面文案;对话、角色名、提示词、项目内容、声音选择和朗读语言都各自独立。内置 Skill 会有意生成中文的制作提示词,同时保留名字、对话和歌词的原始语言。
跑起来需要什么
依赖不算少,但都是明确的:Node.js 22.12 或更新版本、PATH 上的 aiand CLI、带 venv 和 pip 的 Python 3,以及带 libmp3lame 的 FFmpeg / ffprobe。Windows 需要在 WSL 里安装这些依赖。还需要一个能访问所配置文本模型和视频模型的 ai& API Key。
npm install
npm run skills:install
npm run skills:verify

python3 -m venv .venv
.venv/bin/python -m pip install -r requirements-tts.txt

cp -n .env.example .env
# 在 .env 中填入 AIAND_API_KEY

npm run dev
然后打开 http://127.0.0.1:5173/ 。生产构建用 npm run build,再用 npm start 在 3001 端口提供前端和 API。默认文本模型是 deepseek-ai/deepseek-v4.1-flash,视频生成使用 minimaxai/minimax-h3。如果工具不在默认位置,可以用 AIAND_BIN、DIRECTOR_SKILL_PATH、EDGE_TTS_PYTHON、FFMPEG_BIN、FFPROBE_BIN 覆盖。应用测试使用 mock 或本地媒体 fixture,不会调用付费生成服务;涉及 FFmpeg 的测试则需要本机装好 FFmpeg。
结语
AI Director 真正有意思的地方,不是让 AI 多生成一个镜头,而是把导演的决定变成一份份可以检查、可以修改、可以恢复的文件:通过校验的分镜 JSON、上传的角色图、按镜头时长调整过的旁白、每个镜头的提示词,以及用于恢复的生成任务 ID。
一句话生成视频很酷,但它交付的是一个瞬间。制片是一条流水线,里面有取舍、有返工、有成本,也有责任。把这条流水线做出来,比再生成一个漂亮的镜头更接近「让 AI 参与拍片」这件事本身。