
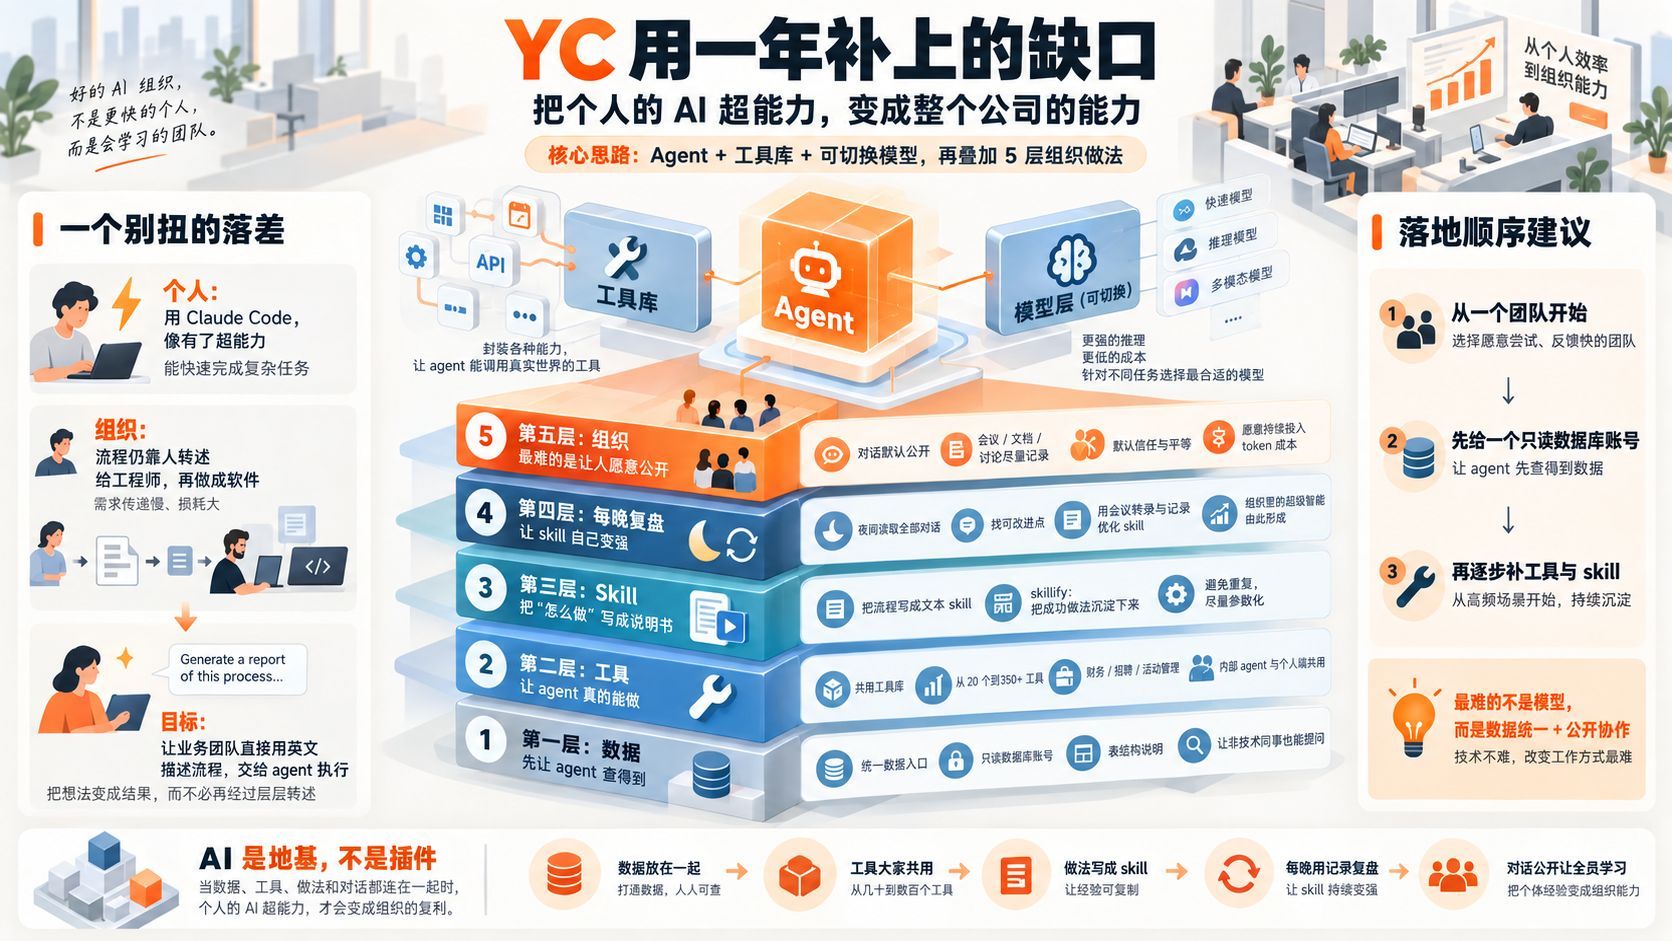
YC 用一年补上的缺口:把个人的 AI 超能力,变成整个公司的能力
个人用 AI 已经很强,公司整体却没怎么变。YC 花一年搭起五层系统:统一数据、共用工具、把做法写成 skill、每晚用对话记录改进 skill,再把对话默认公开。合伙人 Pete 首次公开这套结构,本文按落地顺序拆解,并指出最难的两层与第一步。

YC 用一年补上的缺口:把个人的 AI 超能力,变成整个公司的能力
很多人已经在用 AI 了,而且用得很强。但把镜头拉远到整个公司,情况往往没怎么变:个人效率提高了,组织做事的方式还是老样子。
YC 是硅谷最知名的创业孵化器。它花了一年时间,只解决一个问题。现在,他们公司里的 AI 每天晚上会把全公司当天的对话读一遍,第二天自己变得更好用。这套系统到底怎么搭起来的?YC 的合伙人 Pete 第一次公开讲了完整结构。把它拆开,一共五层,任何公司都能照着搭。
一个别扭的落差
Pete 发现了一个很别扭的落差。
他自己在电脑上用 Claude Code,感觉像有了超能力。可回到公司,财务要记账、要登记融资轮次,还是得先把需求讲给工程师听,工程师写成软件,再交回来;流程走完一遍,下一轮又从头来。
他的想法很直接:让财务自己用英文把流程写下来,交给 agent 执行,把工程师从这个循环里拿掉。
这背后是一个更大的判断:个人用 agent 和组织用 agent 之间,差了一大截,而且还没有人真正用好。YC 这一年做的,就是去补这道缺口。
他们造的系统其实很简单,就三样东西:一个能自己干活的 agent,一个工具库,底下可以切换不同的模型。真正复杂的是围绕这三样东西长出来的五层做法。
第一层:数据——先让 agent 查得到
第一层是数据。
YC 的合伙人 Jared 觉得手头的数据不够用,深夜偷偷上线了两个工具:一个能对生产数据库跑只读查询,一个能读数据库的表结构文件。结果效果出奇地好。
原因不复杂。YC 几乎所有业务都跑在自己写的软件上,数据全在一个数据库里:投过的每家公司、每个创始人、每笔交易、合伙人在 CRM 里留下的笔记,都在里面。agent 只要知道表结构,什么问题都能答。
现在随口就能问:最近四期投过的航天公司,都有哪些投资人?放在以前,这要写几个小时的 SQL,还得去数据团队排队。
门槛一降,大家问的问题变多了,也敢问更难的了。连没有技术背景的财务同事,都能直接提问。
那数据散在几十个 SaaS 里的公司怎么办?Gary 的办法是:把各处的数据倒到一个地方,专门为 agent 再整理一份。不追求规范,而是按 agent 容易检索的方式重新组织。
如果你所在的公司要开始,第一步就是这个:给 agent 一个只读的数据库账号,再附一份表结构说明。只读,意味着它什么都能查得到,但什么都改不了。
第二层:工具——让 agent 真的能做
数据能查了,事情还得能做。
一个工具,就是 agent 能执行的一个动作,比如记一笔账、约一次会。YC 建了一个所有团队共用的工具库:一开始 20 个,现在 350 多个,覆盖财务、招聘、office hour、活动管理等等。每个团队把自己的活做成工具放进去。
关键在“共用”。同一套工具,内部 agent 能调用,每个人电脑上的 Claude Code 也能调用。
Pete 说,如果换到任何一家公司,他最先做的就是这两件事:统一的数据,加一个公用的工具库。
自己公司不必一次做全。YC 也是从财务一个团队开始的。哪件事值得交给 agent,就往库里加一个工具。
第三层:Skill——把“怎么做”写成说明书
工具解决的是“能不能做”,skill 解决的是“怎么做好”。
你可以把 skill 理解成工具上面的一层说明书,本质是一个文本文件:遇到这类事,按什么步骤、用哪些工具。
YC 的用法是这样演进的:一开始每个人自己写提示词,后来写成 skill,再后来让 agent 自己去改 skill。哪次做得好,就说一句“skillify”,把这次的做法存下来,下次谁都能用。
Gary 自己还有个习惯:定期检查新的 skill 和旧的有没有重复,整体是不是不重不漏。十个做同一件事的 skill,不如一个带参数的。
自己公司的第一批 skill,就是让团队里真正干活的人,把自己做某件事的过程写下来。
第四层:每晚复盘,让 skill 自己变强
再往上,是让 skill 自己变强。
YC 有一个 agent,每天晚上读完全部员工和 agent 的对话,专门找两样东西:哪里本来可以做得更好;哪里如果一开始就有某条信息,能做得更快。然后回头去改对应的 skill。
举个例子。YC 要求创始人用两句话讲清楚自己的公司:你做的是什么,为什么值得关注。听着简单,很多老练的创始人都写不好。一位合伙人写了个 skill 专门帮他改。后来几位合伙人开了场小组辅导,让这一期的每个创始人现场写、现场点评,再把这一场的转录喂给 skill,让它自己改进。Pete 说,现在它写得比他还好。
Gary 的总结是:组织里的超级智能就是这么来的——把一件事做成 skill,用的过程留下记录,再用记录改进 skill。每件事都这样做一遍,就没有更复杂的了。
可以先从自己公司的一个 skill 开始:把它的对话记录、相关的会议转录留下来,让它自己改。跑通了,再推到下一个。
第五层:组织——最难的是让人愿意公开
第五层最难,而且跟技术无关,是组织。
一是对话默认公开。YC 每个员工和 agent 的对话,全公司都能看到,实时推到一个 Slack 频道。这个决定当时争论了很久:所有人都能看到,所有东西真的都能公开吗?最后留下来的原因是,大家看着别人怎么用,才学会用的。公开本身也是一种约束。在 VC 这种高信任的环境里,敏感信息反而没人乱用。
二是什么都录下来。会议、讨论、文档,都是 agent 复盘的原料。两年前开会录音还很别扭,现在几乎成了默认。
三是舍得花钱。Gary 说,每年花 1 万到 10 万美元买 token,相当于提前活在 2028 年:今天要花 10 万的事,明年 1 万,后年几百块。就像 90 年代最早给员工配电脑的那批公司。
他们的结论是,这样的组织必须够平等、默认信任。而世界上大多数组织,恰恰做不到这两点。大公司的数据都锁着,理由是不安全。
回报也很实在。原来新人要半年才能上手;现在 agent 里装着最好的合伙人怎么做事,新人一来就能学。不好意思问同事的问题,可以先问 agent。
自己公司也可以先在一个团队里试:把大家和 agent 的对话公开到一个群里。
反过来想:AI 是地基,不是插件
Pete 写过一篇很火的文章,叫《五匹马的马车》。他说,大部分 AI 产品只是在旧软件里塞一点 AI;而 YC 这套做法正好反过来——AI 是地基,工具和流程长在它上面。
把这五层再串一遍:数据放在一起,工具大家共用,做法写成 skill,每晚用记录复盘,对话公开给所有人看。
模型反而是最不用操心的。难的是第一层和第五层:把数据放到一起,和让大家愿意公开地用。
如果只做一件事,就从一个团队、一个只读数据库账号开始。这期建议存下来,对照自己公司看看,卡在哪一层了。