
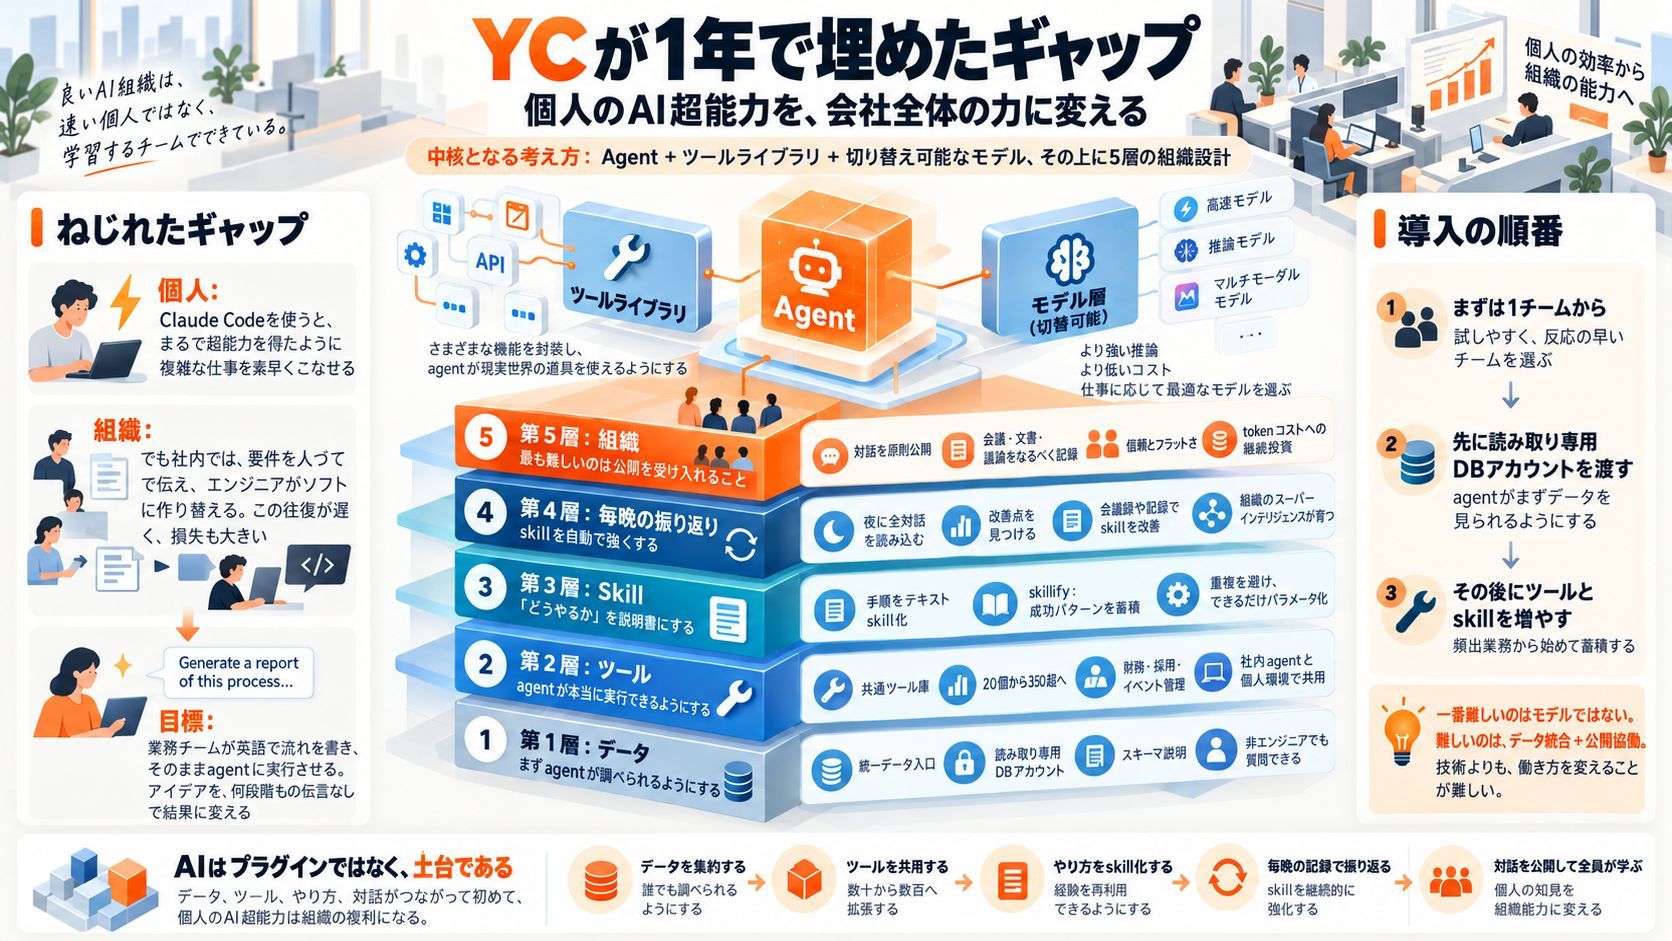
YCが1年かけて埋めたギャップ:個人のAI超能力を、会社全体の力に変える
個人ではAIを強く使えても、会社全体の仕事の進め方は変わらない。YCは1年かけ、データ、ツール、skill、毎晩の振り返り、会話の公開という5層の仕組みでこのギャップを埋めた。Peteが初めて公開した構成を、自社に導入する順番とともに解説する。

YCが1年かけて埋めたギャップ:個人のAI超能力を、会社全体の力に変える
多くの人はすでにAIを使っていて、しかもかなり強く使っている。しかし会社全体に視野を広げると、状況はたいてい変わっていない。個人の効率は上がっても、組織の仕事の進め方は昔のままだ。
YCはシリコンバレーで最も有名なスタートアップ支援機関だ。同社は1年かけて、一つの問題だけに取り組んだ。いま、彼らの会社のAIは毎晩その日の全社の会話を読み、翌日にはもっと使いやすくなっている。この仕組みをどう組み立てたのか。YCのパートナーであるPeteが初めて全体像を公開した。分解すると5層になる。どんな会社でも同じように作れる。
居心地の悪い落差
Peteはある居心地の悪い落差に気づいた。
自分がパソコンでClaude Codeを使うと、超能力を得たように感じる。ところが会社に戻ると、財務は記帳をし、資金調達ラウンドを登録しなければならない。そのためにはまずエンジニアに要件を伝え、エンジニアがソフトウェアにして返す。一通り終われば、次のラウンドがまた最初から始まる。
彼の考えは単純だった。財務が自分で英語で業務フローを書き、agentに渡して実行させる。エンジニアをこのループから外す。
その背景には、より大きな判断がある。個人がagentを使うことと、組織がagentを使うことの間には大きな隔たりがあり、まだ誰も本当に使いこなせていない。YCがこの1年やったのは、このギャップを埋めることだった。
彼らが作ったシステムは実はシンプルで、三つだけだ。自分で仕事を進められるagent、ツールライブラリ、その下で切り替えられる複数のモデル。本当に複雑なのは、この三つを中心に育っていった5層のやり方だ。
第一層:データ——まずagentが調べられるようにする
第一層はデータだ。
YCのパートナーJaredは、手元のデータでは足りないと考え、深夜にこっそり二つのツールを公開した。一つは本番データベースに対して読み取り専用のクエリを実行するもの、もう一つはデータベースのスキーマファイルを読むものだ。結果は驚くほど良かった。
理由は複雑ではない。YCのほぼすべての業務は自社で作ったソフトウェア上で動いており、データは一つのデータベースに集まっている。投資したすべての会社、すべての創業者、すべての取引、パートナーがCRMに残したノートが、そこにある。agentはスキーマさえ分かれば、どんな質問にも答えられる。
いまでは気軽に聞ける。直近4期に投資した宇宙・航空関連の会社には、どんな投資家がいるのか。以前なら数時間SQLを書き、データチームの順番待ちもしなければならなかった。
ハードルが下がると、みんなの質問は増え、難しい質問もできるようになった。技術背景のない財務の同僚でも、直接質問できる。
では、データが数十のSaaSに散らばっている会社はどうすればいいのか。Garyの方法は、各所のデータを一つの場所に流し込み、agent専用にもう一つのコピーを整理することだ。正規化を追求するのではなく、agentが検索しやすい形に組み直す。
自社で始めるなら、最初の一歩はこれだ。agentに読み取り専用のデータベースアカウントを渡し、スキーマの説明を添える。読み取り専用なら、何でも調べられるが、何も変更できない。
第二層:ツール——agentが実際に「できる」ようにする
データを調べられるようになっても、仕事は実行できなければならない。
ツールとは、agentが実行できる一つの動作だ。たとえば経費を記帳する、会議を設定する。YCは全部署が共有するツールライブラリを作った。最初は20個、いまは350以上あり、財務、採用、office hour、イベント管理などをカバーしている。各チームが自分の仕事をツールにして放り込む。
重要なのは「共有」だ。同じツールを社内agentが呼び出せて、各人のパソコン上のClaude Codeからも呼び出せる。
Peteは、どんな会社に移っても最初にやるのはこの二つだと言う。データの統合と、共有ツールライブラリだ。
自社で一度に全部やる必要はない。YCも財務の一チームから始めた。agentに任せる価値のある仕事があれば、ツールを一つライブラリに足す。
第三層:Skill——「どうやるか」を説明書にする
ツールが解くのは「できるかどうか」で、skillが解くのは「うまくできるか」だ。
skillはツールの上にある説明書のようなものだ。実体はテキストファイルで、こういう案件ではどの手順で、どのツールを使って進める、と書いてある。
YCでの使い方はこう進化した。最初は各自がプロンプトを書き、次にskillとして書き、さらにagent自身にskillを書き換えさせた。うまくいったときは「skillify」と言って、そのやり方を保存し、次は誰でも使えるようにする。
Garyには自分の習慣がある。新しいskillと古いskillが重複していないか、全体として抜けも重複もないかを定期的に確認する。同じことをする10個のskillより、パラメータを持つ1個のほうがいい。
自社の最初のskillは、チームで実際にその仕事をしている人の進め方を書き出すことから生まれる。
第四層:毎晩の振り返りで、skillを自分で強くする
その上にあるのは、skill自身を強くしていくことだ。
YCにはagentがいて、毎晩、全従業員とagentの会話を読み、二つだけ探す。どこかもっとうまくできたか。最初からある情報があればもっと速くできたか。そして対応するskillを書き換える。
例を挙げよう。YCは創業者に、自分の会社を二文で説明するよう求めている。何をしているのか、なぜ注目に値するのか。聞くのは簡単だが、経験豊富な創業者でもうまく書けない人が多い。あるパートナーが直すためのskillを書いた。その後、数人のパートナーが少人数のグループ指導を開き、その期の創業者にその場で書かせ、その場で講評し、その回の文字起こしをskillに与えて自己改善させた。Peteは、いまでは自分よりうまく書くと話す。
Garyのまとめはこうだ。組織の超知能はこうやって生まれる。一つの仕事をskillにし、使った過程を記録し、その記録でskillを改善する。これをすべての仕事でやれば、それ以上複雑なことはない。
自社で始めるなら、まずskillを一つ選び、その会話記録と関連する会議の文字起こしを残し、自分で改善させる。うまく回ったら次へ進む。
第五層:組織——最も難しいのは「公開していい」と思わせること
第五層が最も難しい。技術の話ではなく、組織の話だ。
一つ目は、会話をデフォルトで公開すること。YCでは全従業員とagentの会話を全社が見られ、リアルタイムでSlackチャンネルに流れる。この決定は当時かなり議論された。全員が見られるとして、本当に全部公開していいのか。残った理由は、みんなが他人の使い方を見て初めて使い方を覚えたからだ。公開そのものが制約にもなる。VCのような信頼の高い環境では、機密情報をむしろ誰も乱用しない。
二つ目は、何でも録ること。会議、議論、文書はすべてagentの振り返り素材になる。二年前は会議の録音に抵抗があったが、いまはほとんど当たり前になった。
三つ目は、金をかけること。Garyは、年間1万〜10万ドルをtokenに使うのは、2028年に先に生きるようなものだと言う。今日10万ドルかかることが、来年は1万、再来年は数百ドルになる。90年代にいち早く従業員へパソコンを配った会社と同じだ。
彼らの結論は、そうした組織は十分に平等で、デフォルトで信頼していなければならない、というものだ。そして世界のほとんどの組織は、まさにこの二点ができない。大企業はデータを閉じている。理由は安全ではないからだ。
見返りは具体的だ。以前は新人が一人前になるまで半年かかった。いまはagentに最高のパートナーの仕事のやり方が入っていて、新人は来たその日から学べる。同僚に聞きにくいことも、まずagentに聞ける。
自社でも、まず一つのチームで、全員とagentの会話を一つのグループに公開するところから始められる。
逆から考える:AIは土台であって、プラグインではない
Peteは『五頭立ての馬車』という話題の記事を書いた。ほとんどのAI製品は古いソフトウェアに少しAIを詰め込んでいるだけだ、と彼は言う。YCのやり方はその逆で、AIが土台になり、ツールとプロセスがその上に育つ。
この5層をもう一度つなげよう。データを一カ所に集め、ツールをみんなで共有し、やり方をskillに書き、毎晩記録で振り返り、会話を全員に公開する。
モデルはむしろ最も気にしなくていい部分だ。難しいのは第一層と第五層、データを一カ所に集めることと、みんなが公開して使いたいと思えることだ。
一つだけやるなら、一つのチーム、一つの読み取り専用データベースアカウントから始めよう。この回は保存して、自社と照らし合わせ、どの層で詰まっているか見てほしい。