智能体缺的不是更聪明的模型,而是“懂业务”
AI 智能体难以在企业中可靠行动,原因往往不是模型推理能力,而是缺少业务知识。Neo4j 发布的 Context Engine 用六层业务本体,把流程、术语、数据位置、权限与历史决策组织成一张图,并以 GraphRAG 检索和记忆学习支撑智能体。本文梳理其思路,也讨论 private preview 阶段仍需验证的问题。

智能体缺的不是更聪明的模型,而是“懂业务”
一个 AI 智能体在系统里查到账户状态是“2”,它大概率不知道这意味着“暂停待审核”。写这段代码的工程师知道,熟悉业务的老员工也知道——有人把它写在便签上,有人把它放进 BI 报表里。但智能体拿不到这些上下文。
Neo4j 发布的 Context Engine 是 Neo4j Graph Intelligence Platform 的一部分,瞄准的正是这个断层。它想解决的不是“模型会不会推理”,而是“智能体知不知道企业里的词是什么意思、流程怎么走、数据在哪里、哪些能碰”。Neo4j 把这件事称为 agent knowledge problem,并把它形容为“万亿美元级的 AI 瓶颈”:智能体如果不懂组织如何运转,就无法在规模化场景里可靠行动。
这个判断值得认真对待,因为它把讨论从模型能力拉回到了知识工程。
智能体是一种全新的数据消费者
过去几十年,消费数据的主要是两类对象:应用程序和人。数据的含义因此藏在两个地方——代码里,和人的记忆里。应用知道账户状态“2”等于“暂停待审核”,因为这条规则写在代码里;人知道,是因为有经验,因为写过便签,因为在 BI 工具里见过。
智能体两者都没有。它能看到字段,却看不到字段背后的约定。
更麻烦的是,同一家企业的不同部门对同一个词的理解并不一致。“客户”在市场营销部门和在财务部门可能指的不是同一批人。再加上数据分散在多个云、平台和供应商那里,智能体常常连“该去哪里找”都不知道。语义不清、定义冲突、数据碎片化,这三件事叠在一起,构成了智能体落地时最难绕开的障碍。
六层本体:把“懂业务”拆成可建模的结构
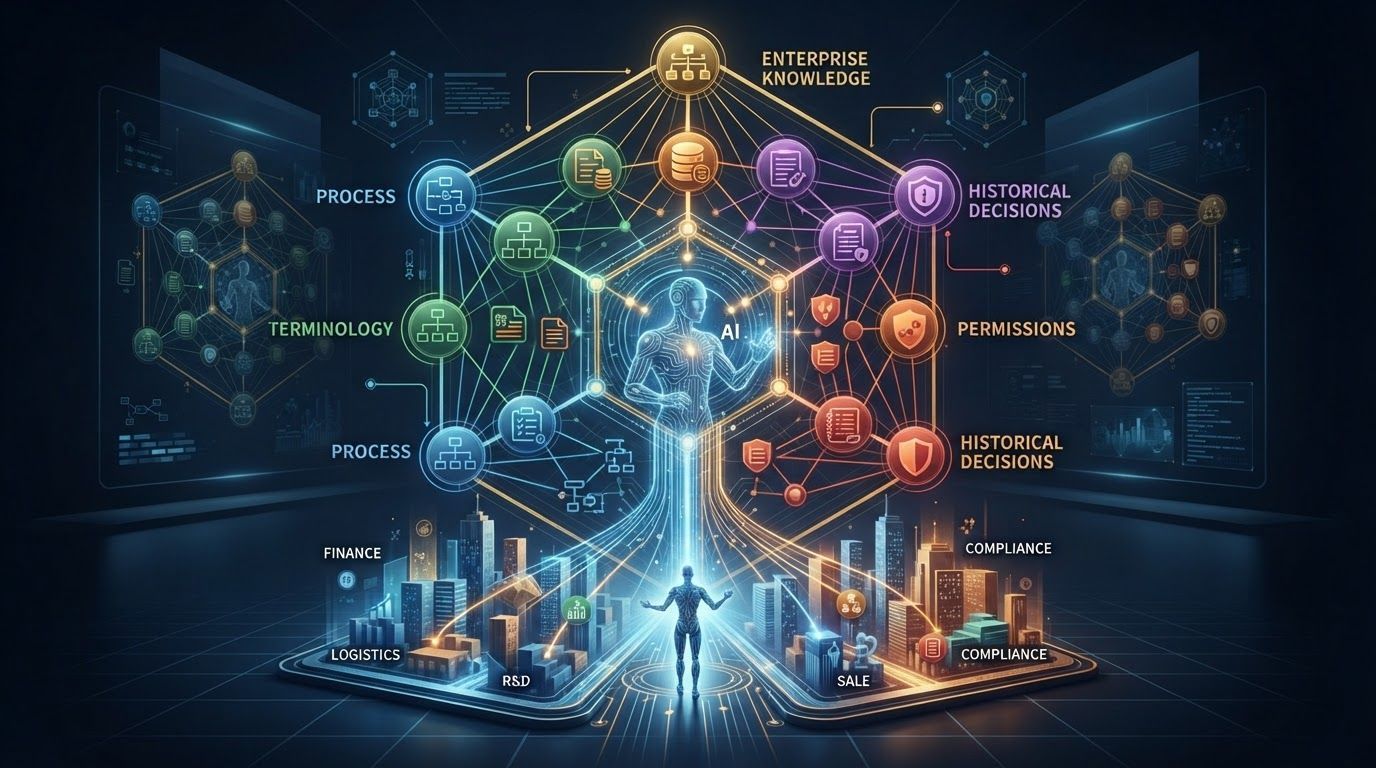
Neo4j 的解法是一套相互连接的业务本体,共六层。它把“懂业务”这句听起来很虚的话,拆成了可以逐层定义和治理的结构。
前两层负责“理解”:
- 业务流程与组织层:描述组织如何运转,有哪些规则和流程。
- 领域本体层:定义关键术语和概念,让智能体知道专业词汇的含义。
中间三层负责“连接”:
- 数据产品层:确定哪些信息可以被使用。
- 物理系统层:确定这些信息实际存放在哪里。
- 工具与集成层:确定如何连接过去、以什么方式访问。
最后一层负责“学习”:
- 运行时知识层:让智能体记住过去的决策和行动,并从中积累经验。
这三组能力分别对应理解业务、找到数据、持续学习。把它们放在同一张图里,智能体才有可能既知道“客户”指谁,也知道该去哪个系统取数、取完能做什么、做完之后留下了什么。
三个组件,对应三种能力
Context Engine 由三个核心组件构成,和上面的三种能力一一对应。
Business Ontology for Agents 是企业在 Neo4j 中定义、存储并执行的图模型。它记录业务概念的含义、业务流程如何运作,以及概念与流程之间如何关联。智能体借助它理解问题和任务的性质,包括相当复杂的那一类。
Context Build and Runtime 解决“数据在哪里、能不能用”。它让智能体跨云、跨平台、跨供应商地获取所需信息,并内置治理机制,确保智能体只能访问被授权的数据。检索方式上,它采用 GraphRAG,而不是纯向量检索。Neo4j 声称 GraphRAG 比 vector-only RAG 更准确,也更省钱。
Memory and Learning 负责让智能体越用越熟,这在持续变化的企业环境中尤其关键。短期记忆、长期记忆和推理记忆被放在与业务语义相同的图里,每一次决策以及决策路径都会被记录和存储。这样,智能体的学习材料不是凭空生成的摘要,而是自己走过的路径。
图结构带来的,不只是检索
把关系显式建模,是这套方案和“把文档切块、做向量检索”最根本的区别。关系一旦成为图里的边,智能体就可以沿着边推理,并在需要时说明自己是如何得出答案的。对于企业场景,这种可解释性和可追溯性往往比多回答对一道题更重要。
另一个实际考虑是,企业不必换掉现有的 LLM 和 agent 框架。Context Engine 提供的是上下文与知识层,而不是又一个要迁移过去的开发平台。配套的 Context Studio 则把本体的管理和治理收进一个控制平面,降低长期维护的复杂度。
边界:哪些是已交付的,哪些仍需验证
需要说清楚的是,Context Engine 目前处于 private preview 阶段,企业需要通过设计合作伙伴的方式接入。这意味着上面描述的能力,多数还没有经过大规模生产环境的公开检验。
至少有三件事值得在评估时追问。第一,GraphRAG 相对纯向量检索的准确率和成本优势,目前来自厂商的表述,仍需要企业用自己的数据验证。第二,治理机制是否真的做到“只能访问被授权的数据”,要看它和现有权限体系的对接深度。第三,六层本体不是配置出来的,而是需要业务、数据和平台团队共同梳理和维护的知识资产——这部分投入,往往比接入一个检索服务大得多。
可靠智能体,终究是知识问题
围绕智能体的讨论很容易滑向模型参数、上下文窗口和推理技巧。但企业真正卡住的地方,常常是一个更朴素的问题:智能体不知道“2”是什么意思,不知道“客户”指谁,也不知道数据在哪个系统里。
Neo4j Context Engine 的价值主张,是把这些散落在代码、便签、报表和人的经验里的约定,收拢成一张可治理、可推理、可追溯的图。这个方向是否成立,取决于企业愿不愿意把业务语义当作一项长期资产来建设。模型会继续变强,但业务含义不会因此自动变得清晰。