エージェントに足りないのは「業務を理解する力」——Neo4j Context Engineと六層オントロジー
AIエージェントが企業で信頼できる行動を取れない原因は、モデルの推論力ではなく業務知識の欠如にある。Neo4jが発表したContext Engineは、業務プロセス、ドメイン用語、データの所在、権限、過去の意思決定を六層のオントロジーとしてグラフにまとめ、GraphRAGによる検索と記憶・学習を提供する。private preview段階にある意義と検証課題を整理する。

エージェントに足りないのは、より賢いモデルではなく「業務を理解する力」だ
AIエージェントがシステム上で口座ステータス「2」を見つけても、それが「審査待ちによる停止」を意味するとは、まず分かりません。コードを書いたエンジニアは知っていますし、業務に慣れた社員も知っています。誰かが付箋に書いたかもしれないし、BIレポートに載せたかもしれません。しかしエージェントは、その文脈にたどり着けません。
Neo4jが発表したContext Engineは、Neo4j Graph Intelligence Platformの一部として、まさにこの断絶を狙っています。問いにしているのは「モデルが推論できるか」ではなく、「企業の言葉の意味、業務の流れ、データの所在、触れてよい範囲をエージェントが知っているか」です。Neo4jはこれをagent knowledge problemと呼び、「兆ドル規模のAIボトルネック」と表現しています。組織の動き方を理解しなければ、エージェントは規模を拡大しても信頼できる行動ができない、というわけです。
この指摘は真剣に受け止める価値があります。議論の焦点を、モデルの性能からナレッジエンジニアリングへ戻すものだからです。
エージェントは「新しい種類のデータ消費者」である
過去数十年、データを消費してきたのはアプリケーションと人間の二種類でした。データの意味は、そのため二つの場所に宿っています。コードと、人の記憶です。アプリケーションは口座ステータス「2」が「審査待ちによる停止」だと知っています。そのルールがコードに書かれているからです。人間は経験から、あるいは付箋に書いたから、BIツールで見たから知っています。
エージェントには、どちらもありません。フィールドは見えても、その背後の取り決めが見えないのです。
さらに厄介なのは、同じ企業でも部門によって同じ言葉の意味が違うことです。マーケティング部門の「顧客」と財務部門の「顧客」は、同じ集団を指していないかもしれません。加えて、データは複数のクラウド、プラットフォーム、ベンダーに分散しています。エージェントは「どこを探せばいいか」すら分からないことが多い。意味の不明確さ、定義の衝突、データの分断。この三つが重なり、エージェント導入で最も避けにくい障害になります。
六層のオントロジー:「業務理解」をモデル化できる構造に分解する
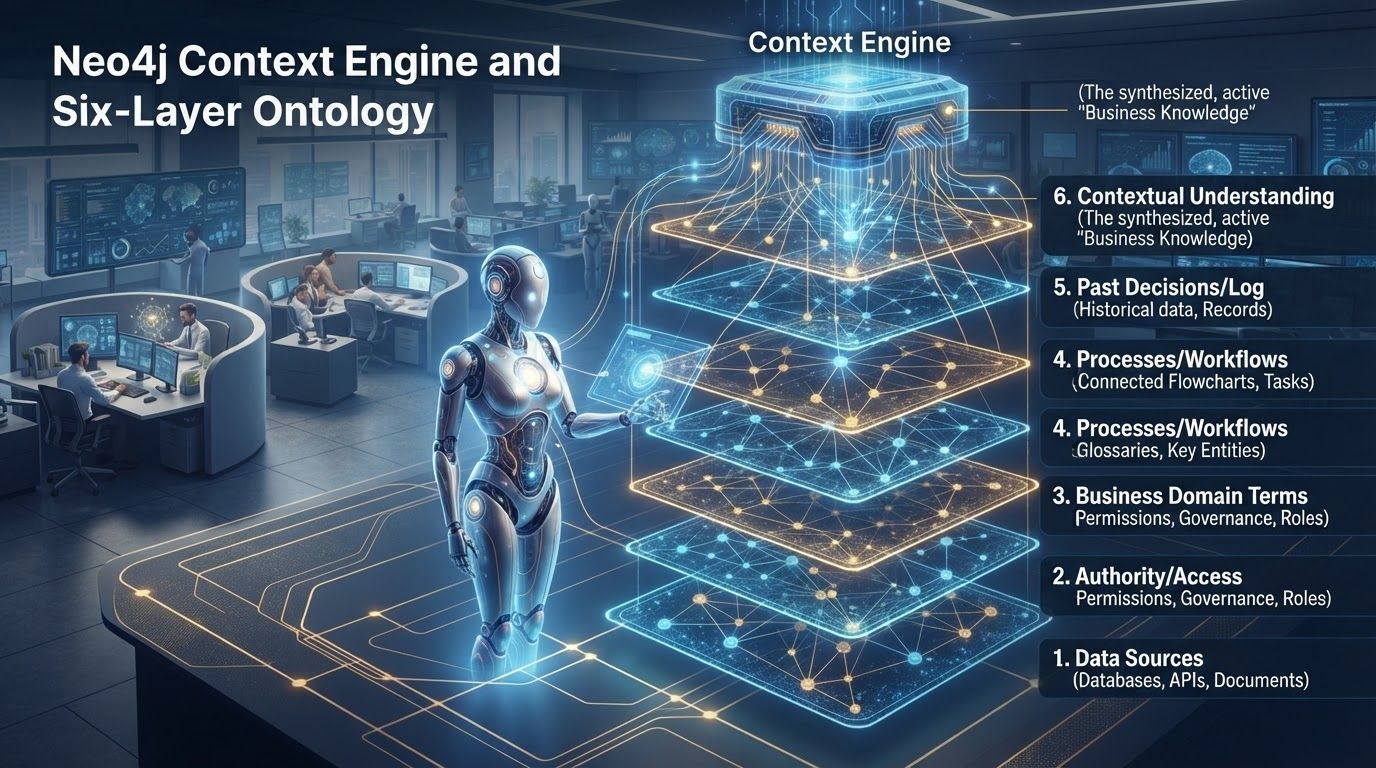
Neo4jの答えは、相互に接続された六層の業務オントロジーです。「業務を理解する」という漠然とした言葉を、層ごとに定義し、ガバナンスできる構造へと分解します。
前半の二層が「理解」を担います。
- 業務プロセスと組織の層:組織がどう動くのか、どんなルールとプロセスがあるのかを記述する。
- ドメインオントロジーの層:主要な用語と概念を定義し、専門的な語彙の意味をエージェントに伝える。
中間の三層が「接続」を担います。
- データプロダクト層:どの情報を使えるのかを決める。
- 物理システム層:その情報が実際どこに置かれているのかを決める。
- ツールと統合の層:どうやって接続し、どの方法でアクセスするのかを決める。
最後の一層が「学習」を担います。
- ランタイムナレッジ層:過去の意思決定と行動を記憶し、そこから経験を積ませる。
三つの能力はそれぞれ「業務を理解する」「データを見つける」「学び続ける」に対応します。これらを同じグラフに置くことで、エージェントは「顧客」が誰を指すのかを知り、どのシステムへ取りに行けばいいのかも分かり、取ったデータで何ができるのか、やったことが何を残したのかまで扱えるようになります。
三つのコンポーネント、三つの能力
Context Engineは三つのコアコンポーネントで構成され、上の三つの能力と一対一で対応します。
Business Ontology for Agents は、企業がNeo4jの中で定義し、保存し、適用するグラフモデルです。業務概念の意味、業務プロセスの進み方、概念とプロセスの関係を記録します。エージェントはこれを使って、問いやタスクの性質を理解します。かなり複雑なものも含まれます。
Context Build and Runtime は「データがどこにあり、使えるのか」を解決します。クラウド、プラットフォーム、ベンダーをまたいで必要な情報にアクセスさせ、組み込みのガバナンスで、認可されたデータにしか触れられないようにします。検索方式にはGraphRAGを採用し、純粋なベクトル検索だけのRAGは使っていません。Neo4jは、GraphRAGのほうがvector-only RAGより正確で、コスト効率も良いと主張しています。
Memory and Learning は、使うほどエージェントが賢くなることを担います。変化し続ける企業環境では、これが特に重要になります。短期記憶、長期記憶、推論記憶を業務セマンティクスと同じグラフに置き、意思決定とその経路をすべて記録・保存します。学習の材料は、どこからか生成された要約ではなく、自分がたどった経路そのものになります。
グラフ構造がもたらすのは、検索だけではない
関係を明示的にモデル化する点が、「文書を分割してベクトル検索する」方式との最も根本的な違いです。関係がグラフの辺になれば、エージェントは辺をたどって推論し、必要ならなぜその答えに至ったのかを説明できます。企業の現場では、この説明可能性と追跡可能性のほうが、一問正解することより重要であることも少なくありません。
実務上の利点ももう一つあります。企業は既存のLLMとエージェントフレームワークを替えずに済みます。Context Engineが提供するのは、また別の開発プラットフォームへ移行させることではなく、コンテキストとナレッジの層です。付属のContext Studioは、オントロジーの管理とガバナンスを一つのコントロールプレーンにまとめ、長期的な保守の複雑さを下げます。
境界:すでに提供されているもの、これから検証すべきもの
はっきりさせておくべきは、Context Engineが現在private preview段階にあり、企業はデザインパートナーとして参加する必要があるという点です。ここまで述べた能力の多くは、大規模な本番環境で広く公開検証されたものではありません。
評価の際には、少なくとも三つを問うべきでしょう。第一に、GraphRAGが純粋なベクトル検索に対して持つ精度とコストの優位性は、現時点ではベンダーの説明であり、企業自身のデータで検証する必要があります。第二に、ガバナンスが本当に「認可されたデータにしか触れさせない」のかは、既存の権限体系とどこまで深く接続できるかにかかっています。第三に、六層のオントロジーは設定作業ではなく、業務、データ、プラットフォームの各チームが共同で整理し、維持する知識資産です。この投資は、検索サービスを一つ導入するより大きくなることが多いはずです。
信頼できるエージェントは、結局ナレッジの問題である
エージェントをめぐる議論は、モデルのパラメータ、コンテキストウィンドウ、推論テクニックへと流れがちです。しかし企業が本当に詰まるのは、もっと素朴な問いです。エージェントは「2」が何を意味するのか知らず、「顧客」が誰を指すのかも知らず、データがどのシステムにあるのかも知らない。
Neo4j Context Engineの価値提案は、コード、付箋、レポート、人の経験に散らばった取り決めを、ガバナンスでき、推論でき、追跡できる一つのグラフにまとめることです。この方向が成立するかは、業務の意味を長期的な資産として育てる気が企業にあるかどうかにかかっています。モデルはこれからも強くなりますが、業務の意味がそれだけで明確になるわけではありません。