模型不是瓶颈:Agent 落地真正缺的,是一层「可被理解」的数据上下文
生成式 AI 正从「输入问题、返回答案」走向「给出目标、代理自主执行」。本文整理 Google Cloud 讲者关于 Agent 落地的判断:很多幻觉不是模型问题,而是业务定义没有写进上下文;PoC 规模一放大就会遇到成本、延迟、治理与复现性问题;解法是用数据源、元数据、语义层和计算口径搭起上下文架构,并用五类问题各 20 次的对比实验与银行、营销演示说明效果。

模型不是瓶颈:Agent 落地真正缺的,是一层「可被理解」的数据上下文
2023 年,大多数人使用生成式 AI 的方式,是在聊天框里输入一句话,等它回一段文字、一段 SQL 或一份草稿。到了现在,交互方式正在变成另一种样子:人给出目标,AI 代理自己拆解任务、调用工具、执行、检查,再回来交付结果。
这个变化听起来只是「能力更强了」,但真正决定企业能不能用起来的,往往不是模型本身。在一场关于数据与 AI 的分享中,Google Cloud 的讲者把问题指向了另一个地方:当代理开始替人做分析、做报表,甚至接手一部分分析师的工作,企业缺的是一层能把业务定义、数据含义和计算口径讲清楚的「上下文」。没有这层上下文,模型越强,错误可能越自信。
从「生成一段 SQL」到「完成一个目标」
讲者回顾了这个转变:早期大家让 AI 生成 SQL、生成文案,本质上是「给一个问题,换一个答案」。现在更受关注的是代理(agent)——你给它一个目的,它在过程中自己决定下一步做什么。
这个趋势已经进入实际业务。讲者提到,有企业(例如 Mercari)把分析型代理用在分析工作上,目标不是「生成一个查询」,而是替代一部分原本由人完成的分析流程:不仅给出结果,还要结合用户背景和业务课题,进一步提出该采取什么行动。
他把代理需要的能力拆成几层:技能层负责调用工具、生成 SQL、写报告;执行框架(harness)负责计划、执行、检查的循环,以及写进系统里的指令;再往外,才是模型本身。
但只有这几样,离「能干活」还差一步。讲者的意思很直接:这些还不够,实际业务里还缺东西。
幻觉有时候不是模型的问题,而是定义的问题
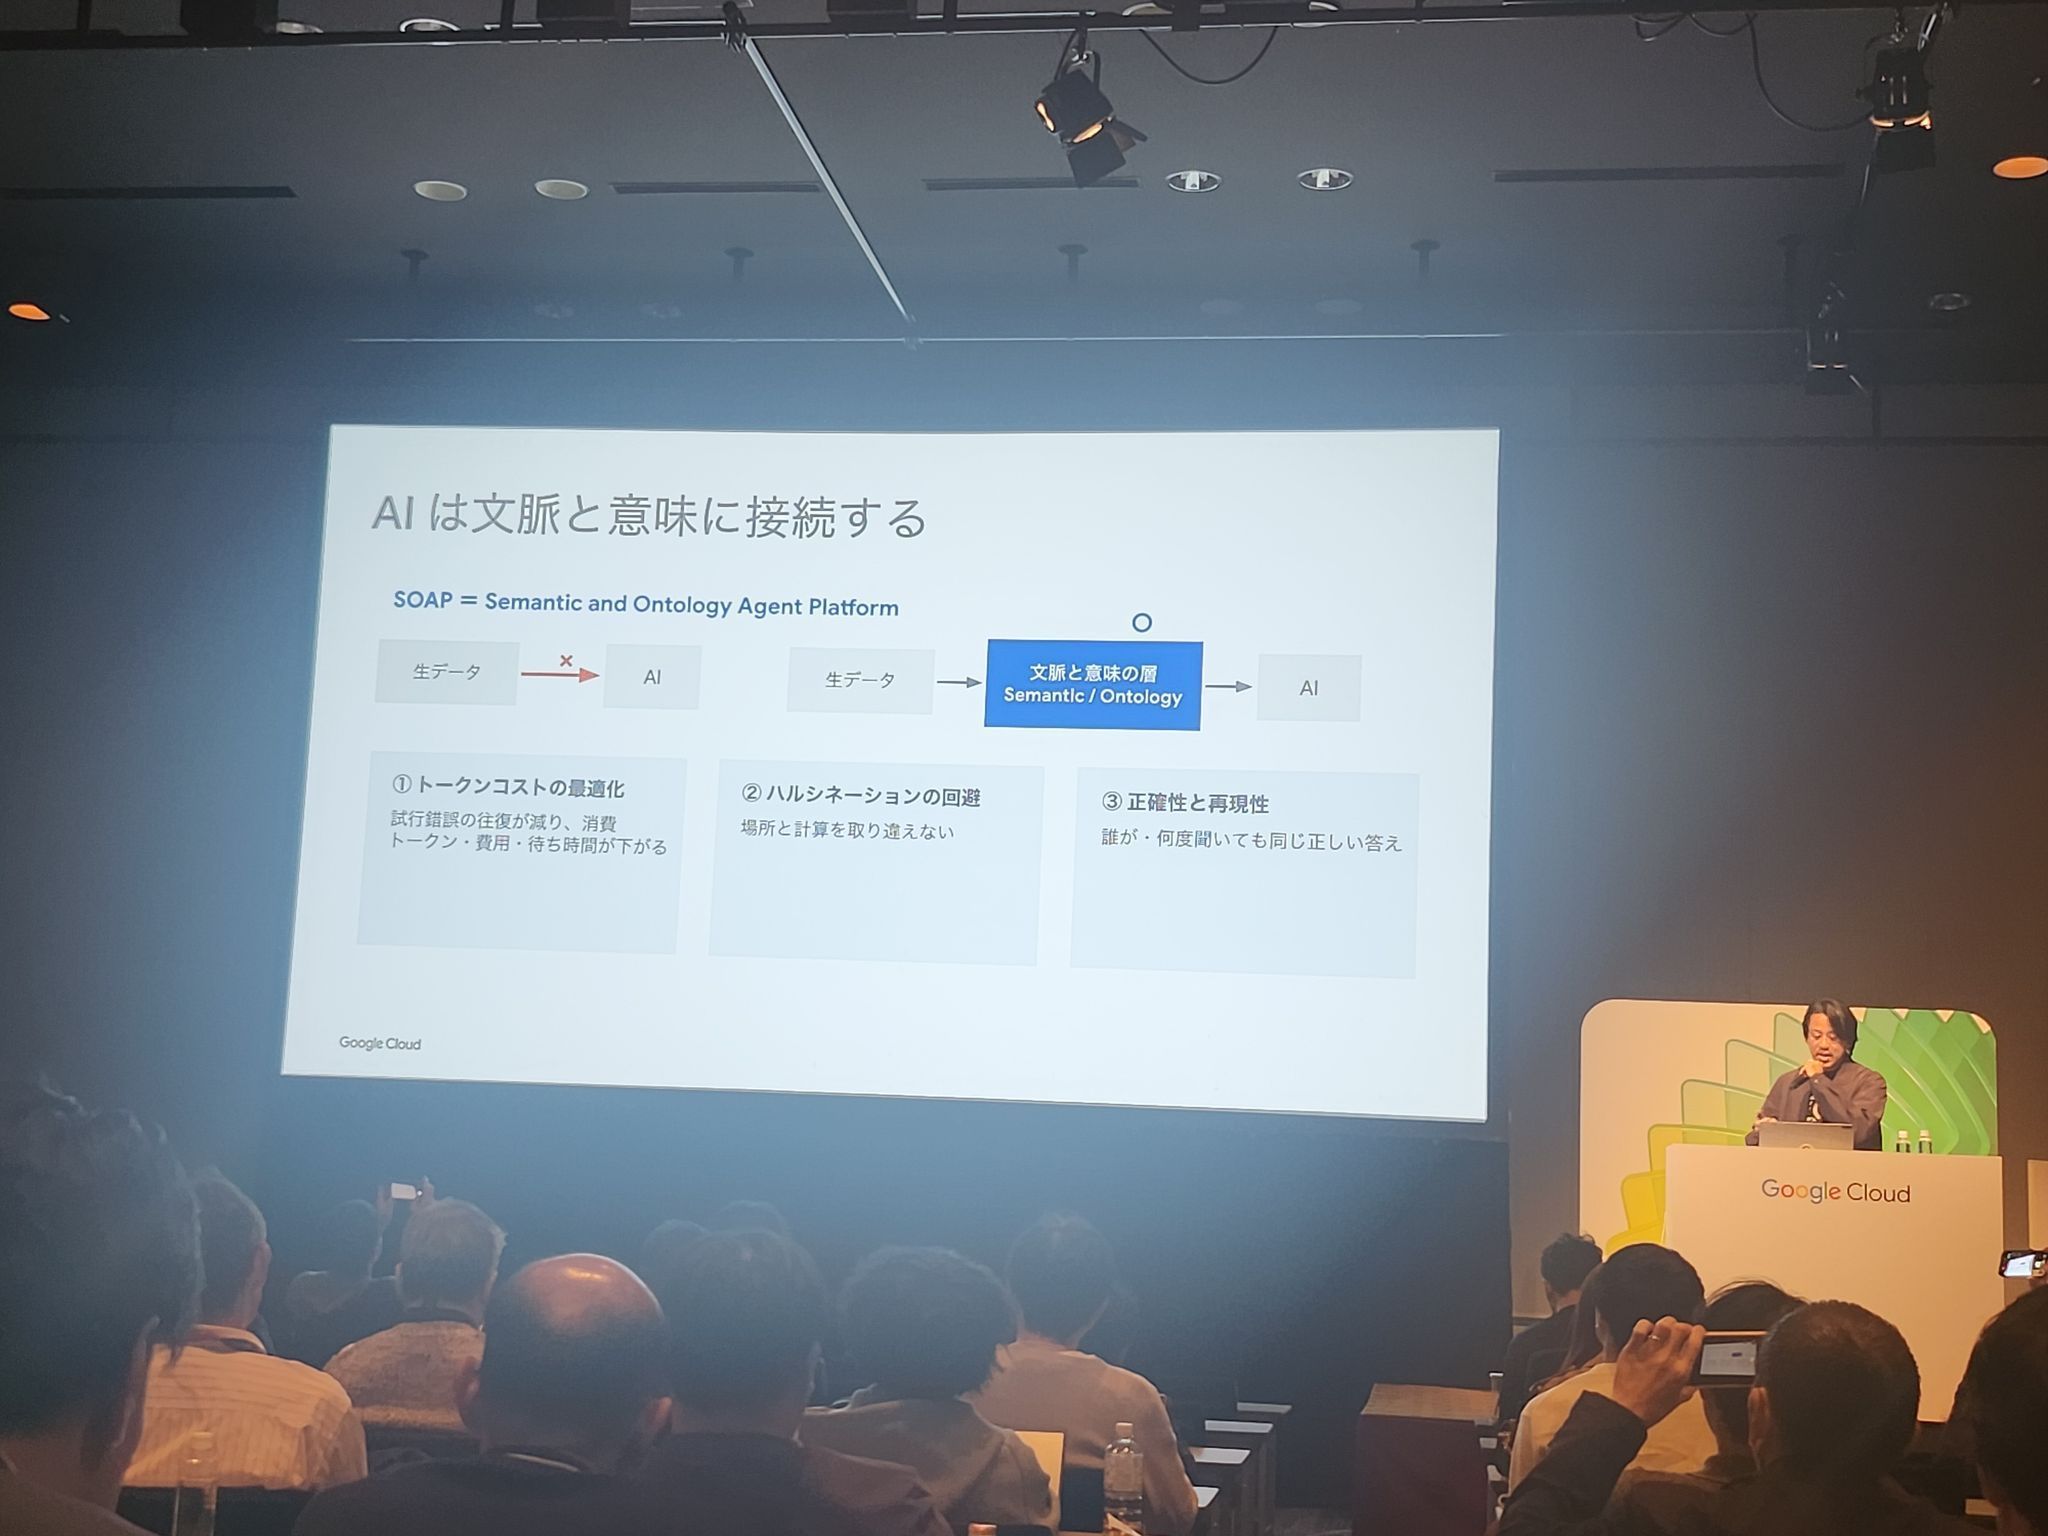
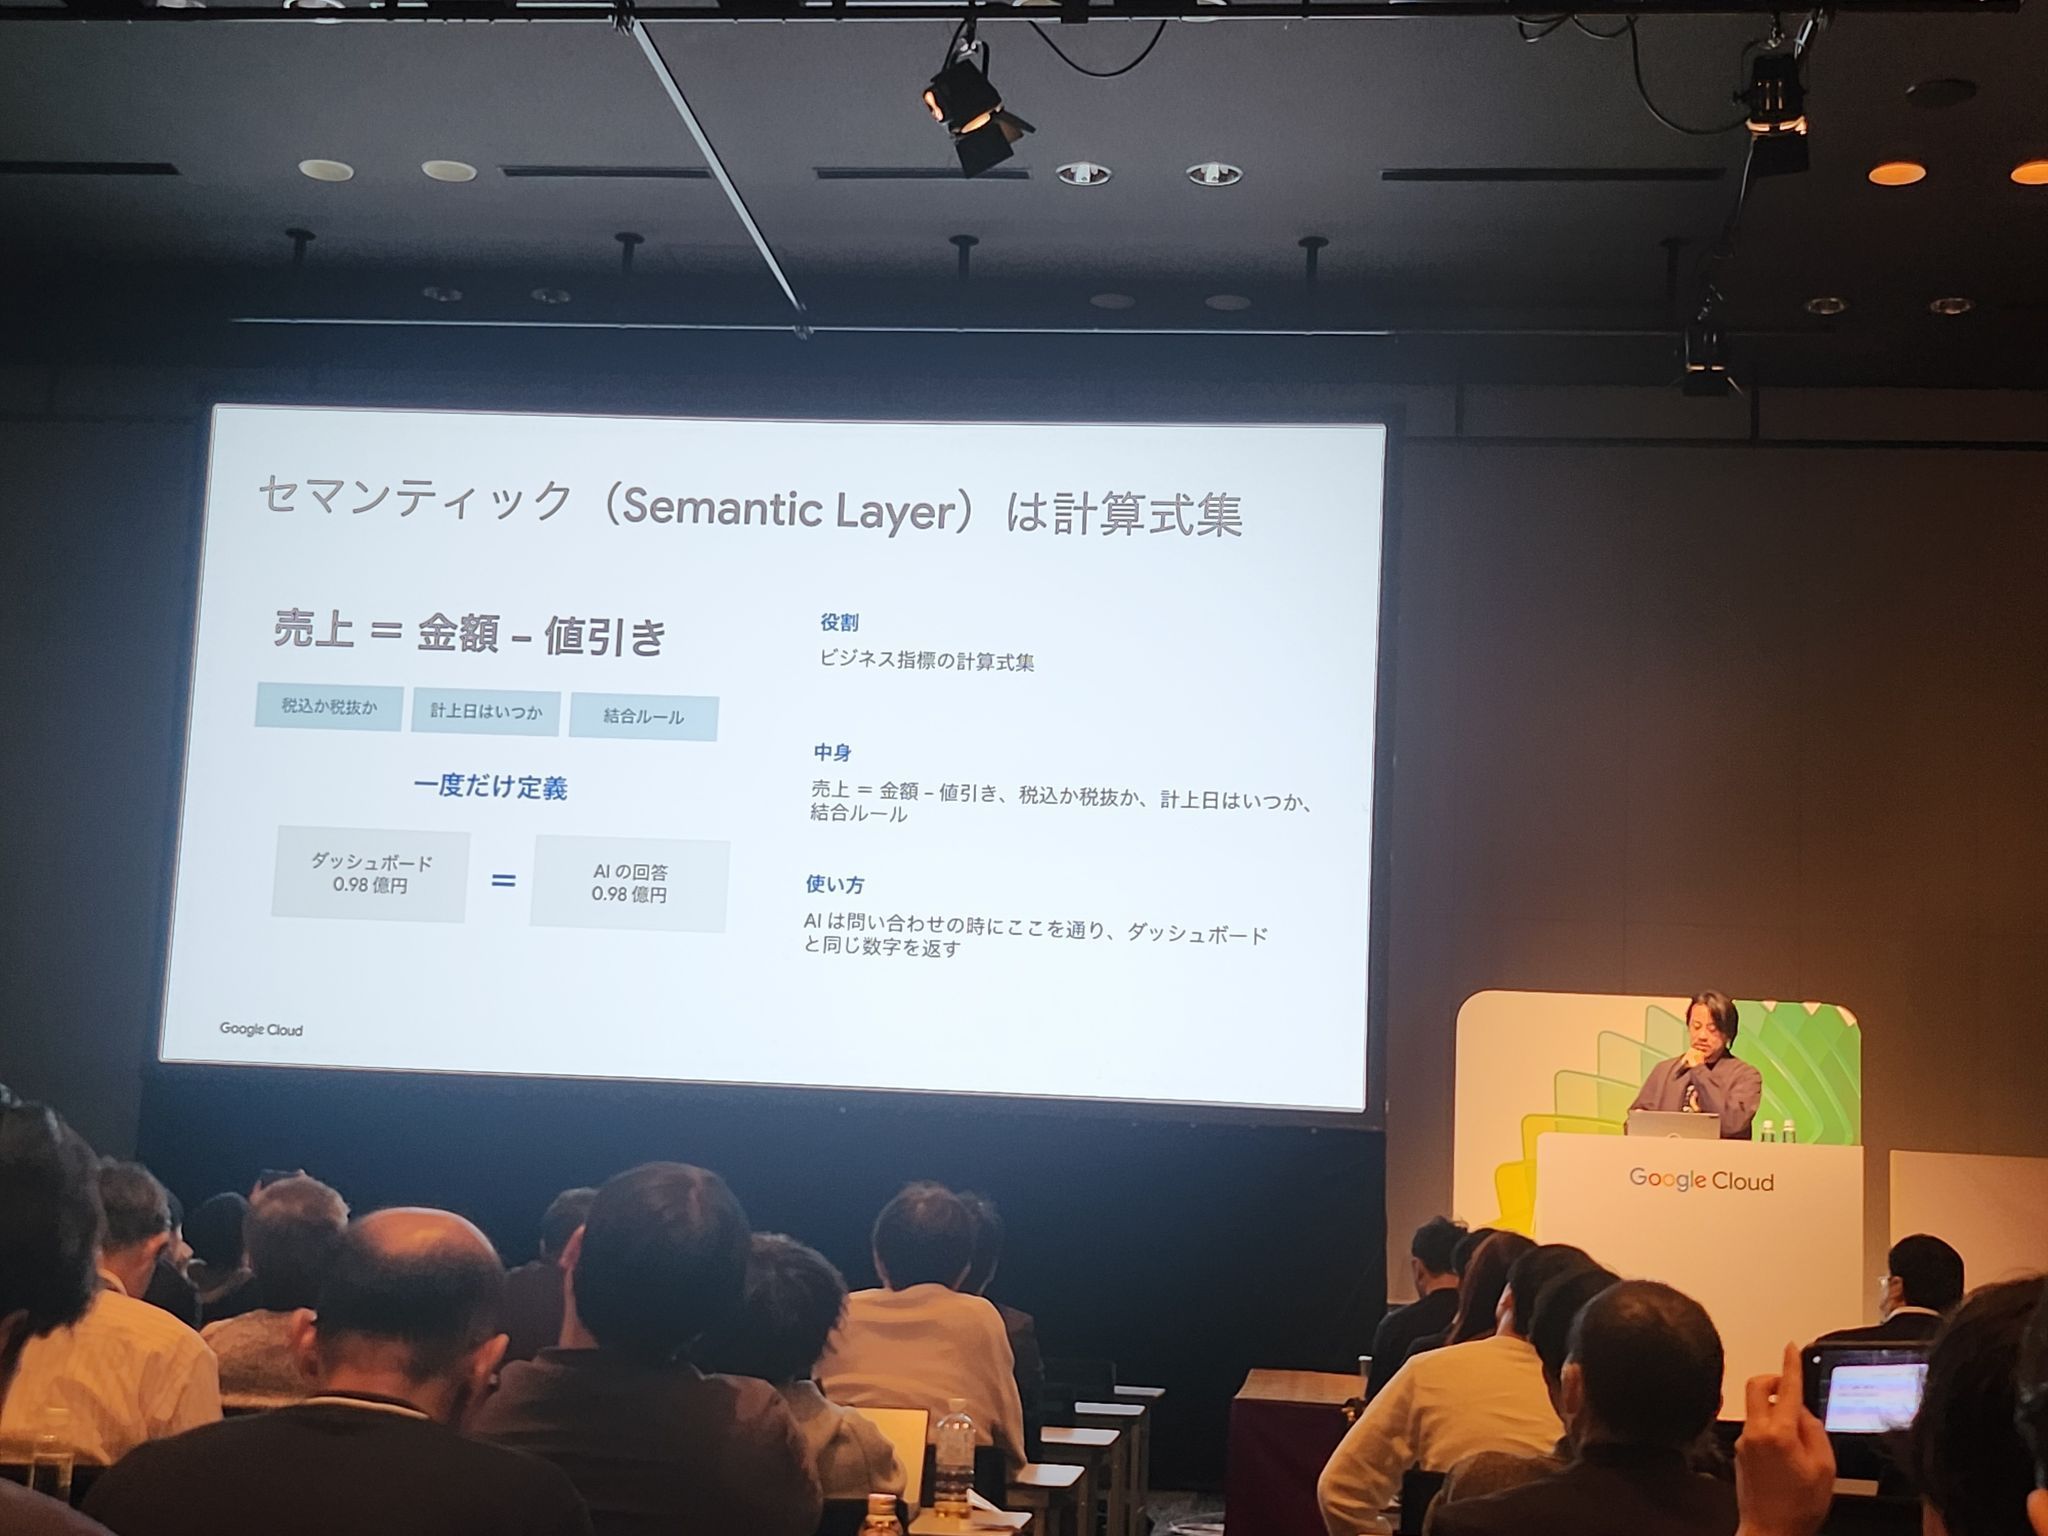
他举了一个很小的例子:同样叫「销售额」,市场部门和财务部门说的可能不是同一个数。
市场部门看的可能是交易发生时的金额,含税,按订单或收款的口径统计;财务则要按会计规则处理,去掉税、按收入确认的规则入账、再扣除某些项目。两种算法在自己的语境里都「对」,但如果没有把「我们此刻说的是哪一种销售额」讲清楚,代理就会在两种定义之间来回跳,最后给出一个看起来合理、实际上对不上的数字。
这类错误常被归因于「模型幻觉」。讲者的判断是:问题不一定出在模型,而出在定义没有被写进上下文。模型不知道你公司的「销售额」到底指什么,它只能猜。
这个例子之所以重要,是因为它解释了为什么很多 Demo 很惊艳、一进业务就失灵。Demo 里的问题通常是孤立的、定义清晰的;真实业务里的问题,背后挂着一整套组织约定。
PoC 能跑通,规模一上来就撞墙
另一个常见的坑是 PoC(概念验证)。讲者说,做一个场景的 SQL、跑通一条链路,通常不难。难的是把它复制到几十个、几百个场景,并且 24 小时承接大量问询。
这时会同时出现几个问题:
- 成本:每次都让大模型从头理解表结构和业务口径,token 消耗很快;
- 延迟:复杂问题要来回多轮,用户等不了;
- 治理:谁可以看哪些数据、哪些定义能被哪些代理使用,需要权限和审计;
- 可复现:同一个问题,今天和明天、这个人和那个人,答案必须一致。
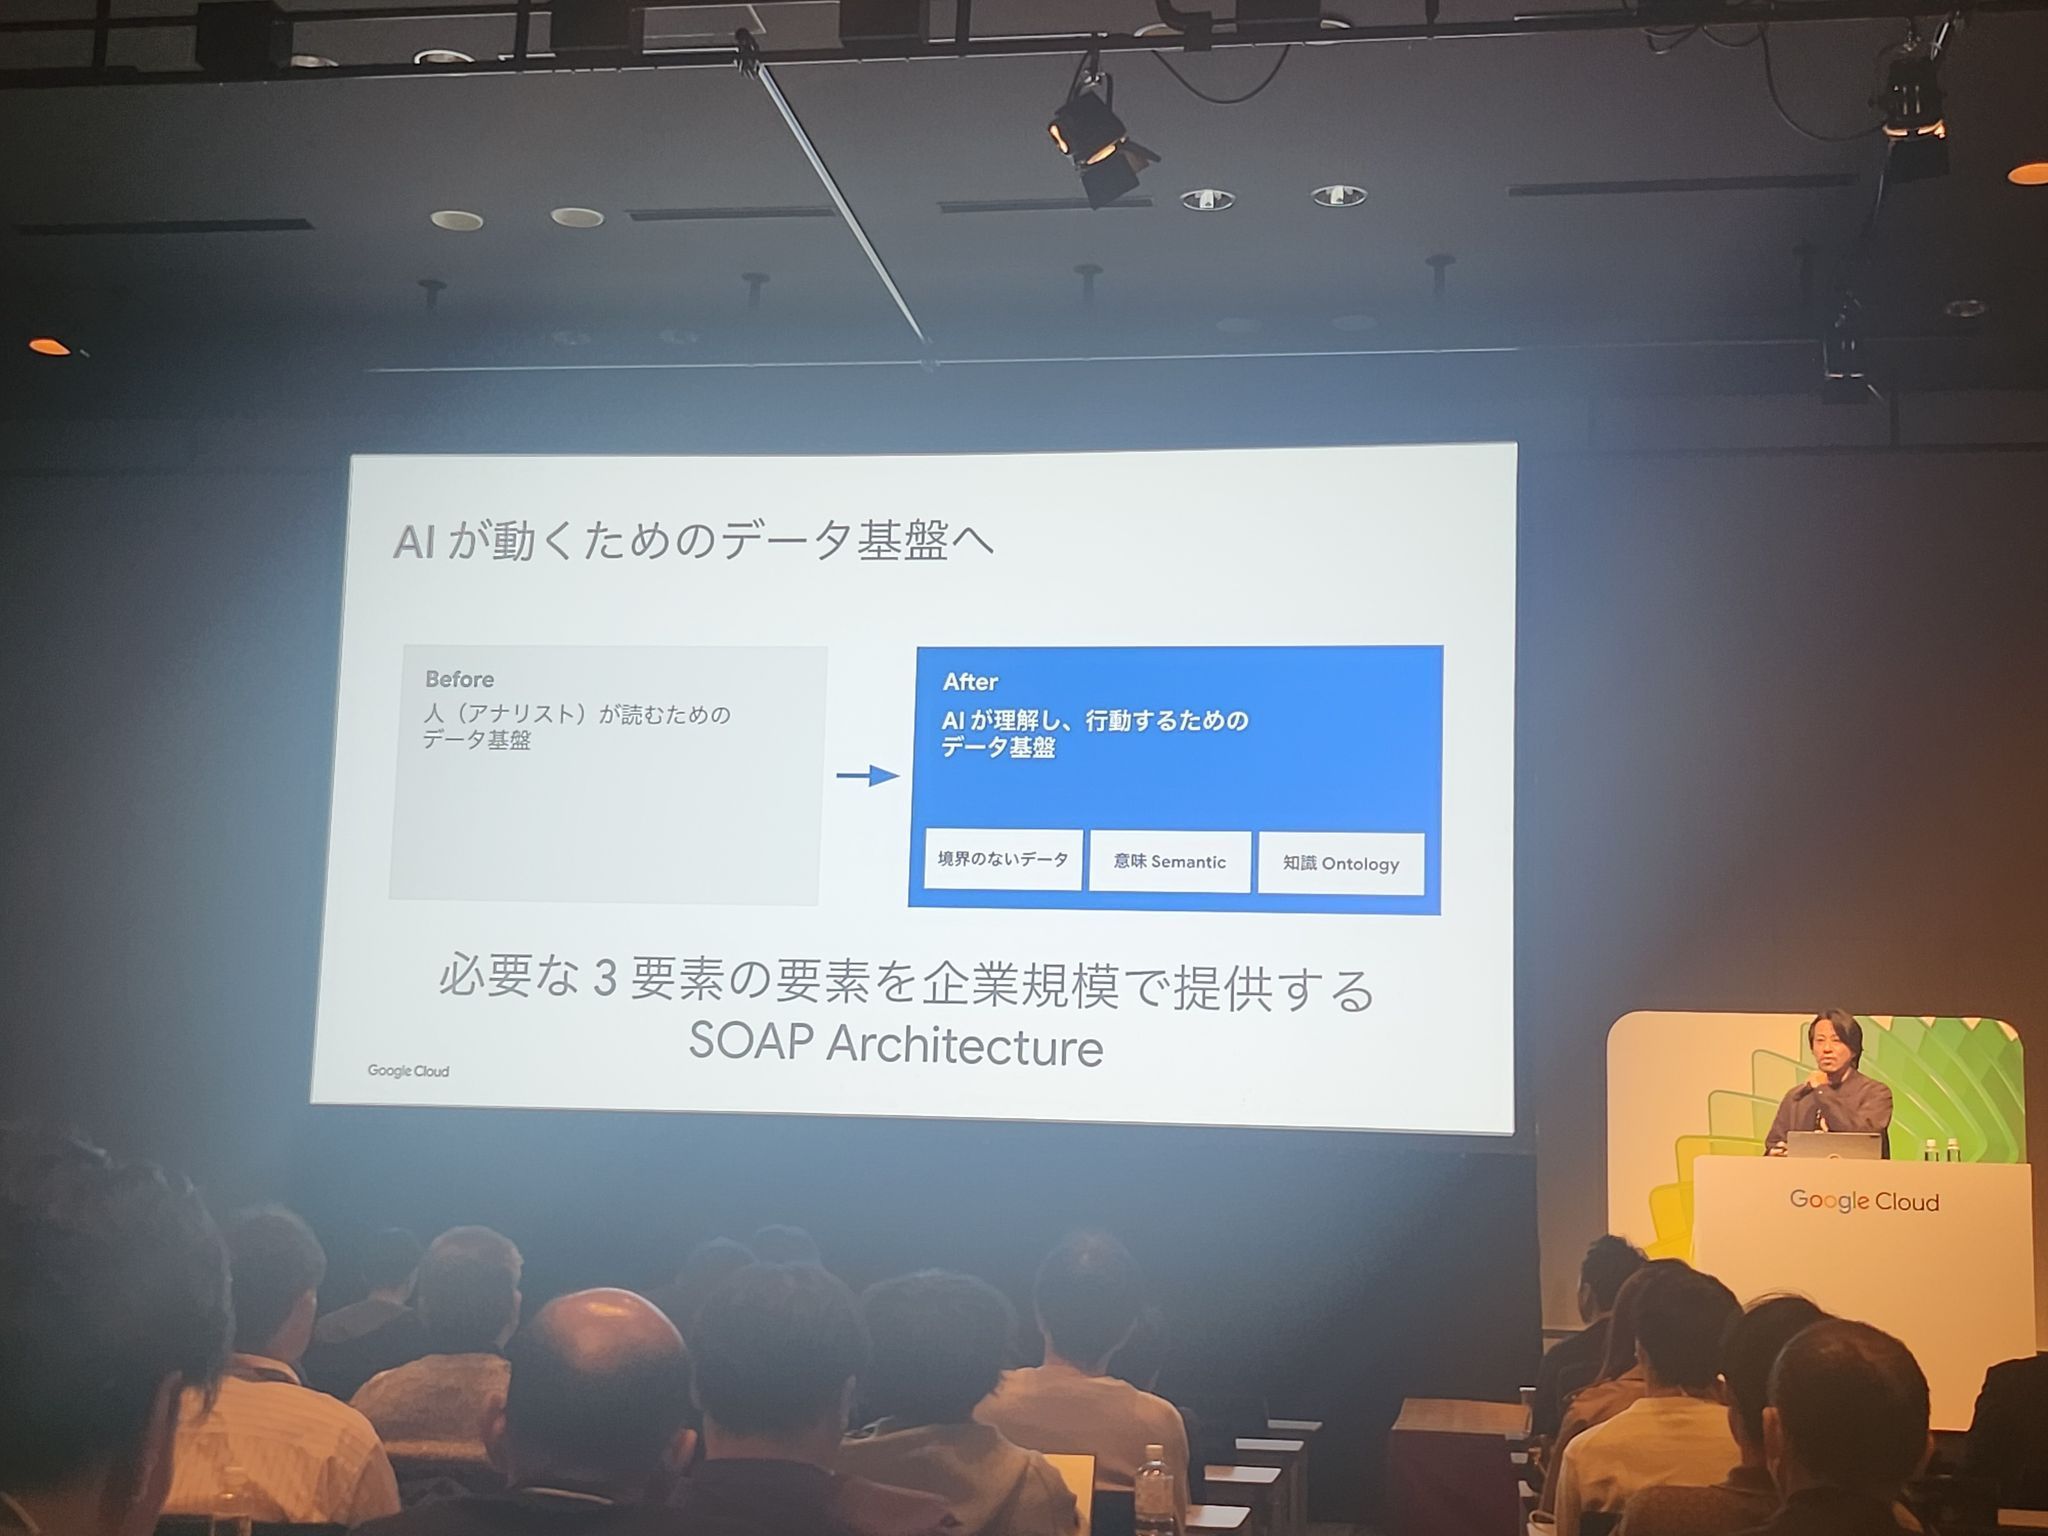
所以数据基座的定位也变了。过去的数据平台主要是「给人读的」:人去看报表、查数、做分析。现在它还要「给 AI 理解并行动」:代理要能在里面找到数据、理解含义、按正确口径计算,并且不越权。
上下文架构:把「数据是什么」讲清楚
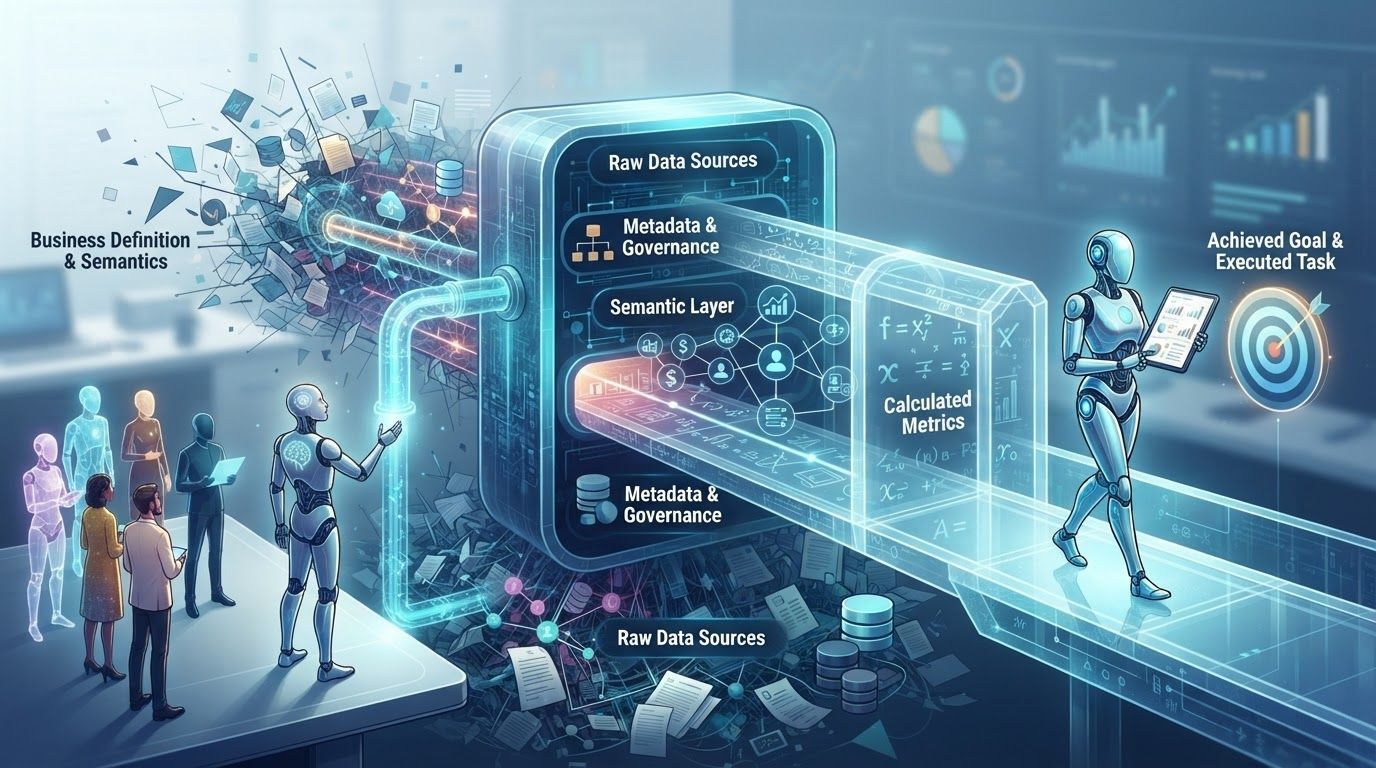
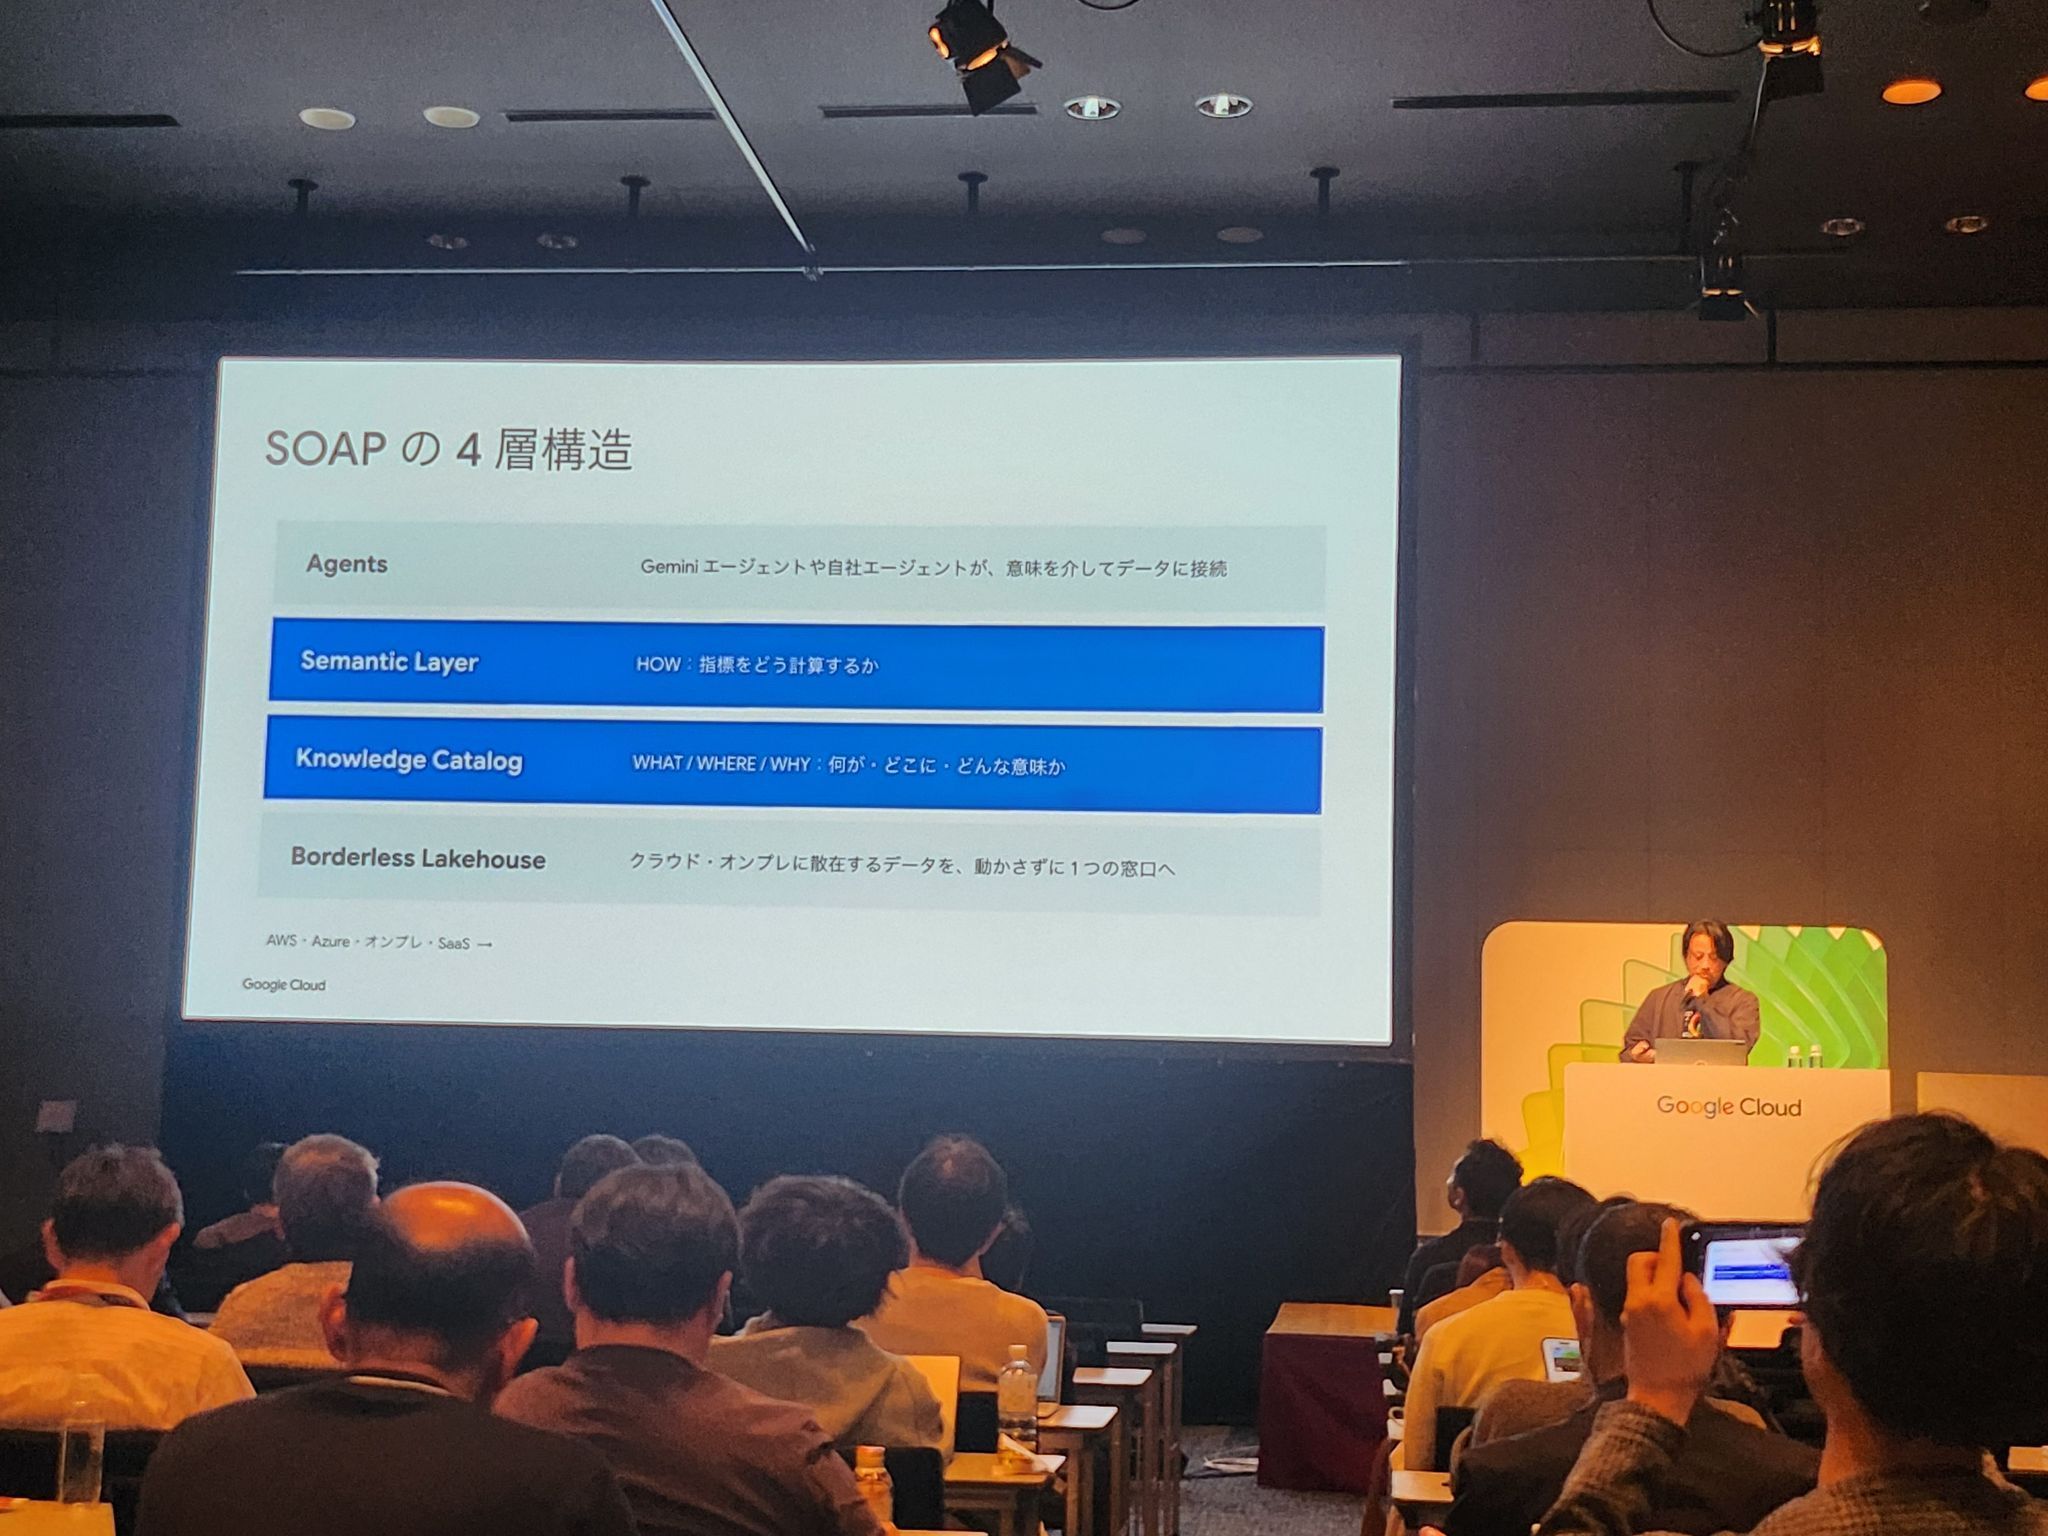
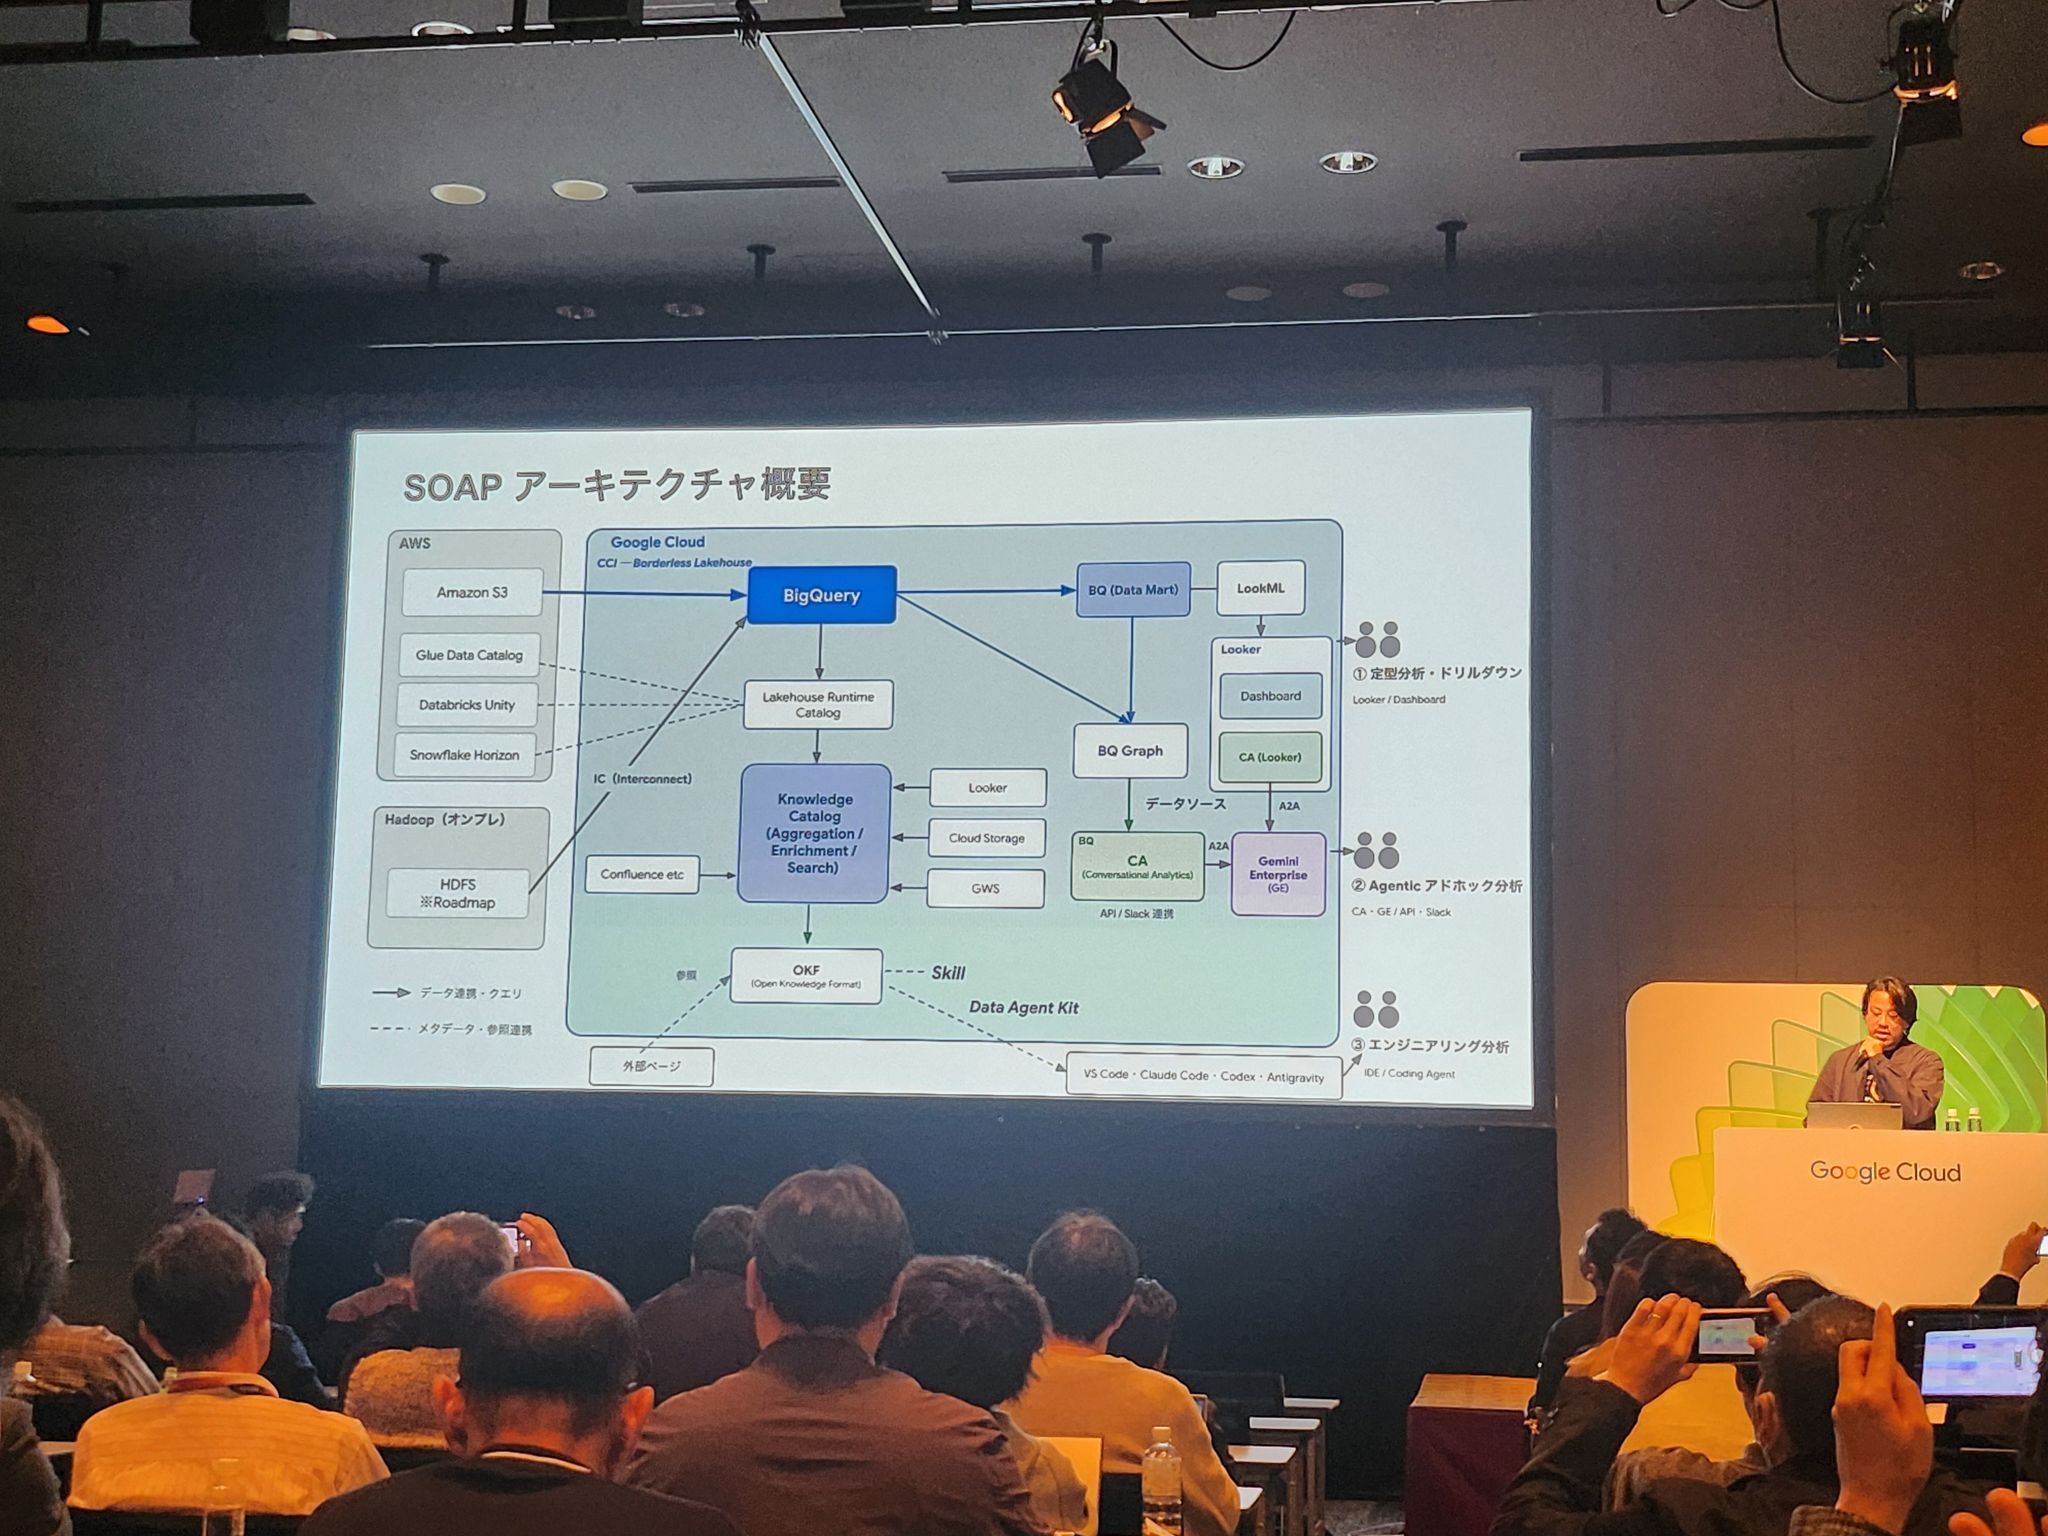
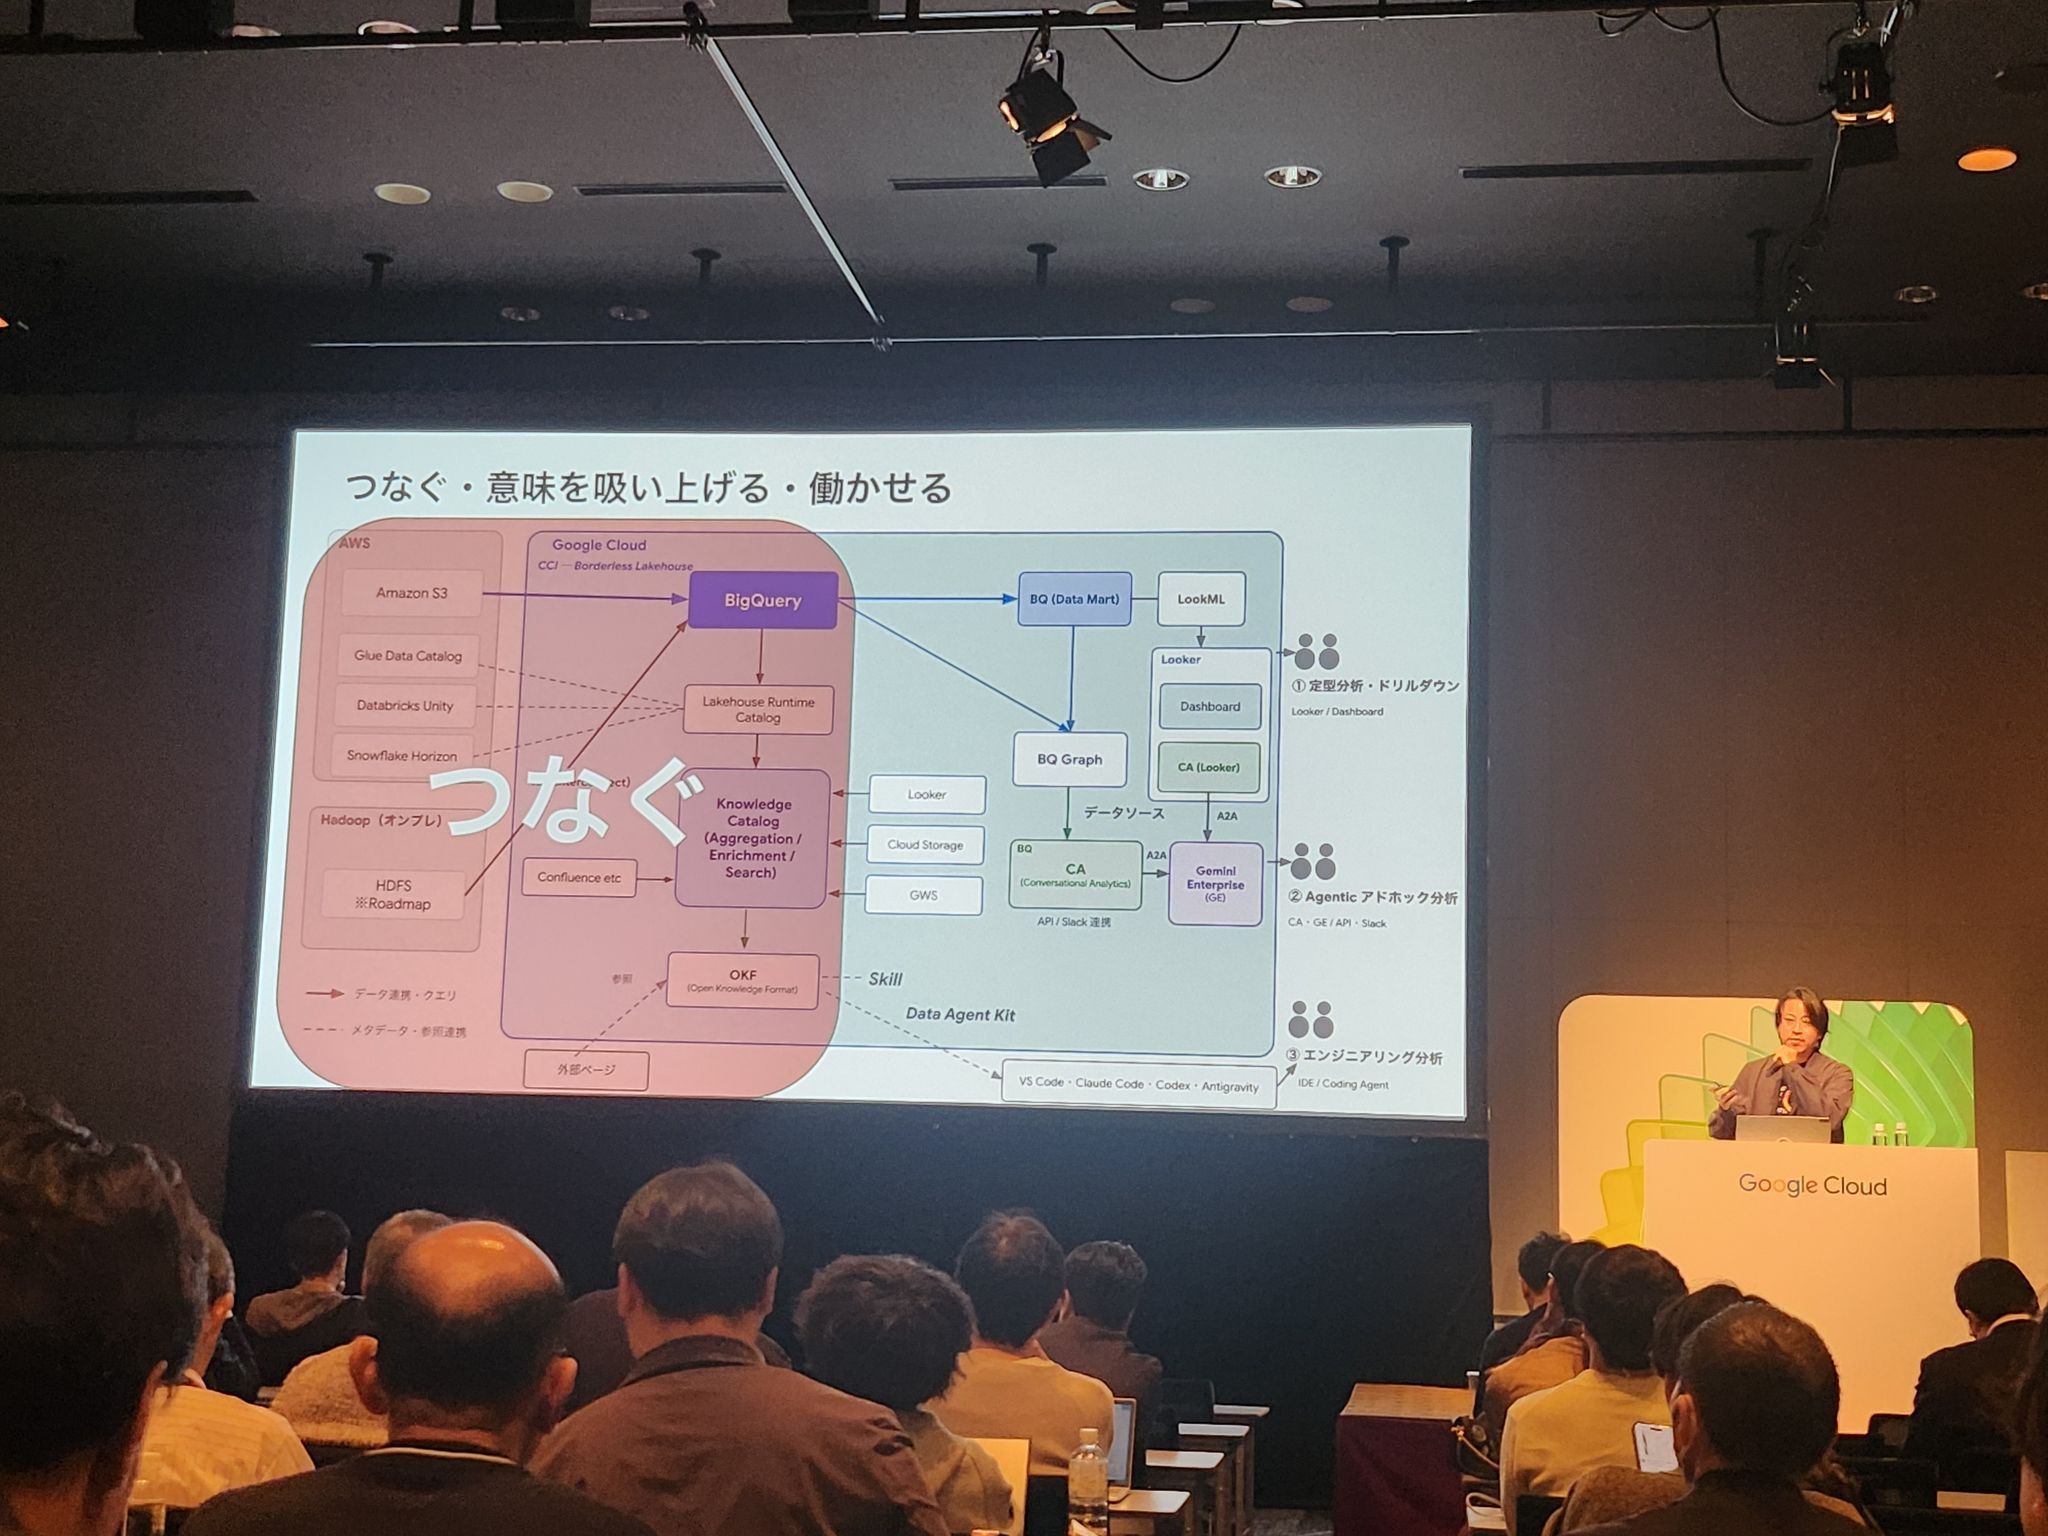
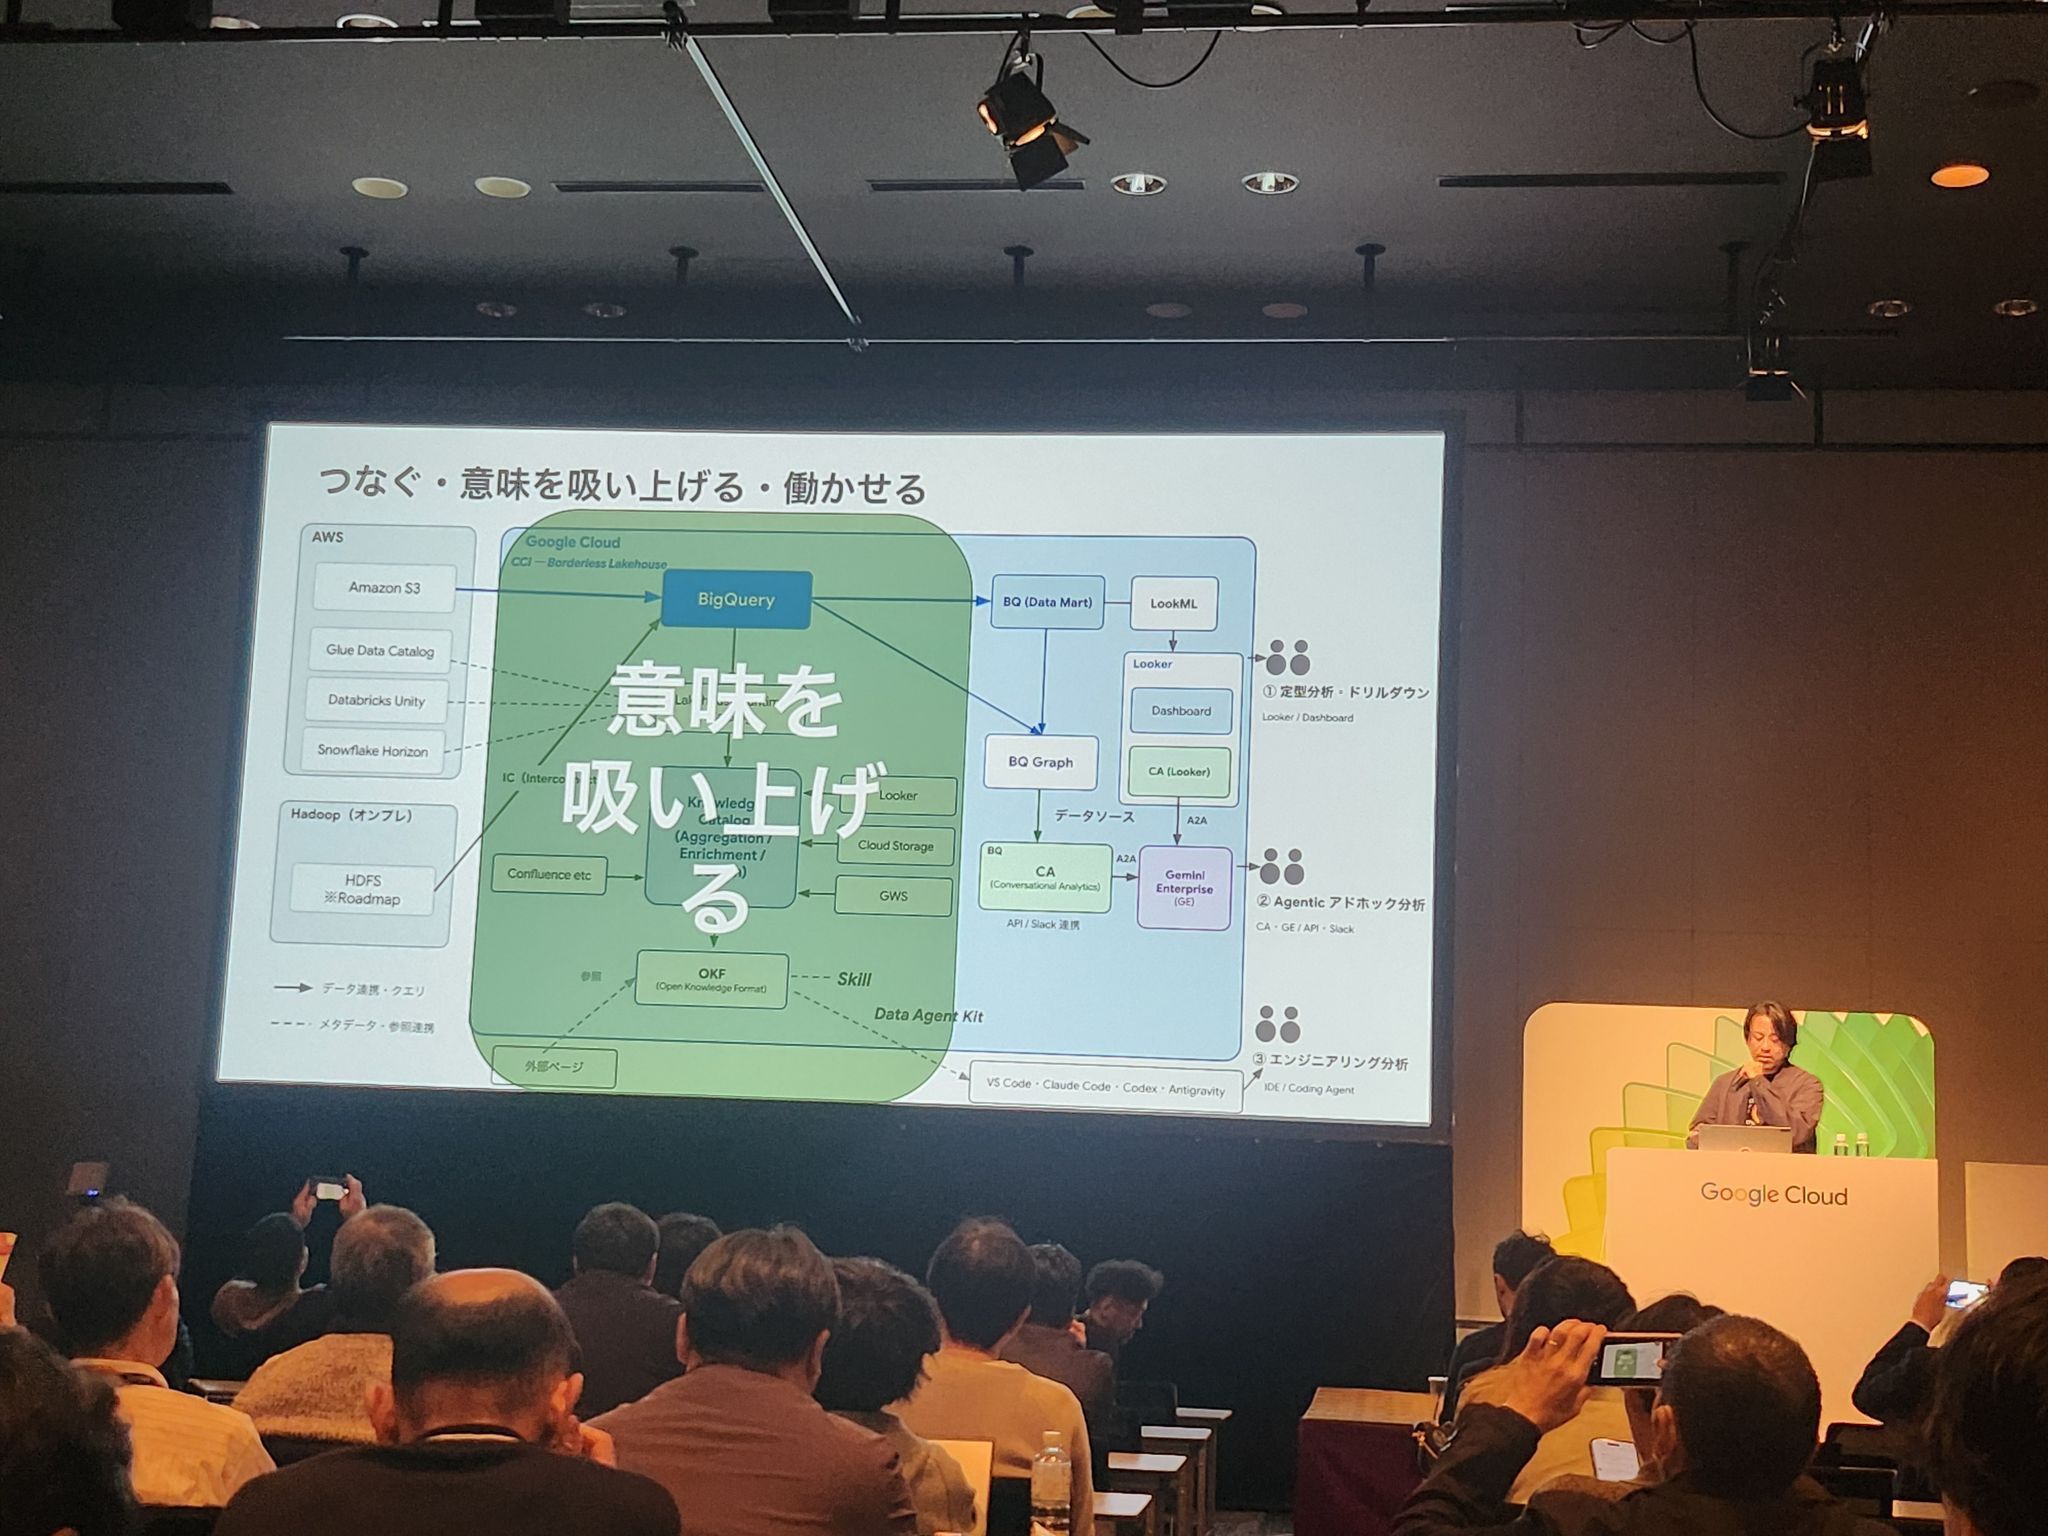
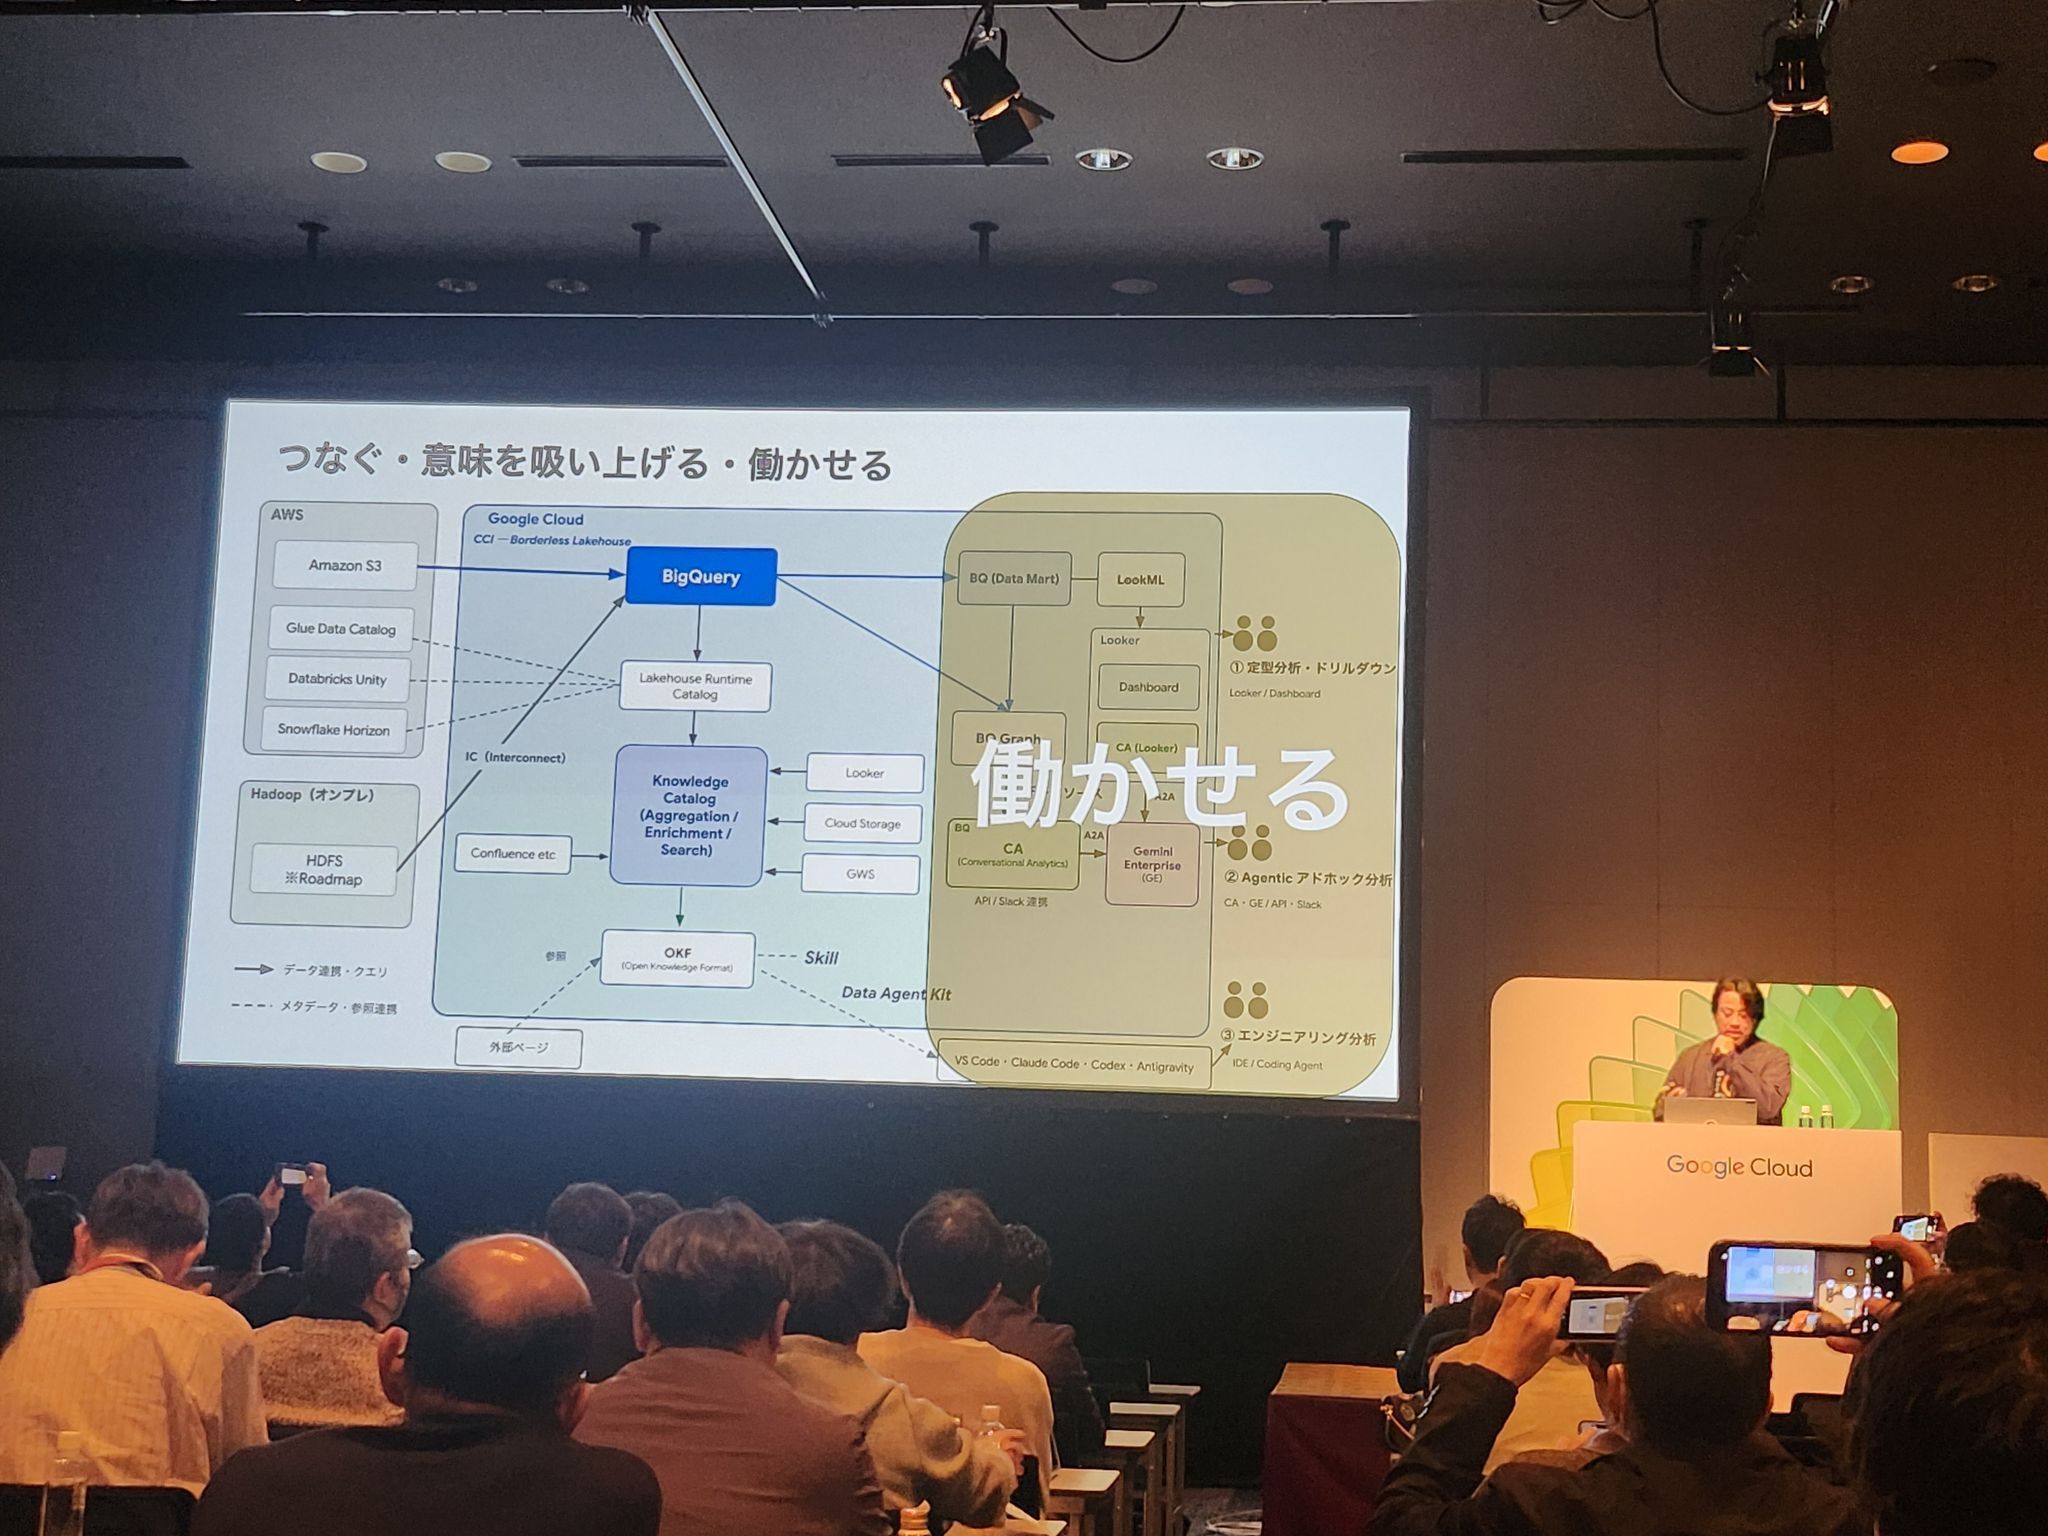
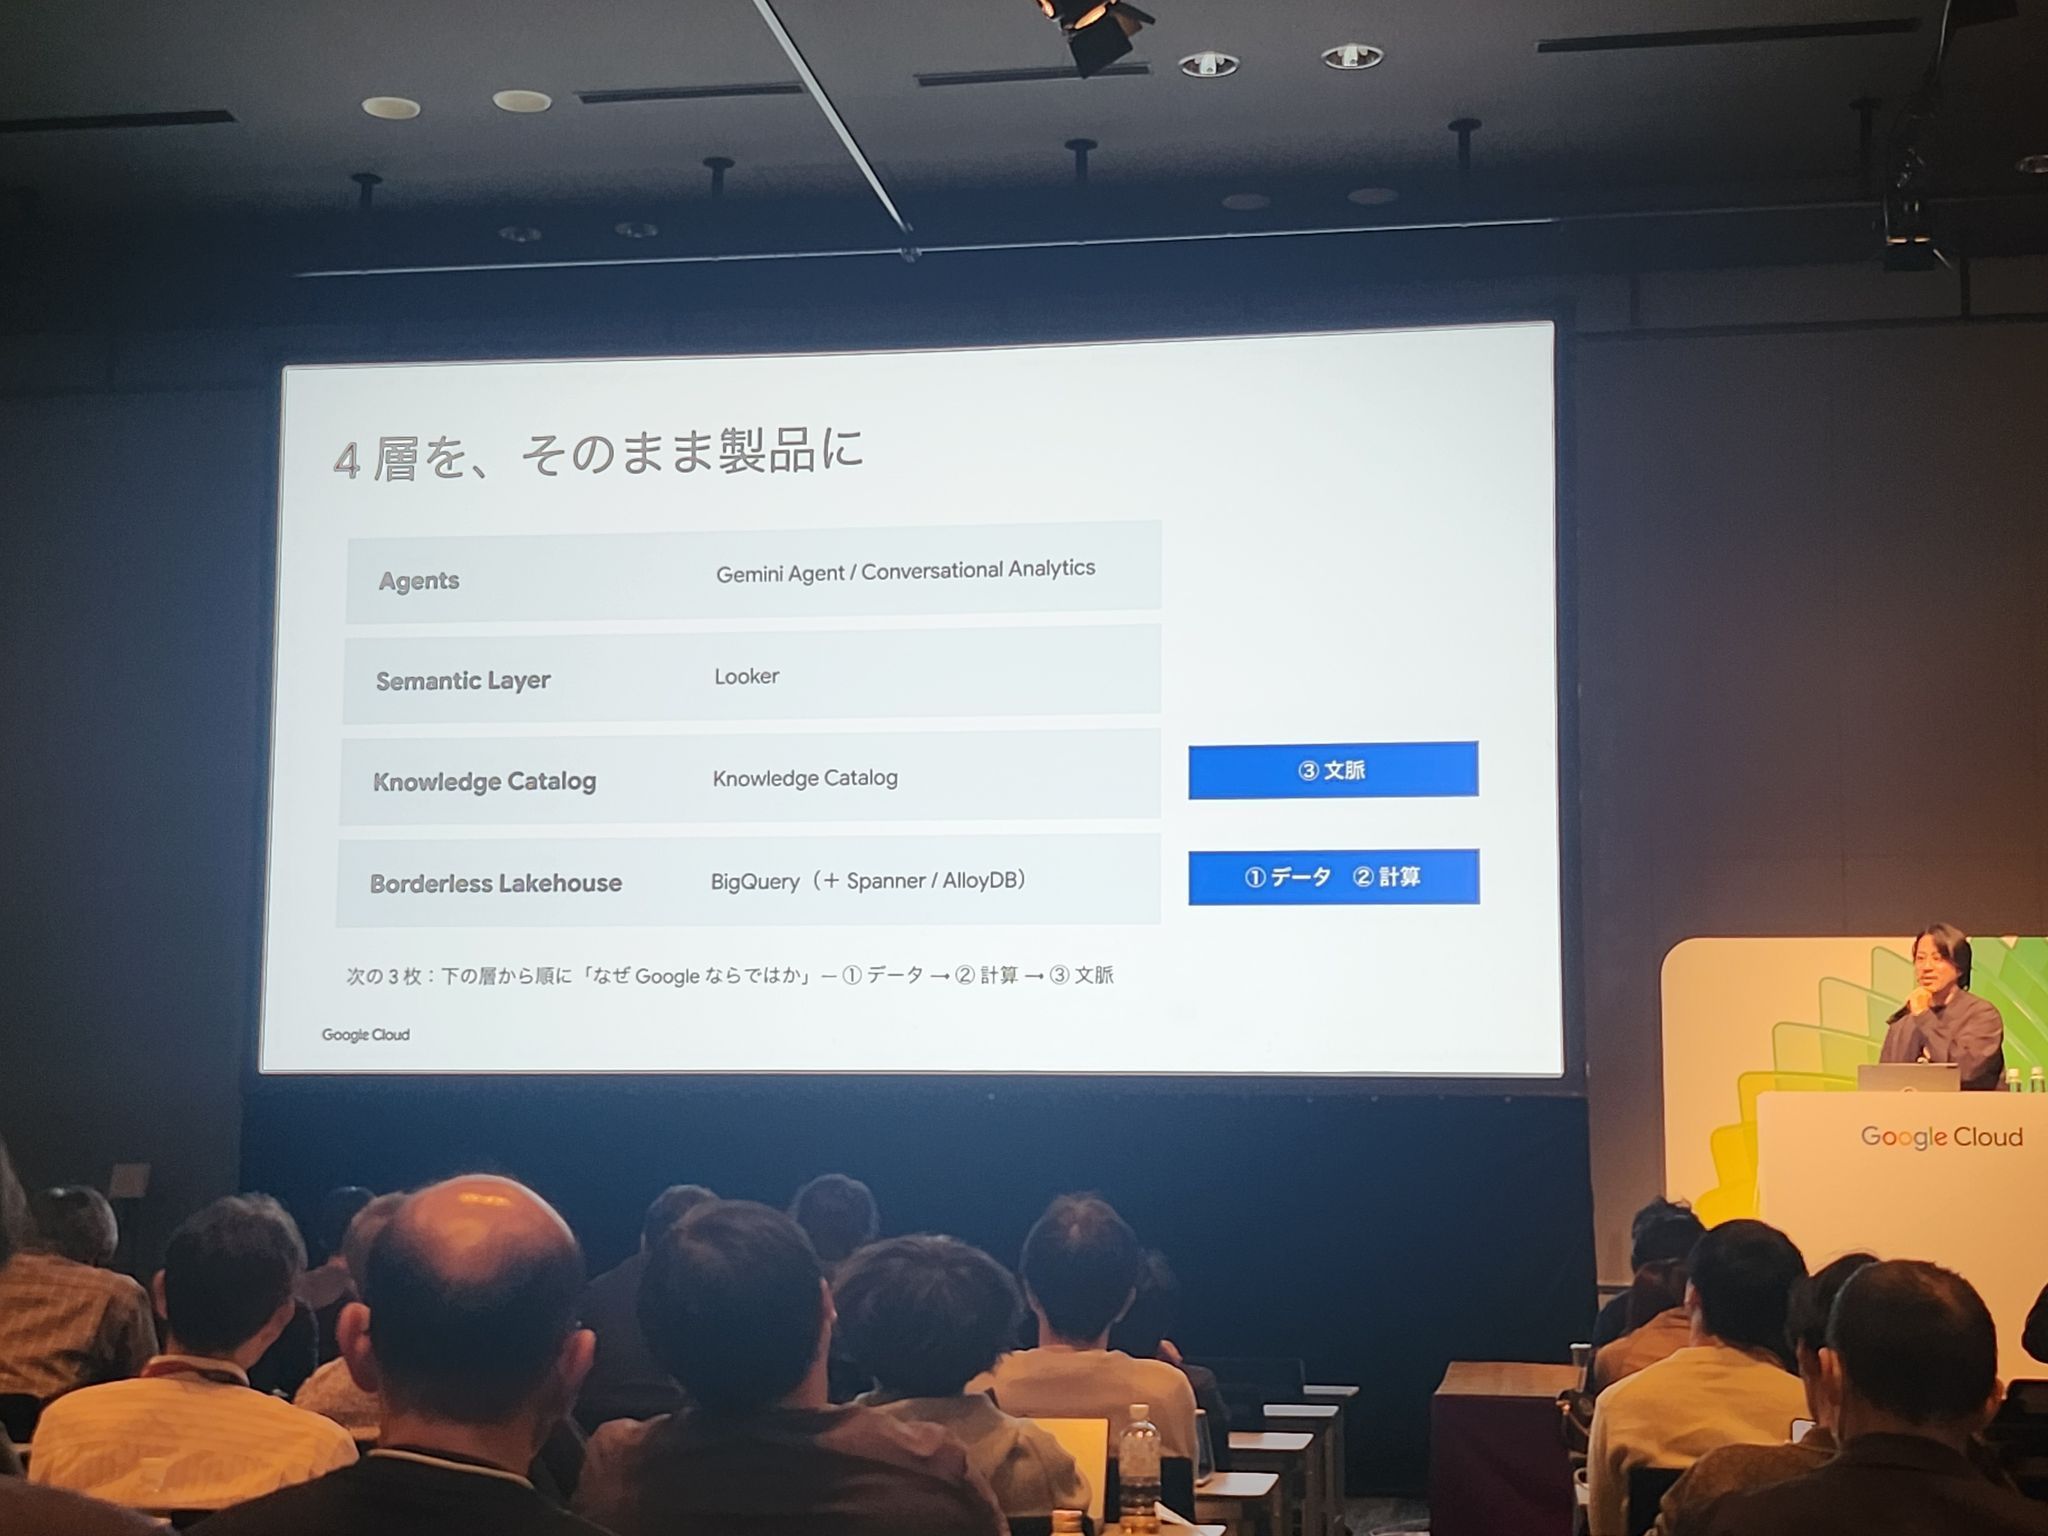
讲者给出的解法,是一套他称为「上下文架构」的分层设计。它不复杂,但每一层都在回答代理会问的一个问题:
- 数据在哪里:数据源层,包括 BigQuery 这样的数据仓库,也包括业务系统和其他云上的数据;
- 谁能用:权限与治理,哪些数据、哪些定义对哪些代理开放;
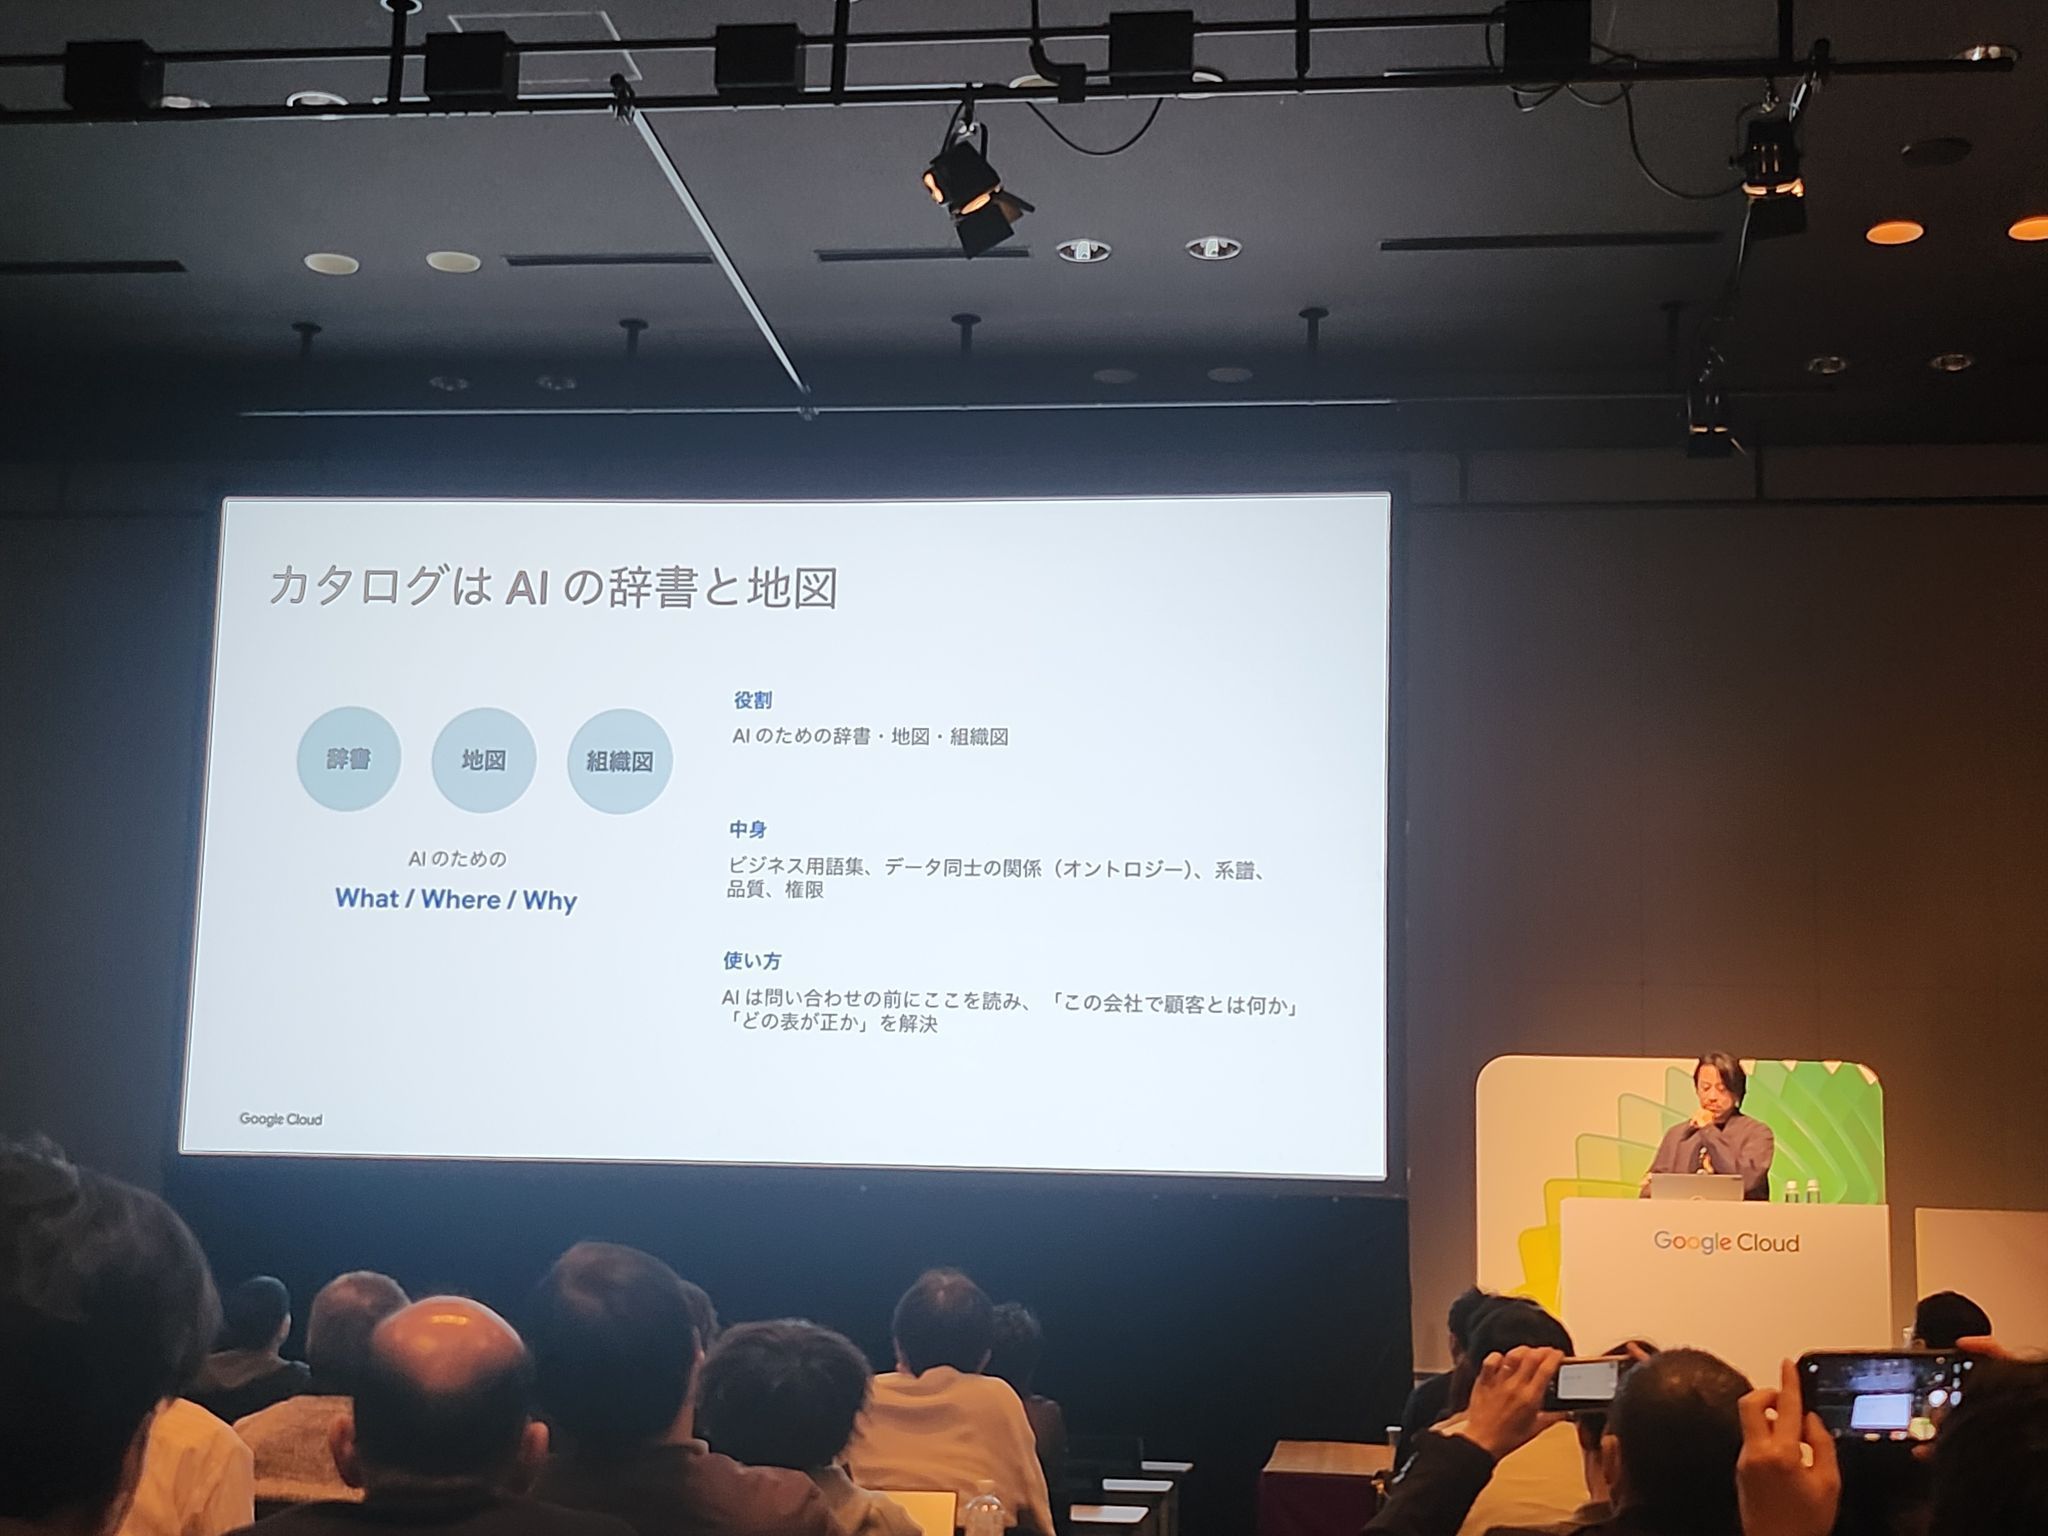
- 这是什么数据:元数据,表、字段、业务含义、负责人;
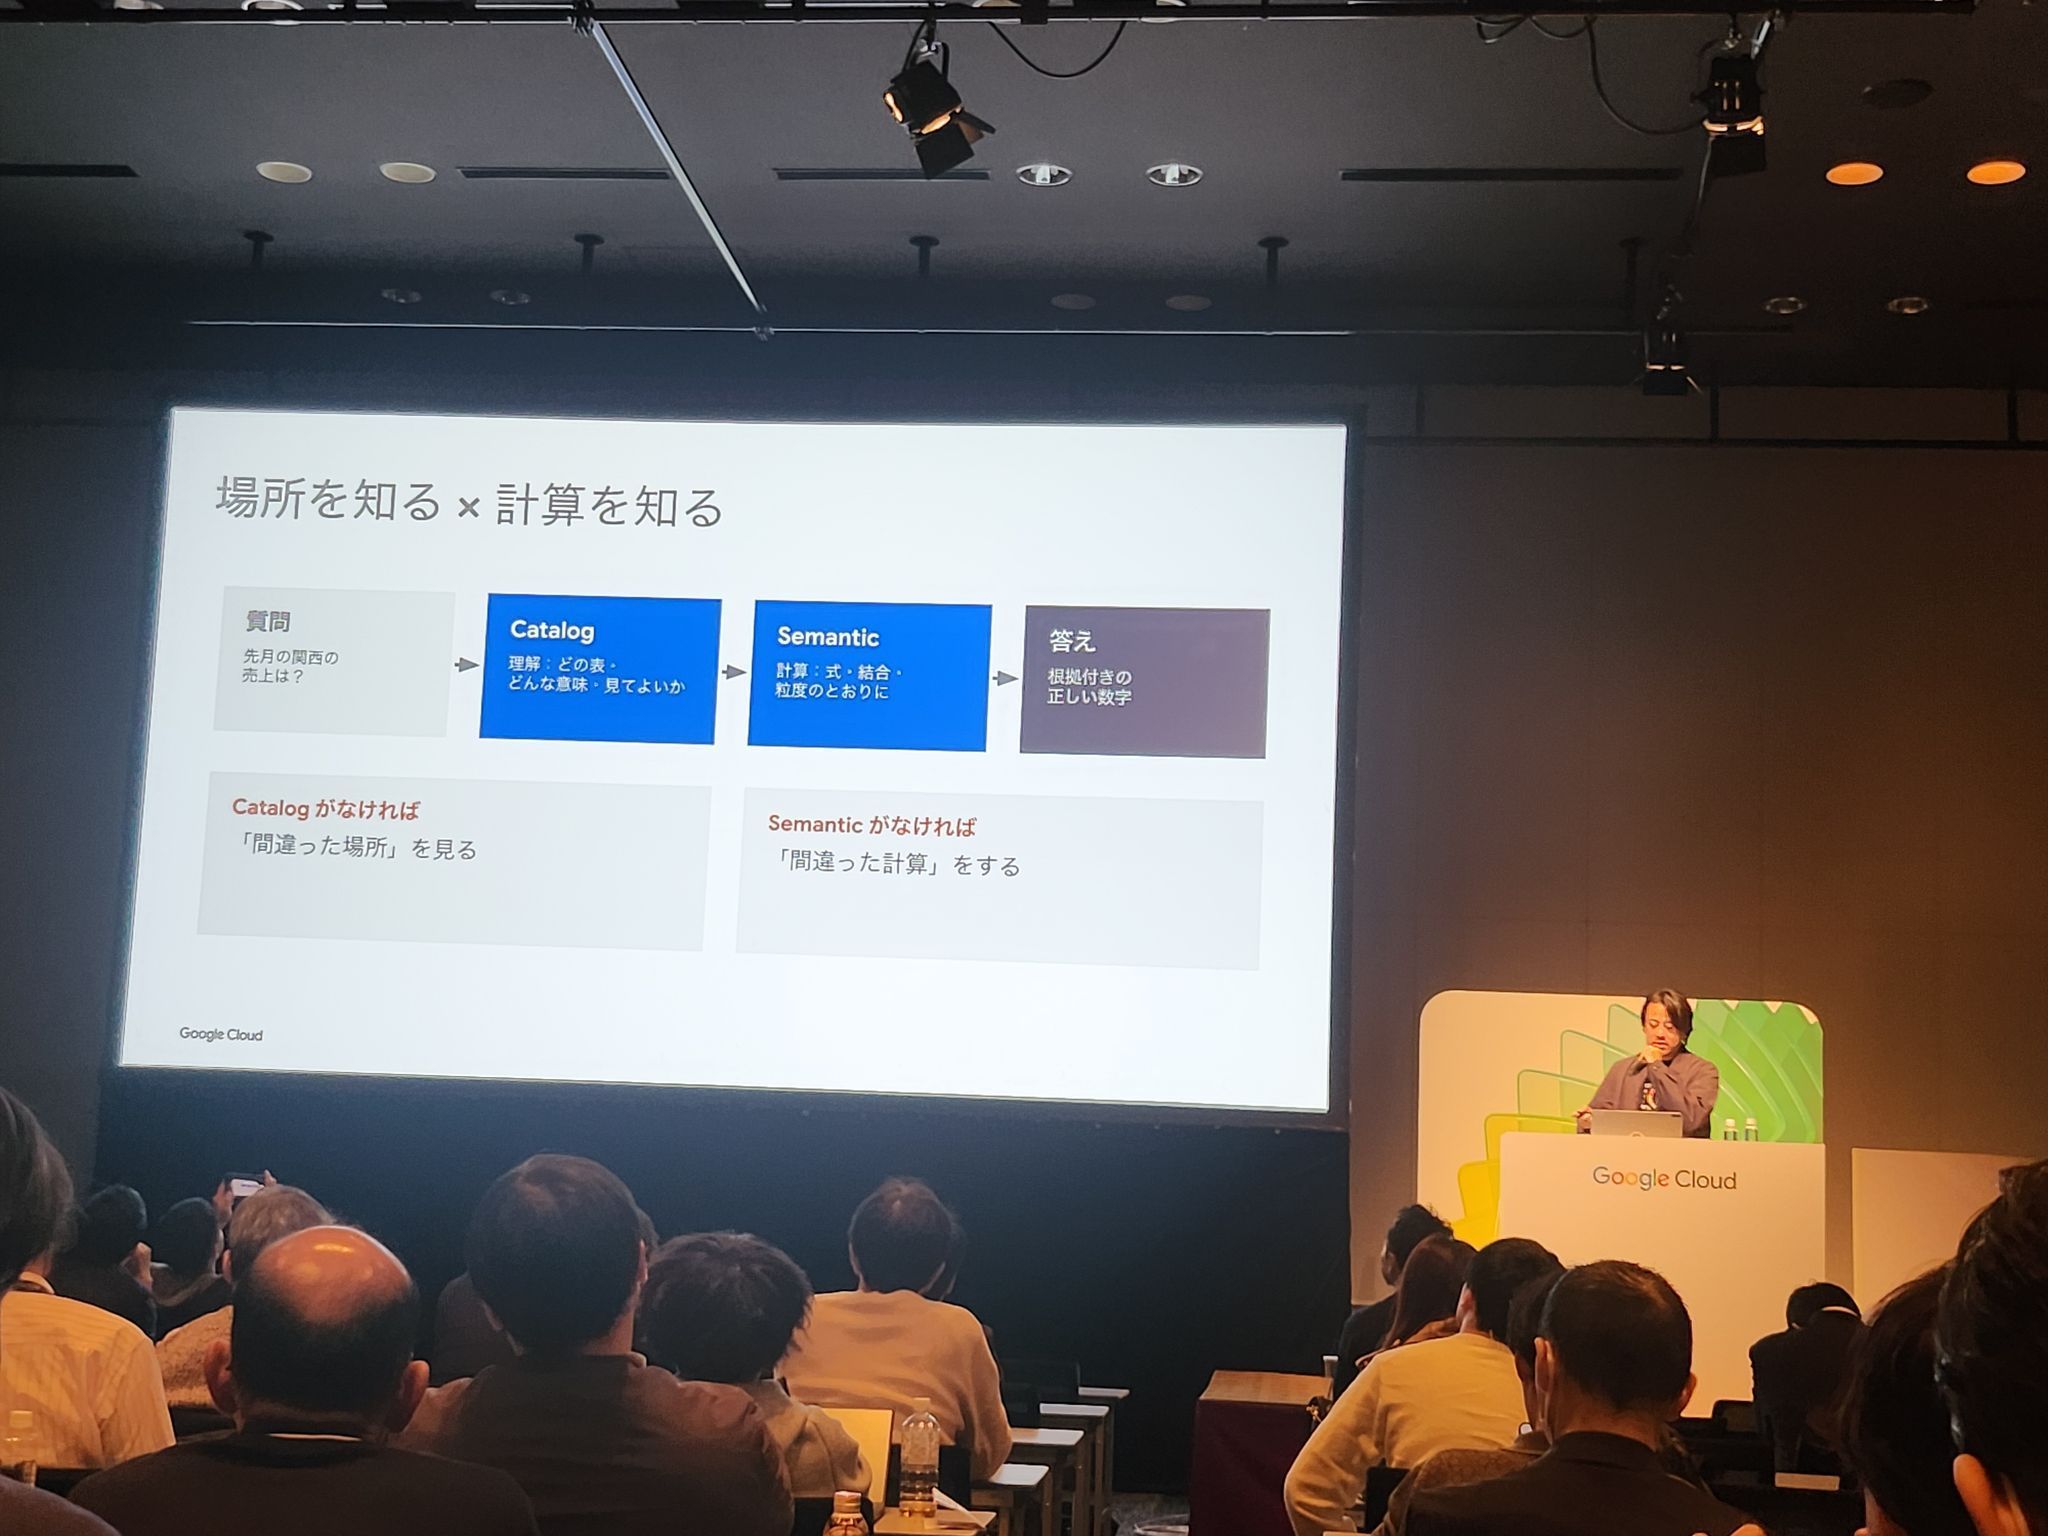
- 它意味着什么:语义层,把「销售额」「活跃用户」「关西地区」这类词和真实的字段、口径对应起来;
- 怎么算:指标与计算逻辑,把业务定义固化成可执行的表达式;
- 怎么用:最后通过代理或 API,把上面这些能力交到用户手里。
他强调,这套架构源自日本团队的实践。这个细节值得注意:企业 AI 的难点高度本地化,组织习惯、数据现状、合规要求都不一样,能复制的往往不是具体实现,而是分层思路。
三种分析,三种做法
在这套架构上,讲者把分析分成三类,分别用不同方式处理:
- 确定性的分析:口径固定、答案唯一,比如「上月关西地区的销售额」。这类问题应该走语义层和预定义的计算逻辑,结果可复现;
- 探索性的分析:问题临时、需要边看边找,比如「最近哪类客户的流失在上升」。这类交给生成式 AI 更合适,由人带着它一起看;
- 代理式的工作:目标明确但步骤不固定,比如「帮我做一份大阪的营销活动方案并验证效果」。代理自己规划、调用工具、产出结果。
这里最关键的是第一类。讲者用「订单—支付」举例:一笔订单可能对应多次支付、退款、调整,销售额只能在明确的规则下算一次。如果每次都让模型自由发挥,同一个问题就会得到不同的数。
他们的做法是:代理先去查术语词典,确认「销售额」指什么;再由语义层给出计算式;最后生成确定性的 SQL。这样既有自然语言的灵活性,又有传统数据体系的可靠性。讲者把这称为「确定性」的做法——不是让模型猜,而是让模型去调用已经定义好的逻辑。
一场对比实验:加了上下文,差多少
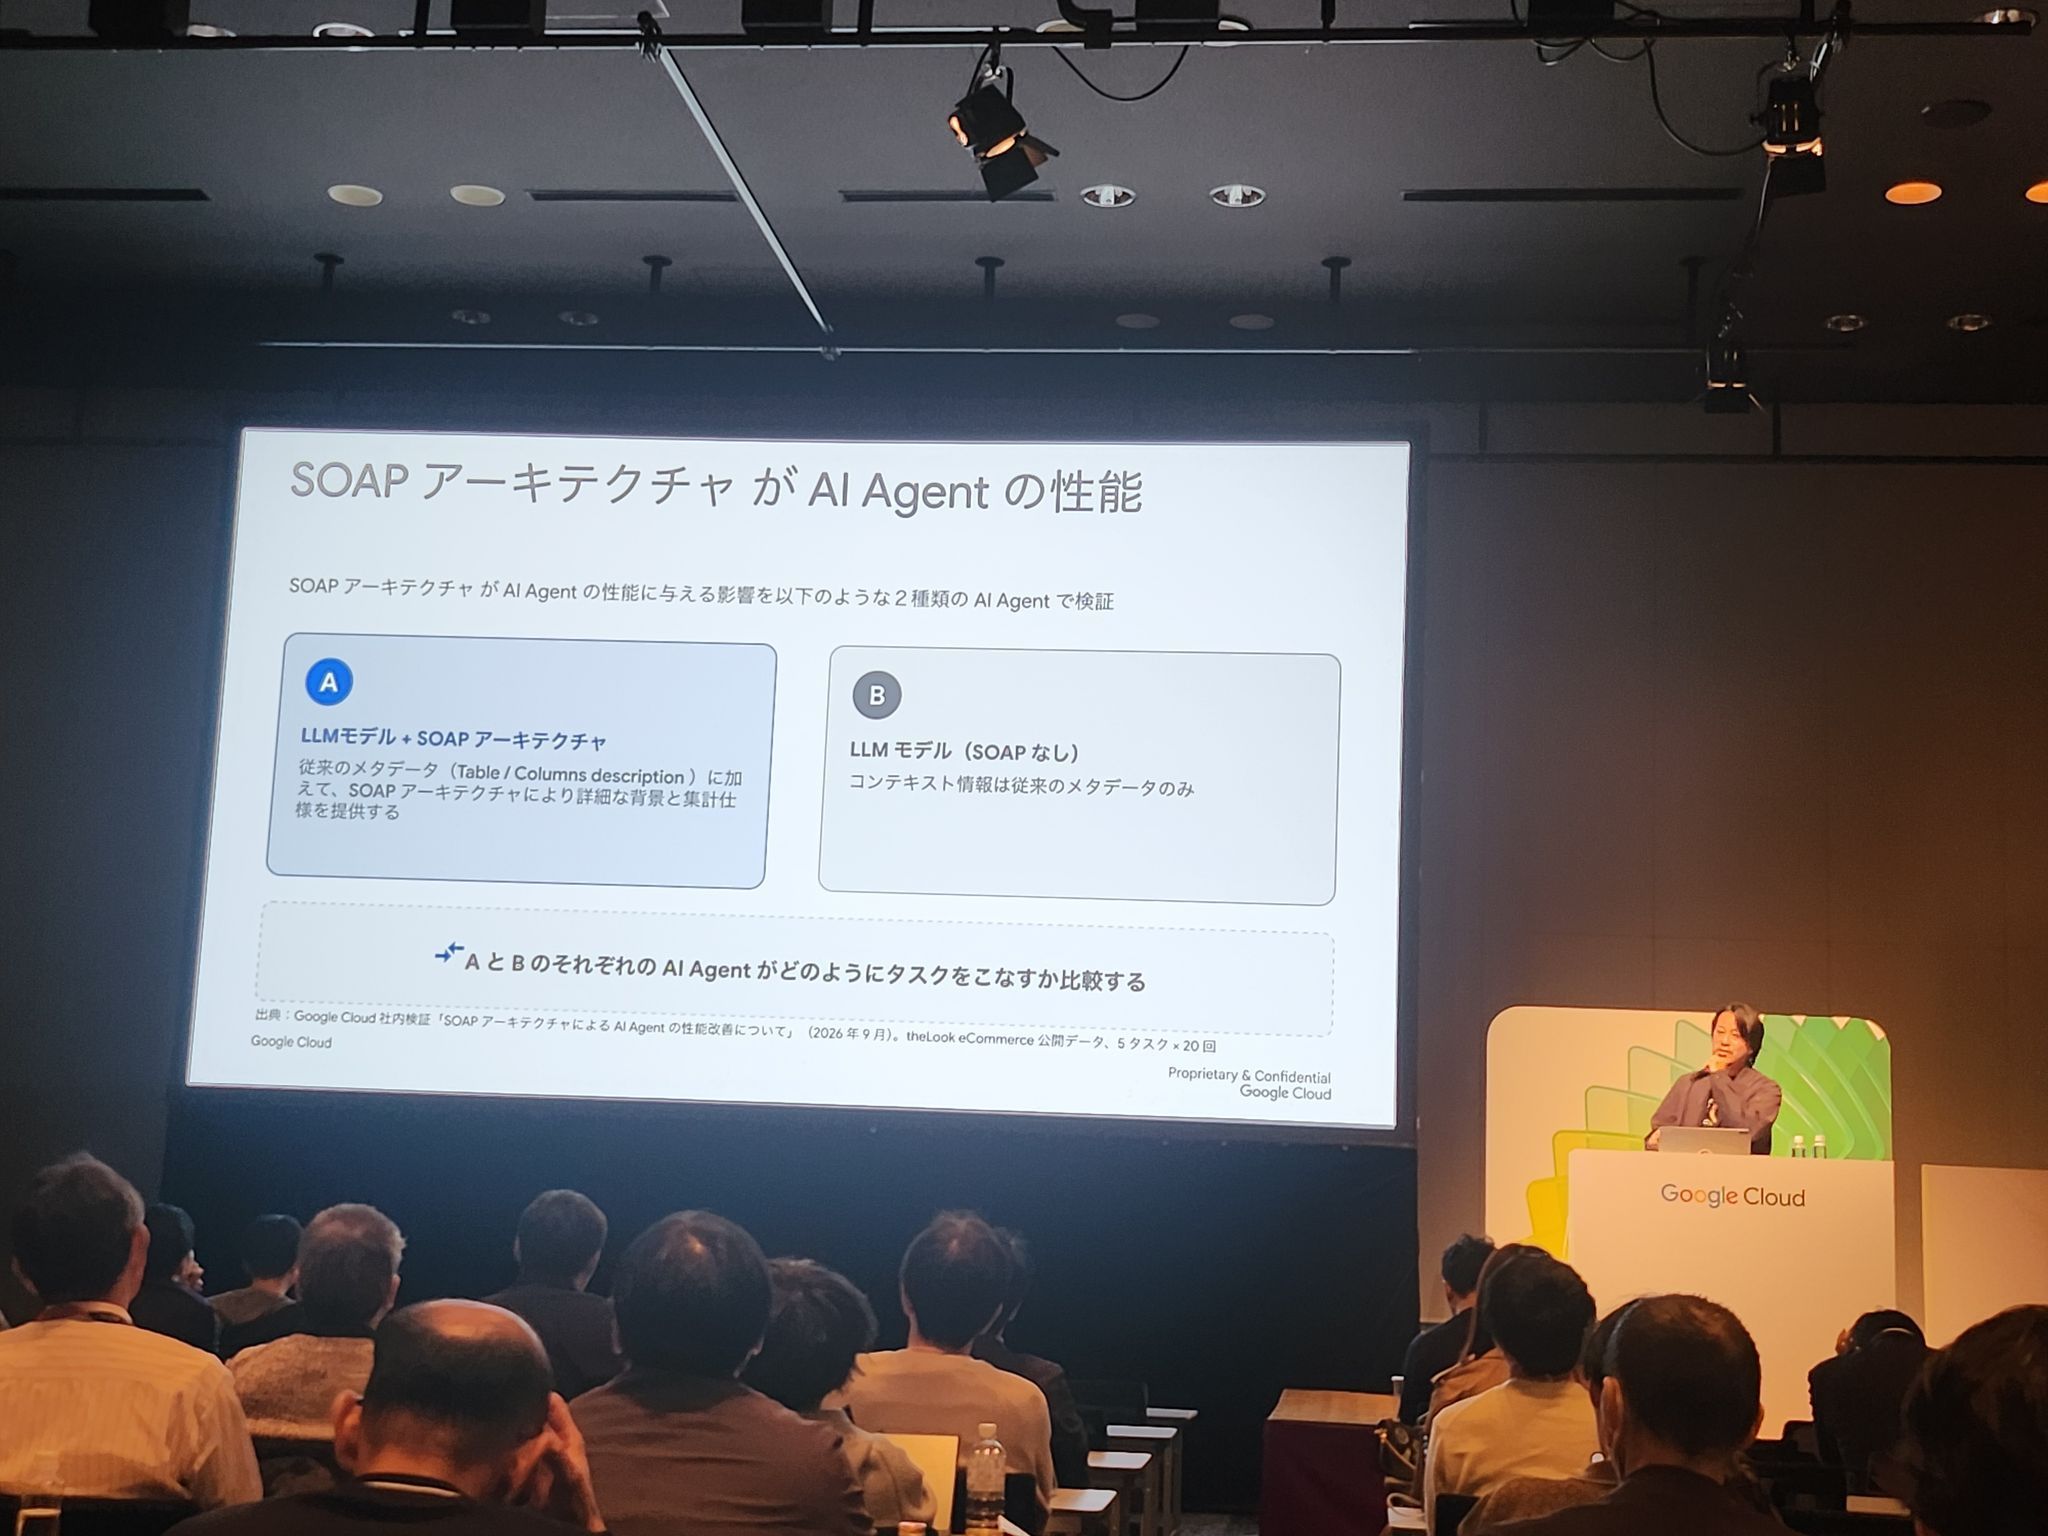
为了验证这套架构,讲者在公司内部做了一组对比实验。
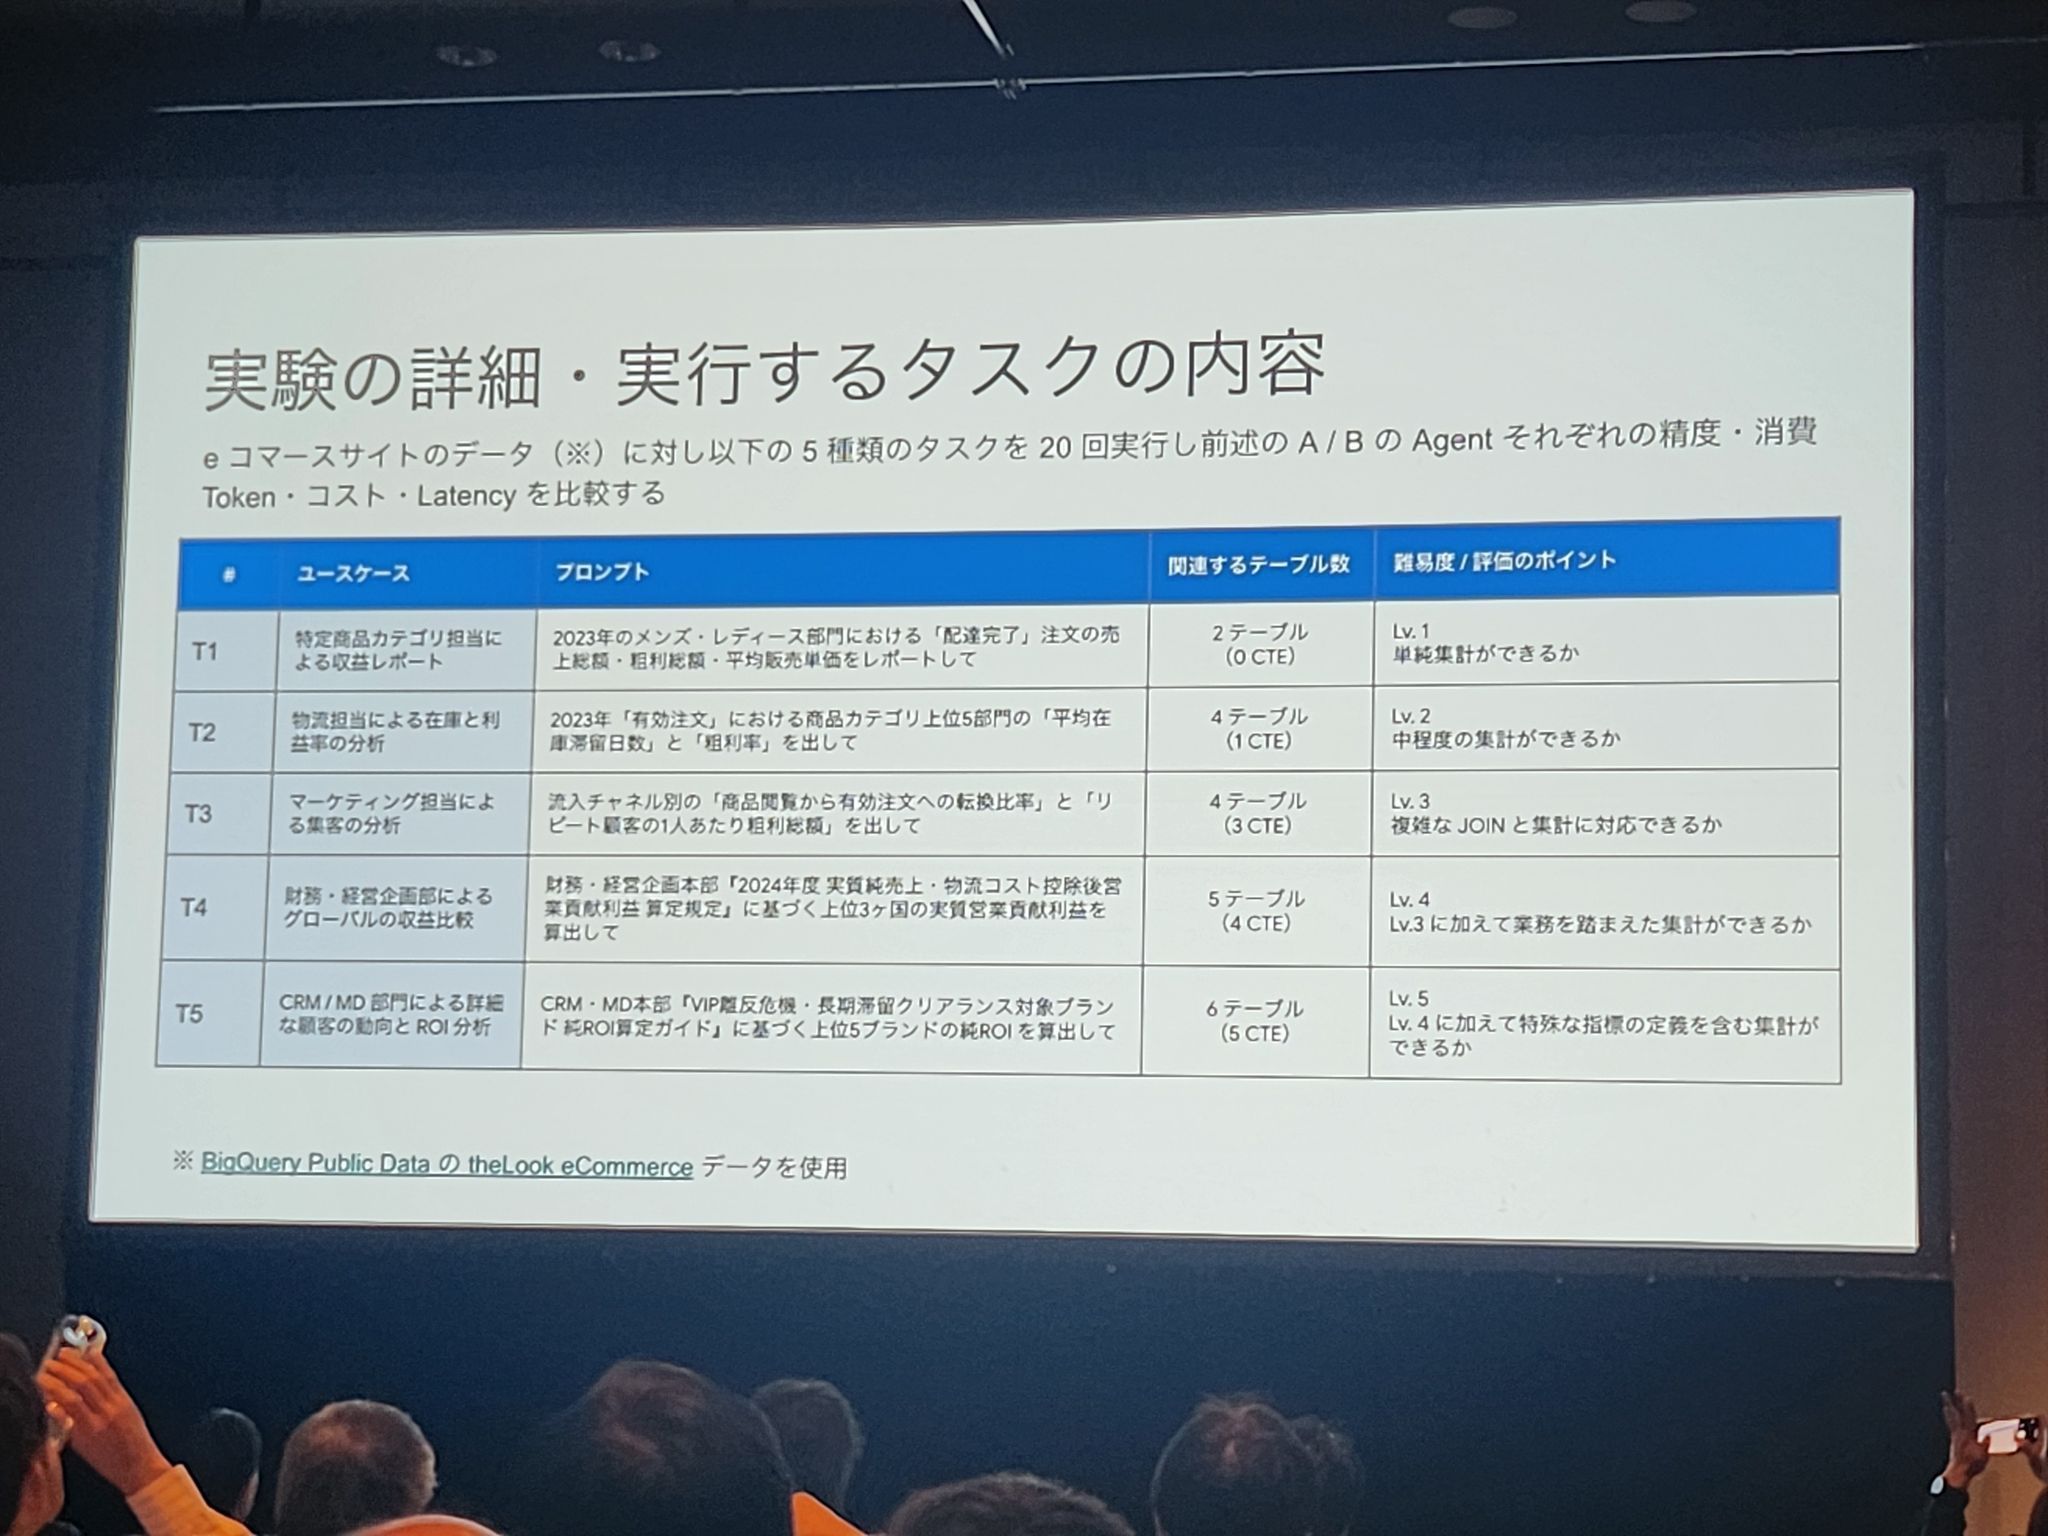
实验用了五类问题,每类跑 20 次,覆盖从简单到复杂的场景,包括带时间条件、需要识别主体、以及「审计调整后的销售额」这类条件较多的问题。一边是不带上下文的基线,另一边是接入上下文架构的代理。
结果分几个维度看:
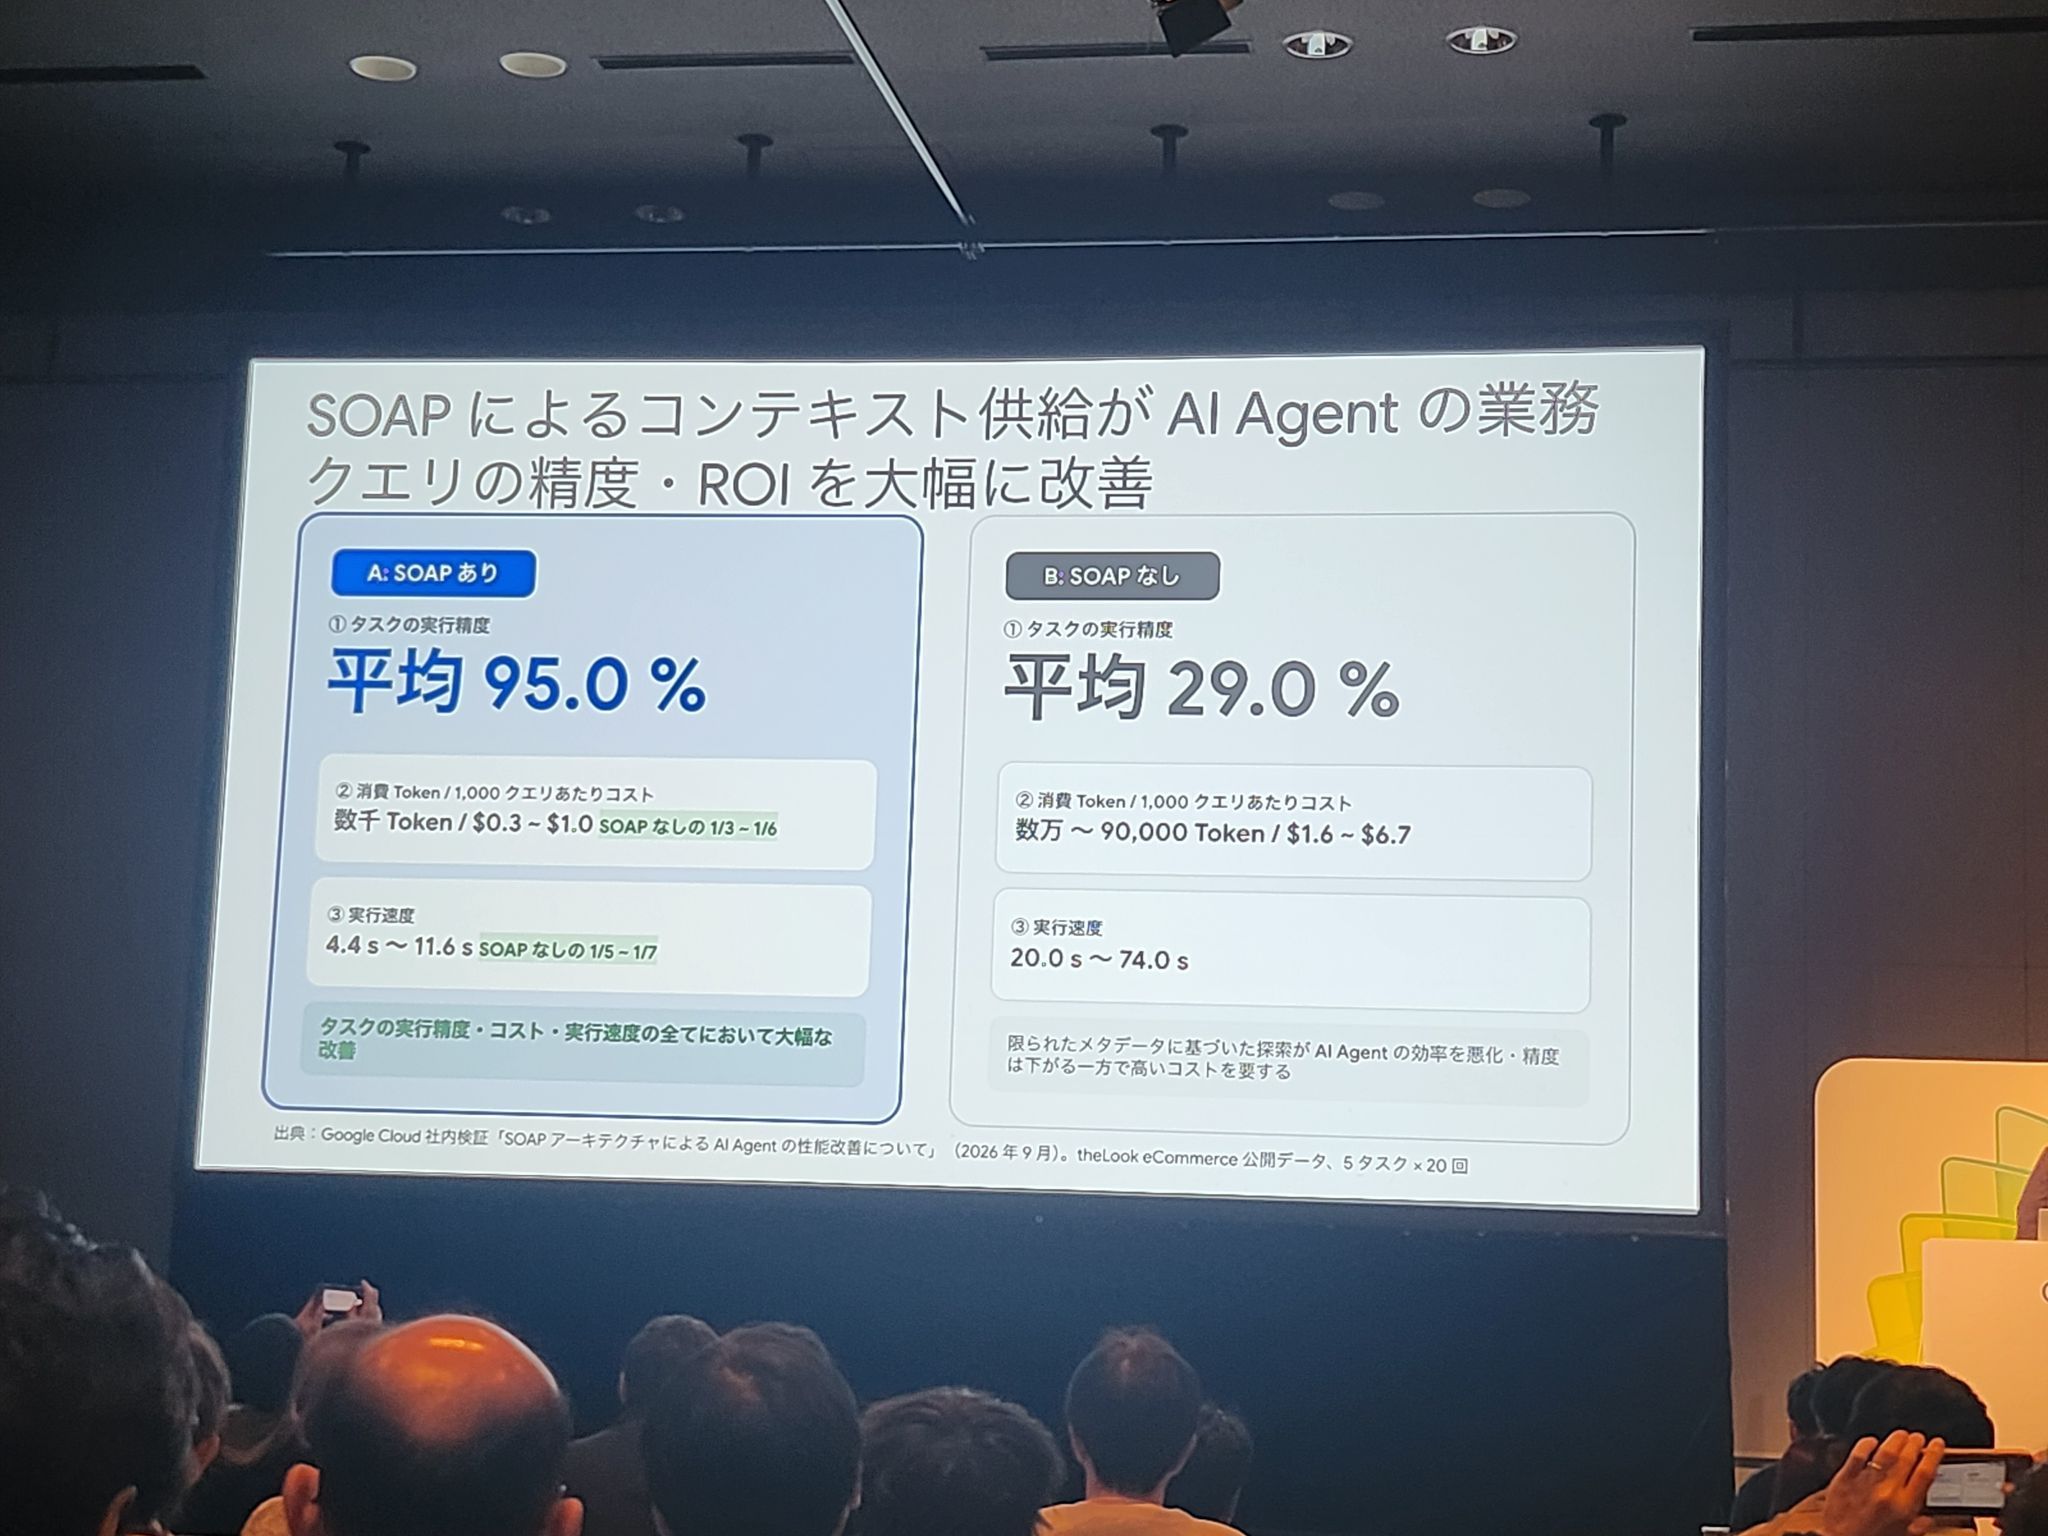
- 准确率:带上下文的一侧明显更好,尤其在条件复杂、需要正确理解业务口径的问题上;
- 执行步骤:基线往往要反复试表、试字段,绕很多弯路;带上下文的一侧路径更短;
- 成本:token 消耗和执行次数都下降。
讲者也提到一个限制:他们用较轻量的模型也做了验证,加上下文后确实有改善,但复杂问题仍然需要更强的模型,成本也更高。换句话说,上下文不是「用小模型替代大模型」的魔法,它更像是把问题的难度降下来,让模型把力气花在真正需要推理的地方。
这一点很重要,它避免了「有了上下文就不需要好模型」的误读。
托管能力:把「上下文」变成可运营的东西
架构讲清楚之后,落地的另一面是运维。讲者介绍了 Google Cloud 在数据层的几个能力:
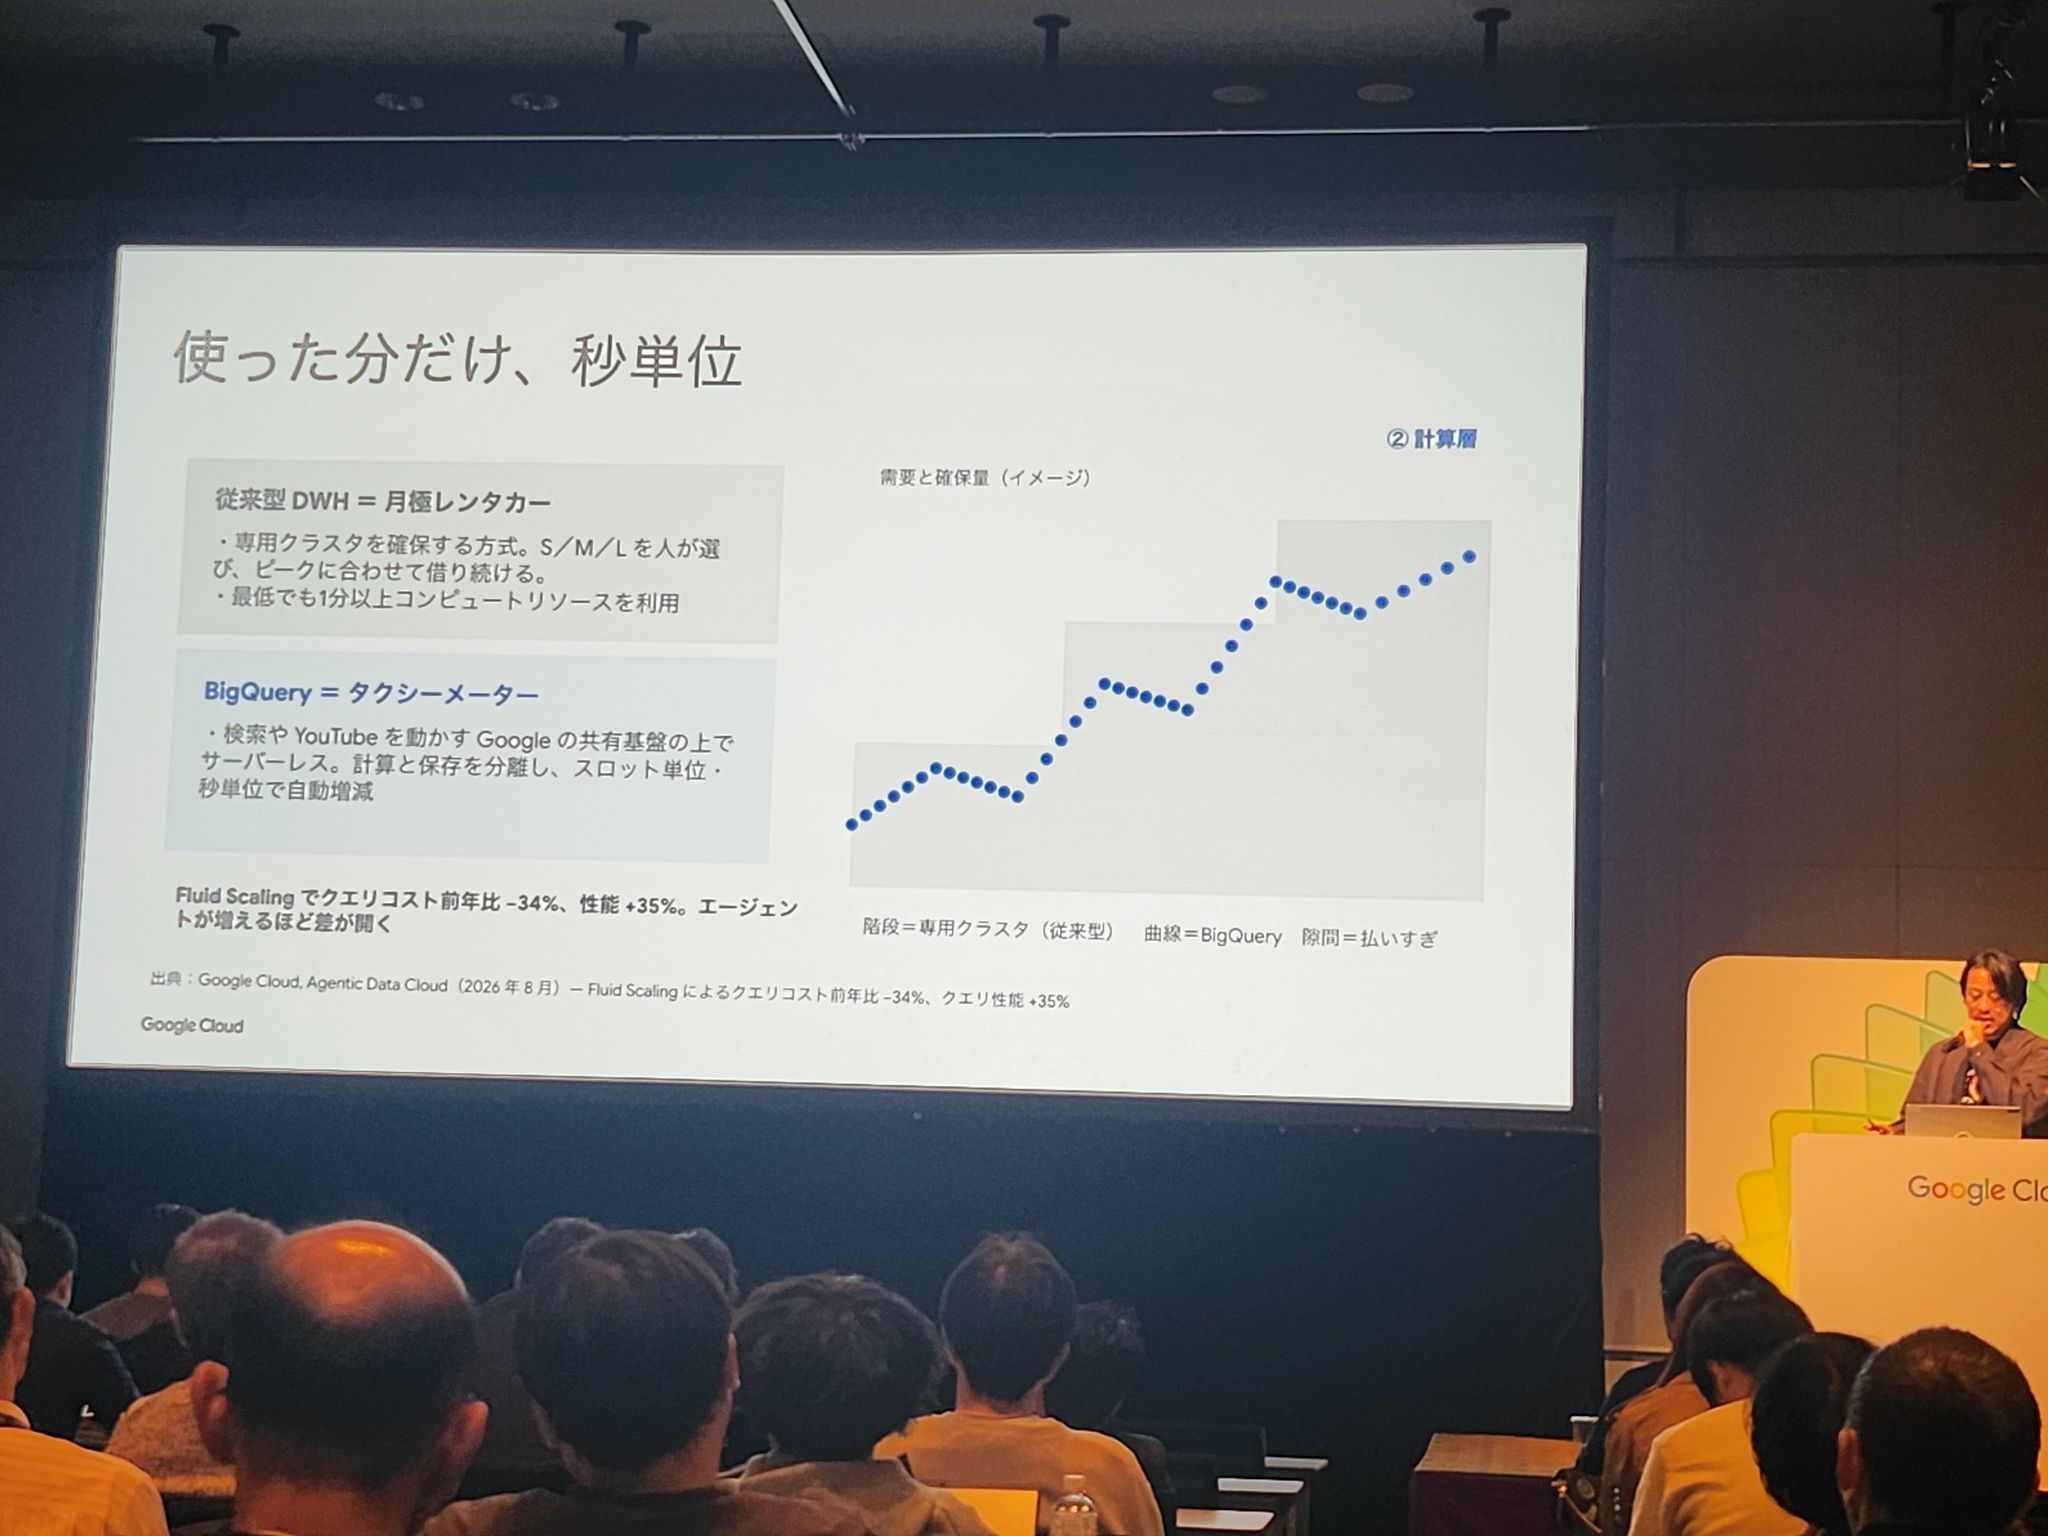
- Serverless 的数仓:BigQuery 不需要预先规划集群,起步快,计算资源可以按需伸缩;
- 零拷贝接入:如果业务数据在别的云或业务系统里,可以通过联邦查询、零拷贝的方式直接分析,不必先搬一份数据,也不必等夜间批处理。订单、库存、金融交易等实时状态,可以直接拿来用;
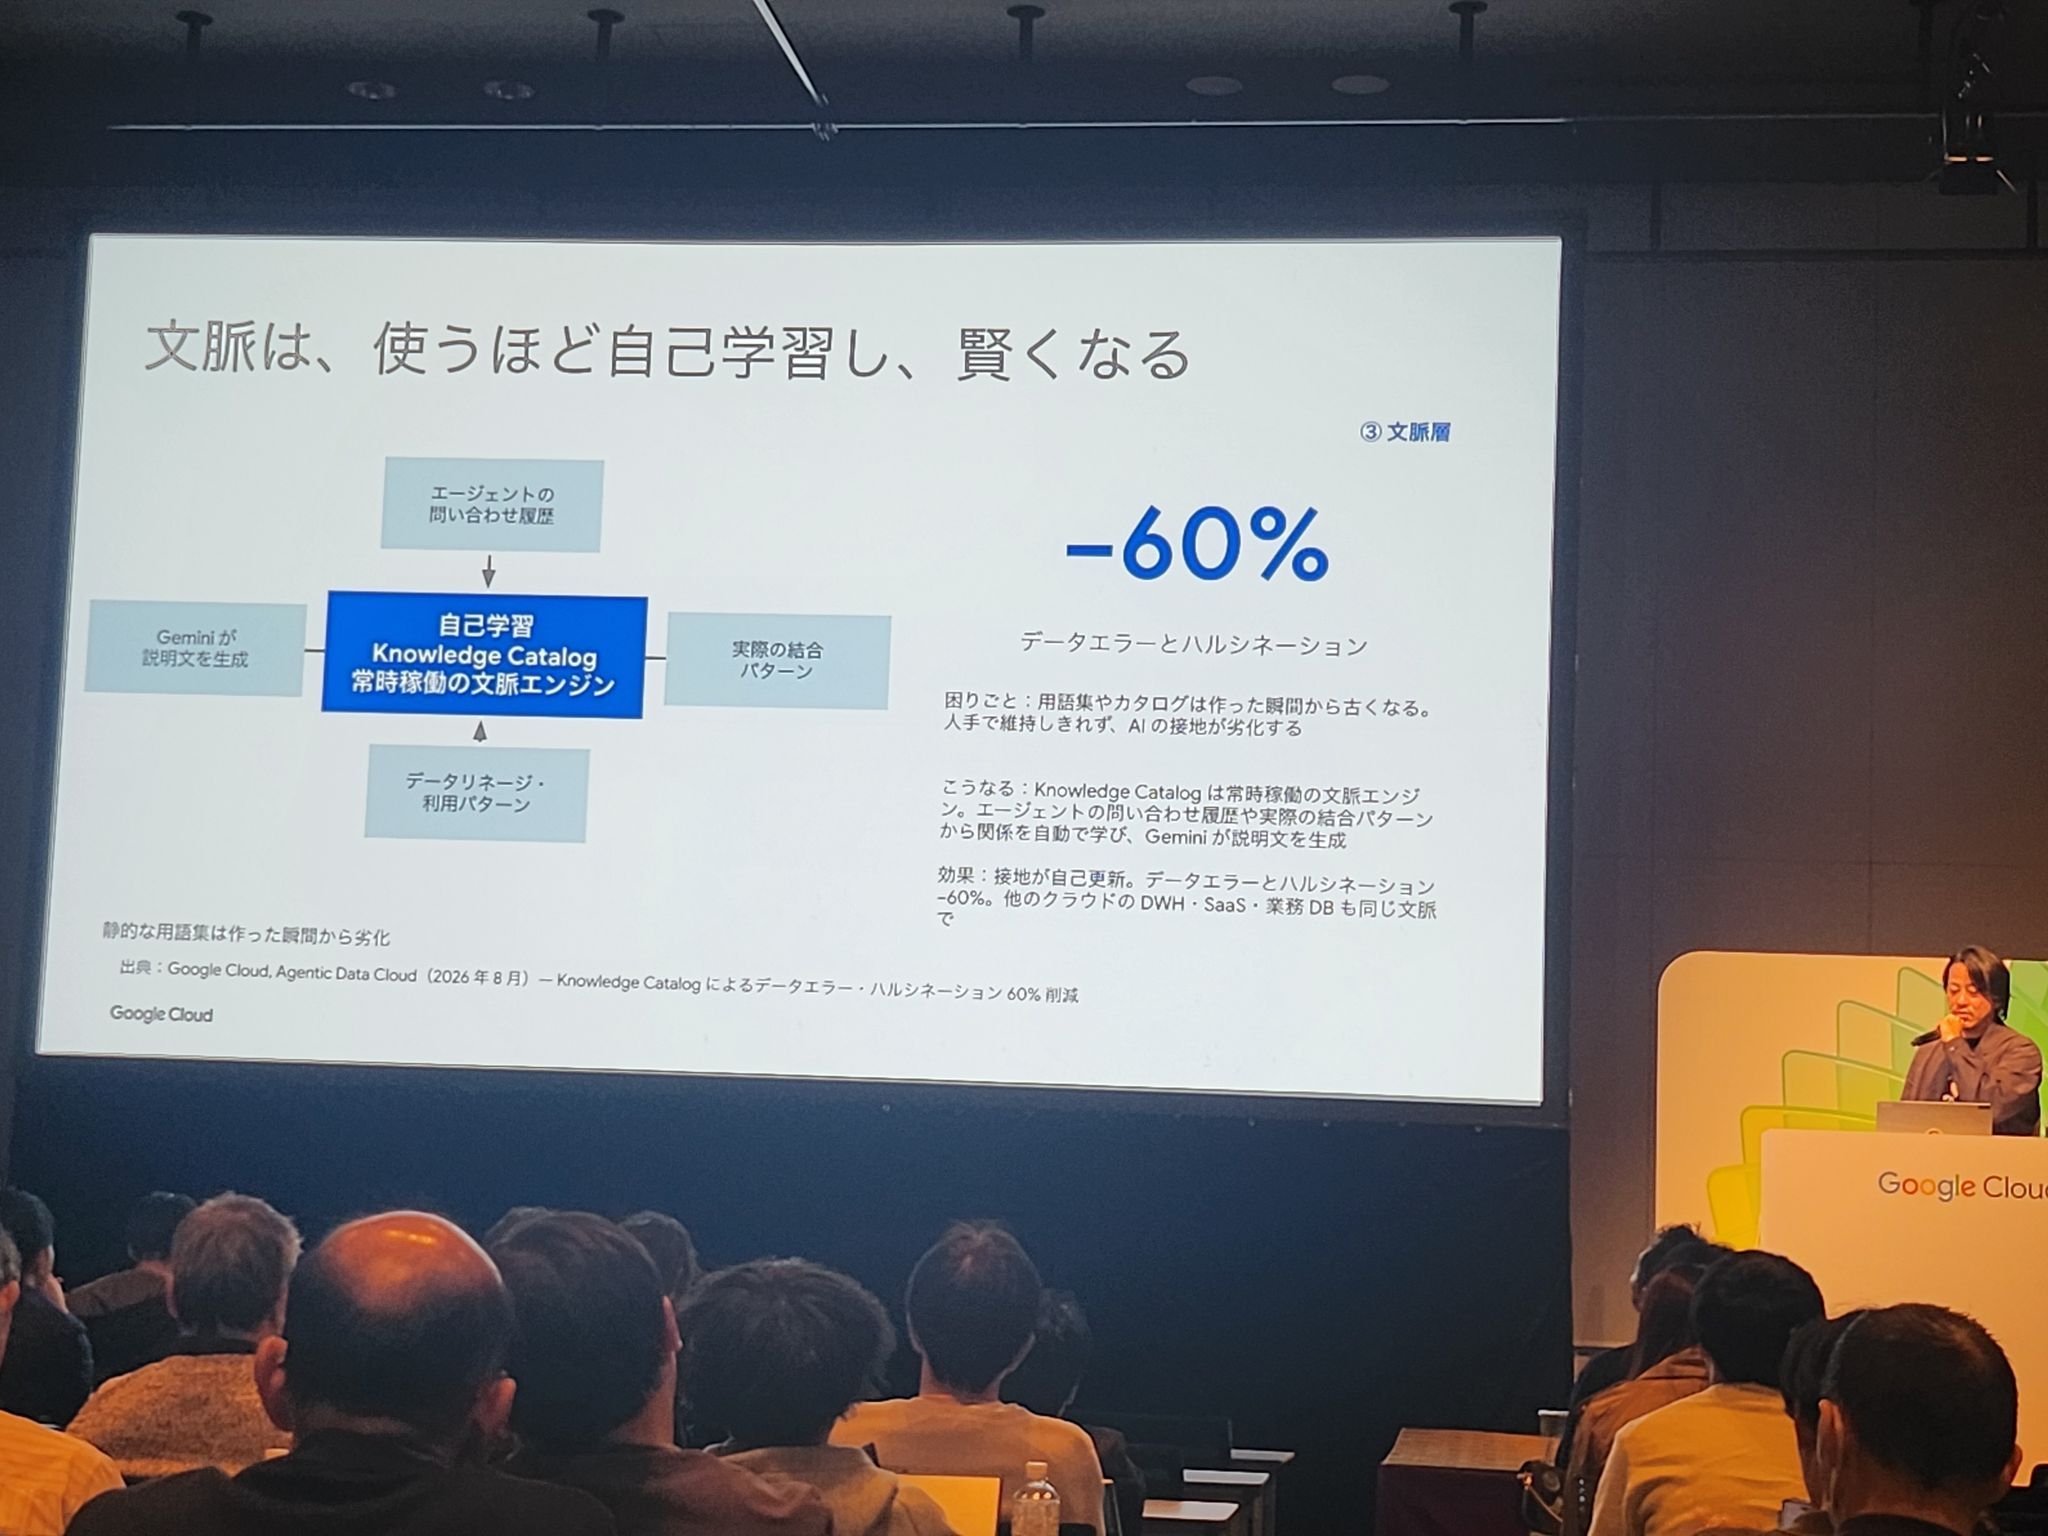
- 元数据与血缘:表、字段、上下游关系、数据质量、权限,都能被记录和查询,代理在回答时可以带上依据;
- 持续学习:代理每次查询、每次修正,都会反过来丰富语义层和元数据,让下一次更准。
最后一点是讲者特别强调的:上下文层不是「建好就结束」的项目,而是需要持续维护的资产。业务定义会变,表会变,代理的错误也会暴露定义的漏洞。系统要能从这些使用痕迹里学习,而不是靠人一遍遍手写文档。
Demo:一家虚构银行的「房贷置换」
讲者用一家虚构的「樱花银行」做了演示。场景是住房贷款的置换(refinance):客户想比较不同方案,但提问很模糊——「我这种情况,哪个页面能帮我算一下?」
代理接到问题后,先根据已有的定义和附加信息判断客户的情况,再去找相应的数据,完成分析,最后把汇总结果以仪表盘的形式呈现。演示里还有一个细节:部分客户数据放在其他云的数据库里,通过零拷贝的方式访问,不需要先同步到 BigQuery。
结果不是终点。讲者强调,数据科学家可以继续查看代理的分析过程,检查口径、修正错误;代理产生的结论和修正,会作为知识沉淀下来,而不是留在某个人的聊天记录里。这样一来,数据资产不会因为人员流动而「属人化」,新来的人也能看到「这个数是怎么来的」。
演示的后半段换成营销场景:在大阪做一场活动,需要找目标客户、做受众分层、按都道府县和市区町村看分布、生成素材,最后用 BI 工具做效果验证。代理把这些串起来,产出的不只是「一段文案」,还包括可以复核的依据。
三个结论
讲者最后收了三点:
- 不要把希望全押在模型变大上。 更有效的做法,是给模型提供高质量的上下文。上下文到位,准确率和成本都会改善。
- 上下文架构应该成为公司的共同基盘。 先建好这一层,上面才能长出几十、几百甚至几千个代理,而不是每个团队各自造一套。
- 数据、计算和代理应该端到端托管。 企业不必自己拼装每一块,才能把精力放在业务定义和场景上。
他还提到,11 月 14 日会在 Google 的办公室举办一场关于 AI 与数据的活动,会有客户案例和 hands-on 环节。这算是给整场分享留的一个入口:架构听懂了,下一步是带着自己的数据来试。
写在最后
这场分享真正有价值的地方,不是又介绍了一个新名词,而是把「AI 落地难」拆成了一个可以动手解决的问题:不是模型不够聪明,而是企业没有把「我们这里的词是什么意思」变成机器可读的东西。
定义、口径、权限、血缘,这些听起来很「传统数据治理」的工作,在代理时代反而变得更重要了。因为人可以从上下文里猜,代理不会——它只会按你给的定义执行。给对了,它是靠谱的同事;给错了,它会把错误放大到每一个来问答案的人面前。