モデルがボトルネックではない。Agent 導入に本当に足りないのは「理解できる」データコンテキスト
生成AIは、質問に答える段階から、ゴールを与えれば自律的に動くエージェントへと変わりつつある。本記事では、Google Cloudの登壇者が語ったAgent導入の本質を整理。幻覚の原因はモデルではなく業務定義の欠如にあること、PoCが規模拡大で壁にぶつかる理由、データ・メタデータ・セマンティック層を組み合わせた「コンテキストアーキテクチャ」、そして比較実験とデモの結果を紹介する。

モデルがボトルネックではない。Agent 導入に本当に足りないのは「理解できる」データコンテキスト
2023年、多くの人は生成AIをチャット欄に一文を入力し、テキストやSQL、下書きを返してもらう形で使っていた。それが今、インタラクションの形は変わりつつある。人がゴールを与え、AIエージェントが自分でタスクを分解し、ツールを呼び、実行し、確認して、結果を届ける。
この変化は「能力が上がった」だけに見えるが、企業が使いこなせるかどうかを決めるのは、モデルそのものではないことが多い。データとAIをテーマにしたイベントで、Google Cloud の登壇者は、問題は別のところにあると指摘した。エージェントが人に代わって分析やレポート作成、さらにはアナリストの仕事の一部を引き受けるようになると、企業に足りないのは、業務定義・データの意味・計算口径をはっきり伝える「コンテキスト」の層だ、と。この層がなければ、モデルが賢いほど、誤りは自信たっぷりに返ってくる。
「SQLを生成する」から「ゴールを達成する」へ
登壇者はこの変化をこう振り返る。以前はAIにSQLや文章を生成させる、つまり「一つの問いに一つの答えを返す」のが中心だった。今注目されているのはエージェントだ。目的を与えると、その過程で次に何をすべきかを自分で決める。
この流れは実際の業務に入っている。登壇者は、ある企業(たとえばMercari)が分析型エージェントを分析業務に使っている例を挙げた。目的は「クエリを生成する」ことではなく、もともと人が担っていた分析プロセスの一部を置き換えることだ。結果を返すだけでなく、ユーザーの背景や業務課題を踏まえ、次にどんなアクションを取るべきかまで提案する。
彼はエージェントに必要な能力をいくつかの層に分けた。スキル層はツールの呼び出し、SQL生成、レポート作成を担う。実行フレームワーク(ハーネス)は計画・実行・確認のループと、システムに書き込まれた指示を担う。その外側にモデルがある。
しかし、これだけでは「仕事ができる」状態には一歩足りない。登壇者の言い方は率直だ。「これだけでは足りない。実務にはまだ欠けているものがある」と。
幻覚はモデルの問題とは限らない。定義の問題だ
彼は小さな例を挙げた。同じ「売上」でも、マーケティング部門と財務部門が指す数字は同じとは限らない。
マーケティングは取引が発生した時点の金額を見る。税込みで、受注や入金のタイミングで数えるかもしれない。財務は会計ルールに従い、税を抜き、収益認識のルールで計上し、さらに一部の項目を差し引く。どちらの計算も、それぞれの文脈では「正しい」。しかし「今話しているのはどちらの売上か」が共有されていなければ、エージェントは二つの定義の間を行き来し、最後にはもっともらしいが噛み合わない数字を返す。
こうした誤りは「モデルの幻覚(ハルシネーション)」と呼ばれがちだ。登壇者の判断はこうだ。問題はモデルにあるのではなく、定義がコンテキストに書き込まれていないことにある。モデルはあなたの会社の「売上」が何を指すのか知らないから、推測するしかない。
この例が重要なのは、なぜデモは華々しいのに業務に入ると機能しないのかを説明してくれるからだ。デモの問題は孤立していて定義も明確だ。実際の業務の問題の背後には、組織の取り決めが一式ぶら下がっている。
PoCは通る。規模を上げた瞬間に壁にぶつかる
もう一つのよくある落とし穴はPoC(概念検証)だ。登壇者は言う。一つのシナリオのSQLを書き、一本のパイプラインを通すのは、たいてい難しくない。難しいのは、それを数十、数百のシナリオに広げ、24時間、大量の問い合わせを受けることだ。
このとき、いくつかの問題が同時に現れる。
- コスト:毎回、大規模モデルにテーブル構造と業務口径をゼロから理解させるので、トークン消費が大きい。
- レイテンシ:複雑な問題は何度も往復する必要があり、ユーザーは待てない。
- ガバナンス:誰がどのデータを見られるのか、どの定義をどのエージェントが使えるのか。権限と監査が要る。
- 再現性:同じ質問に対して、今日と明日、この人とあの人で、答えが一致しなければならない。
だからデータ基盤の役割も変わる。これまでのデータプラットフォームは主に「人が読むためのもの」だった。人がレポートを見て、数字を調べ、分析する。今はそれに加えて「AIが理解し、行動するためのもの」でなければならない。エージェントがその中でデータを見つけ、意味を理解し、正しい口径で計算し、権限を越えないことだ。
コンテキストアーキテクチャ:「このデータは何か」を説明する
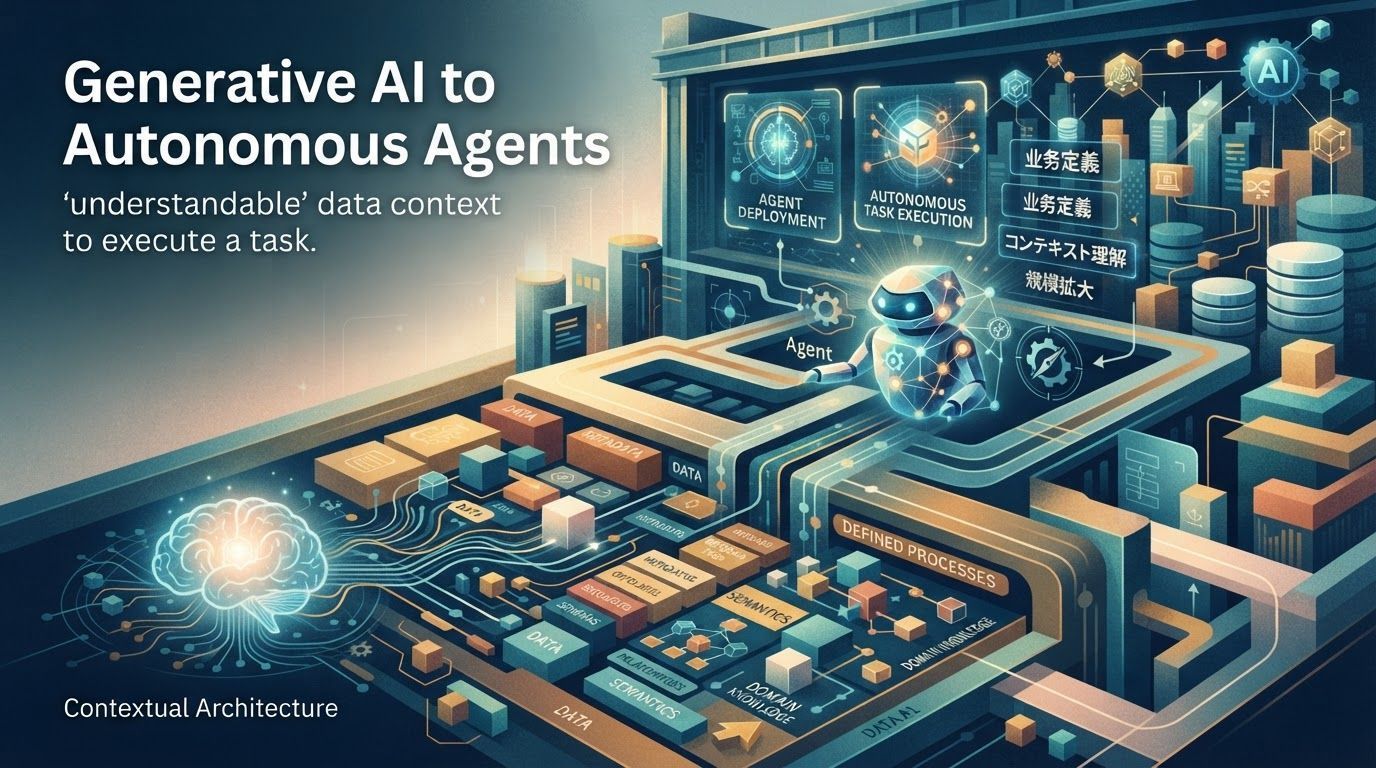
登壇者が示した解は、「コンテキストアーキテクチャ」と呼ぶ層構造の設計だ。複雑ではないが、各層がエージェントの問いに答えている。
- データはどこにあるか:データソース層。BigQueryのようなデータウェアハウスもあれば、業務システムや他のクラウド上のデータもある。
- 誰が使えるか:権限とガバナンス。どのデータ、どの定義を、どのエージェントに開放するか。
- これは何のデータか:メタデータ。テーブル、カラム、業務上の意味、責任者。
- それは何を意味するか:セマンティック層。「売上」「アクティブユーザー」「関西エリア」といった言葉を、実際のカラムや口径に対応づける。
- どう計算するか:指標と計算ロジック。業務定義を実行可能な式として固定する。
- どう使うか:最後にエージェントやAPIを通じて、上の能力をユーザーに届ける。
彼は、このアーキテクチャは日本チームの実践から生まれたものだと強調した。この点は重要だ。企業AIの難しさは非常にローカルで、組織の習慣、データの現状、コンプライアンス要件がそれぞれ違う。コピーできるのは具体的な実装ではなく、層に分ける考え方であることが多い。
三種類の分析、三つのやり方
このアーキテクチャの上で、登壇者は分析を三つに分け、それぞれ違う方法で扱う。
- 決定的な分析:口径が固定され、答えが一意になるもの。たとえば「先月の関西エリアの売上」。これはセマンティック層と定義済みの計算ロジックを通すべきで、結果は再現できる。
- 探索的な分析:問いがその場で生まれ、見ながら探す必要があるもの。たとえば「最近どの顧客層の離脱が増えているか」。これは生成AIに向いており、人が一緒に見ながら進める。
- エージェント型の仕事:ゴールは明確だが手順は固定されないもの。たとえば「大阪のマーケティング施策を一案作り、効果まで検証して」。エージェントが自分で計画し、ツールを呼び、結果を出す。
ここで最も重要なのは一つ目だ。登壇者は「注文—決済」を例にした。一つの注文に複数の決済、返金、調整が対応することがある。売上は明確なルールの下で一度だけ計算されるべきだ。毎回モデルに自由にやらせれば、同じ質問に違う数字が返る。
彼らのやり方はこうだ。エージェントがまず用語辞書を引き、「売上」が何を指すか確認する。次にセマンティック層が計算式を出す。最後に決定的なSQLを生成する。自然言語の柔軟性と、従来のデータ基盤の信頼性を両立させる。登壇者はこれを「決定論的」なやり方と呼んだ。モデルに推測させるのではなく、モデルに定義済みのロジックを呼ばせるのだ。
比較実験:コンテキストを足すと、どれだけ変わるか
このアーキテクチャを検証するため、登壇者は社内で比較実験を行った。
実験には五種類の問題を使い、それぞれ20回ずつ実行した。単純なものから複雑なものまで含み、時間条件が付くもの、主体を識別する必要があるもの、「監査調整後の売上」のように条件が多いものも含まれる。一方はコンテキストなしのベースライン、もう一方はコンテキストアーキテクチャにつないだエージェントだ。
結果はいくつかの軸で見る。
- 精度:コンテキストを与えた側が明らかに良い。特に条件が複雑で、業務口径を正しく理解する必要がある問題で差が出る。
- 実行ステップ:ベースラインはテーブルやカラムを何度も試し、遠回りしがちだ。コンテキストを与えた側は経路が短い。
- コスト:トークン消費と実行回数が下がる。
登壇者は制約も挙げた。軽量なモデルを使った検証も行い、コンテキストを足すと確かに改善したが、複雑な問題には依然としてより強力なモデルが必要で、コストも高い。つまりコンテキストは「小さなモデルで大きなモデルを置き換える」魔法ではない。問題の難易度を下げ、モデルが本当に推論すべきところに力を割けるようにするものだ。
この点は、「コンテキストがあれば良いモデルは要らない」という誤読を避けるために重要だ。
マネージド機能:「コンテキスト」を運用できるものにする
アーキテクチャを説明した後、実装のもう一面は運用だ。登壇者はGoogle Cloudのデータ層のいくつかの機能を紹介した。
- サーバーレスのデータウェアハウス:BigQueryはクラスタを事前に計画する必要がなく、立ち上げが速く、計算リソースは必要に応じて伸縮する。
- ゼロコピー連携:業務データが他のクラウドや業務システムにある場合、フェデレーテッドクエリやゼロコピーの方式で直接分析できる。データをまずコピーする必要も、夜間バッチを待つ必要もない。注文、在庫、金融取引などのリアルタイム状態をそのまま使える。
- メタデータとリネージ:テーブル、カラム、上流・下流の関係、データ品質、権限を記録し、問い合わせられる。エージェントは回答に根拠を添えられる。
- 継続的な学習:エージェントが問い合わせるたび、修正するたびに、それがセマンティック層とメタデータを豊かにし、次回の精度を上げる。
最後の点を登壇者は特に強調した。コンテキスト層は「作って終わり」のプロジェクトではなく、継続的に保守すべき資産だ。業務定義は変わるし、テーブルも変わる。エージェントの誤りは定義の穴を暴く。システムはそうした利用の痕跡から学ぶ必要があり、人が何度も文書を書き直すのではない。
デモ:架空の銀行の「借換え」
登壇者は架空の「桜銀行」でデモを行った。題材は住宅ローンの借換えだ。顧客は複数の案を比較したいが、質問は曖昧だ。「私の場合、どのページで計算できますか」。
エージェントは質問を受けると、まず既存の定義と付加情報から顧客の状況を判断し、次に該当するデータを探し、分析を完了し、最後に集計結果をダッシュボードとして表示する。デモにはもう一つ細部がある。一部の顧客データは他のクラウドのデータベースにあり、ゼロコピーでアクセスする。BigQueryに先に同期する必要はない。
結果はゴールではない。登壇者は、データサイエンティストがエージェントの分析過程を引き続き確認し、口径を検査し、誤りを修正できると強調した。エージェントが出した結論と修正は、誰かのチャット履歴に残るのではなく、知識として蓄積される。そうすればデータ資産は人の異動によって「属人化」せず、新しく来た人も「この数字がどうやって出たか」を見られる。
デモの後半はマーケティングの場面に変わる。大阪でキャンペーンを実施するため、対象顧客を探し、オーディエンスを層別し、都道府県別・市区町村別に分布を見て、素材を生成し、最後にBIツールで効果を検証する。エージェントはこれらをつなぎ、「コピー一本」だけでなく、検証できる根拠まで出す。
三つの結論
登壇者は最後に三点をまとめた。
- モデルを大きくすることに期待を全部賭けない。 より有効なのは、モデルに高品質なコンテキストを与えることだ。コンテキストが揃えば、精度もコストも改善する。
- コンテキストアーキテクチャは会社の共通基盤になるべきだ。 この層を先に作れば、その上に数十、数百、数千のエージェントを生やせる。各チームが別々に作る必要はない。
- データ、計算、エージェントはエンドツーエンドでマネージドであるべきだ。 企業がすべてを自前で組み立てる必要がなく、業務定義とシナリオに集中できる。
彼はまた、11月14日にGoogleのオフィスでAIとデータに関するイベントを開催する予定で、顧客事例とハンズオンもあると話した。アーキテクチャを聞いて理解した次の一歩は、自分のデータを持って試すことだ、という入口である。
最後に
この講演の本当の価値は、また新しい用語を紹介したことではない。「AI導入が難しい」を、手を動かして解ける問題に分解したことだ。モデルが賢くないからではない。企業が「私たちのところのこの言葉は何を意味するのか」を機械可読な形にしていないのだ。
定義、口径、権限、リネージ。伝統的なデータガバナンスのように聞こえるこれらの作業は、エージェント時代にこそ重要になる。人はコンテキストから推測できるが、エージェントはできない。与えられた定義どおりに実行するだけだ。正しく与えれば頼れる同僚になり、間違って与えれば、答えを求めてくる全員に誤りを増幅して返す。