
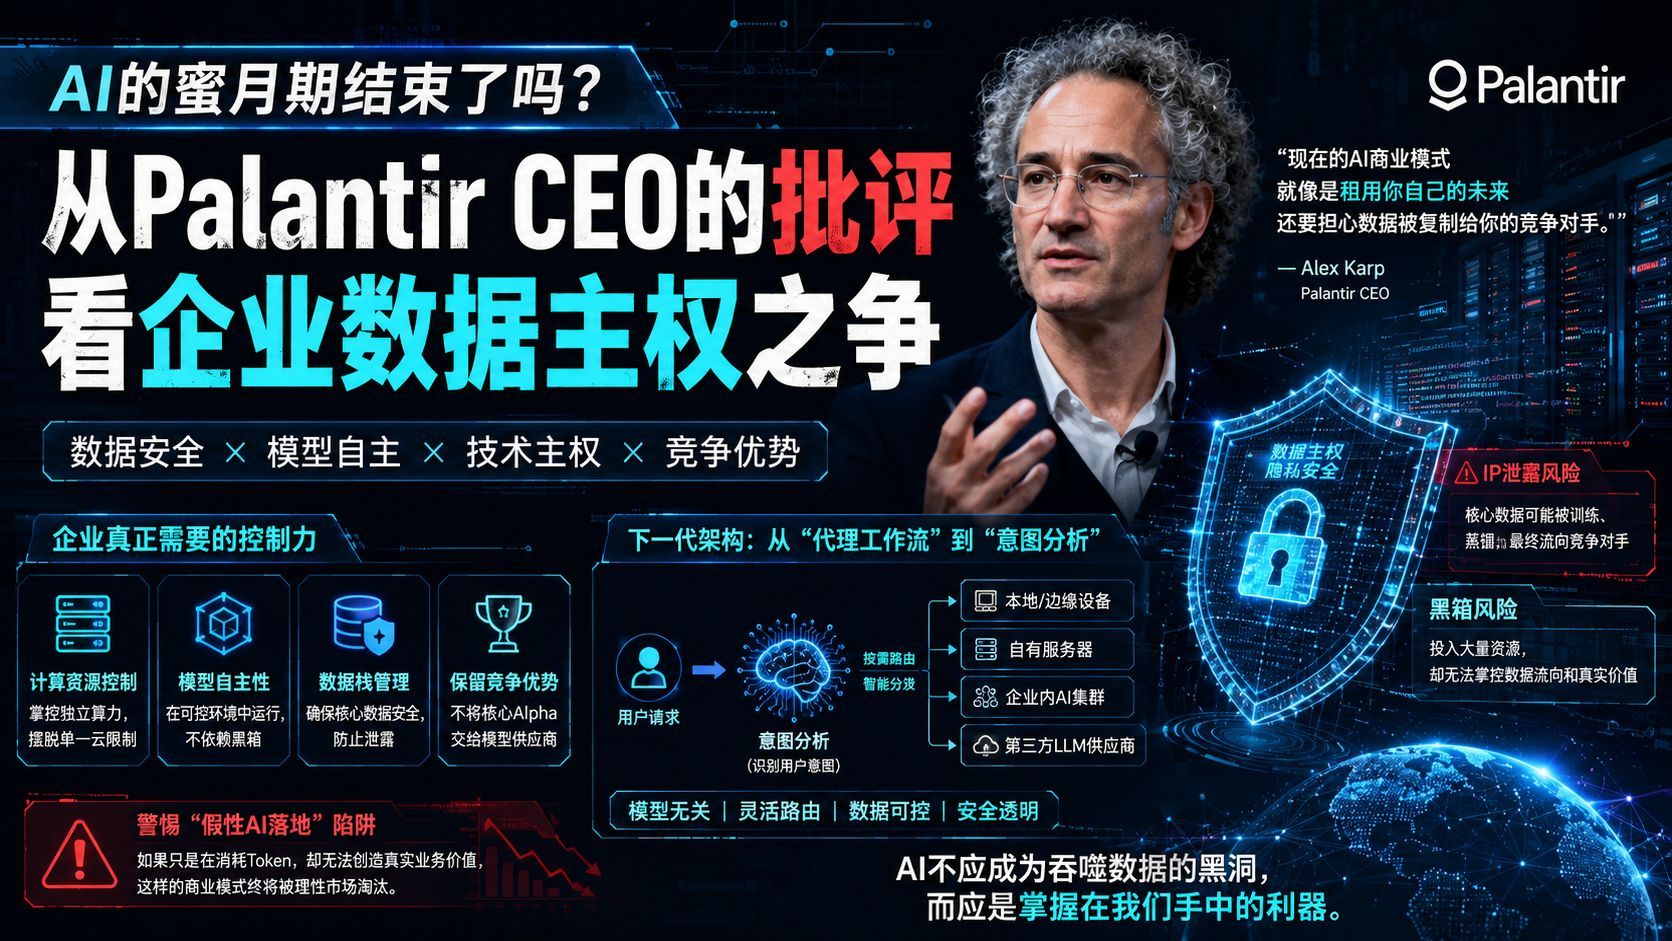
AI产业的“蜜月期”结束了吗?Palantir CEO对企业数据主权与AI架构的深刻反思
本文基于Palantir CEO Alex Karp对当前AI商业模式的尖锐批评,探讨了企业在部署AI时面临的真实困境。面对算力成本高昂、知识产权泄露风险以及“黑盒”模型带来的不确定性,企业需要重新夺回对技术栈的控制权。文章分析了从单纯的代理工作流向“意图分析”驱动的分布式架构转型的必要性,旨在为构建更安全、透明且可控的企业级AI系统提供工程视角的思考。

AI的蜜月期结束了吗?从Palantir CEO的吐槽看企业数据主权之争
最近,科技圈被Palantir CEO Alex Karp的一段访谈刷屏了。视频中他直言不讳地指出当前AI商业模式中存在的问题。作为整天在代码堆里摸爬滚打的工程师,听到这些观点时,我不禁会心一笑——这哪是“炮轰”,这分明是道出了许多在企业一线部署AI的工程师们心中“不敢说”的苦水。
企业的“Token 焦虑症”:投入产出的不对称
我们先来聊聊现状。现在的AI部署往往陷入了一种尴尬的境地:企业投入了海量的算力资源和Token成本,但在实际业务中却难以看到实质性的产出。
这就像是一个巨大的“黑盒工程”:你把核心数据扔进去,看着API跑得飞快,心里却在打鼓。企业管理者在私下里其实非常焦虑:
- IP流失风险: 如果我把核心知识产权作为Prompt喂给了模型,这些数据会不会变成训练集,最终通过模型蒸馏让我的竞争对手获益?
- “假部署”陷阱: 很多所谓的AI解决方案,本质上只是把企业的核心价值“搬运”给了第三方供应商,企业自身却失去了对生产资料的掌控。
这不仅是商业逻辑的问题,更是关乎技术架构安全的核心议题。对于工程师来说,如果一个系统让你感到失去控制,那么无论它的响应速度有多快,它在生产环境中的地位都是岌岌可危的。
工程师的诉求:夺回掌控权
Alex Karp提到的观点非常精准:技术客户现在最迫切的需求,不是更炫酷的UI,而是“掌控力”。当我们审视企业级架构时,真正的硬需求归纳起来其实就是这四个维度:
- 算力控制: 拥有独立支配计算资源的能力,拒绝被单一云端限流。
- 模型自主: 确保模型运行在可控的环境中,而不是完全依赖于供应商的黑盒。
- 数据栈管理: 确保核心数据在处理过程中的绝对安全,不发生外泄。
- Alpha 留存: 确保企业的核心竞争优势(Alpha)留在自己手中,而不是作为训练代价贡献给模型供应商。
市场正在呼唤一种“模型无关”(Agnostic)的产品形态。我们不想被死死锁在某一家巨头的生态里,我们需要的是能够灵活切换模型,且具备透明度的数据处理架构。
重建信任:透明度才是硬道理
如果说要给当下的AI狂热泼一盆冷水,那就是“透明度”。企业已经厌倦了过度的营销承诺(Overselling)。要重建信任,供应商必须公开回答:数据到底归谁?数据缓存存在哪?Prompt 是否真的安全?是否存在未经授权的数据流转?
如果一项技术无法带来实打实的商业价值回馈,而仅仅是增加Token消耗,那么这种商业模式迟早会被理性的市场淘汰。
下一代架构:从“Agent Workflow”到“意图分析”
这引出了我对未来架构的思考。正如我之前在分析Nvidia GTC2026时所言,我们正在经历架构设计的范式转移。
过去我们习惯依赖单一的大模型(LLM)来完成所有Agent的工作流,这既贵又不安全。未来的方向应该是:
- 分析意图: 架构的核心不再是“调哪个模型”,而是“识别用户意图”。
- 按需分发: 根据任务的复杂度和安全性需求,动态路由至:
- 本地边缘设备
- 自建服务器
- 企业内部AI集群
- 或者特定的第三方LLM供应商
这种“因地制宜”的架构设计,才是我们作为工程师,在当前动荡的技术环境下应当追求的未来。如果你想更深入地了解这种架构演进,可以参考我的相关思考:【GTC 2026深度解析】智能体AI时代的IT架构重组:NVIDIA(英伟达)的全方位战略与程序员生存指南
归根结底,AI不应该是一个让我们产生“被收割感”的黑洞,而应该是我们手中能够掌控的利器。跳过那些虚浮的炒作,聆听一线真实的声音,这才是我们构建稳健、高效AI系统的正确姿势。