
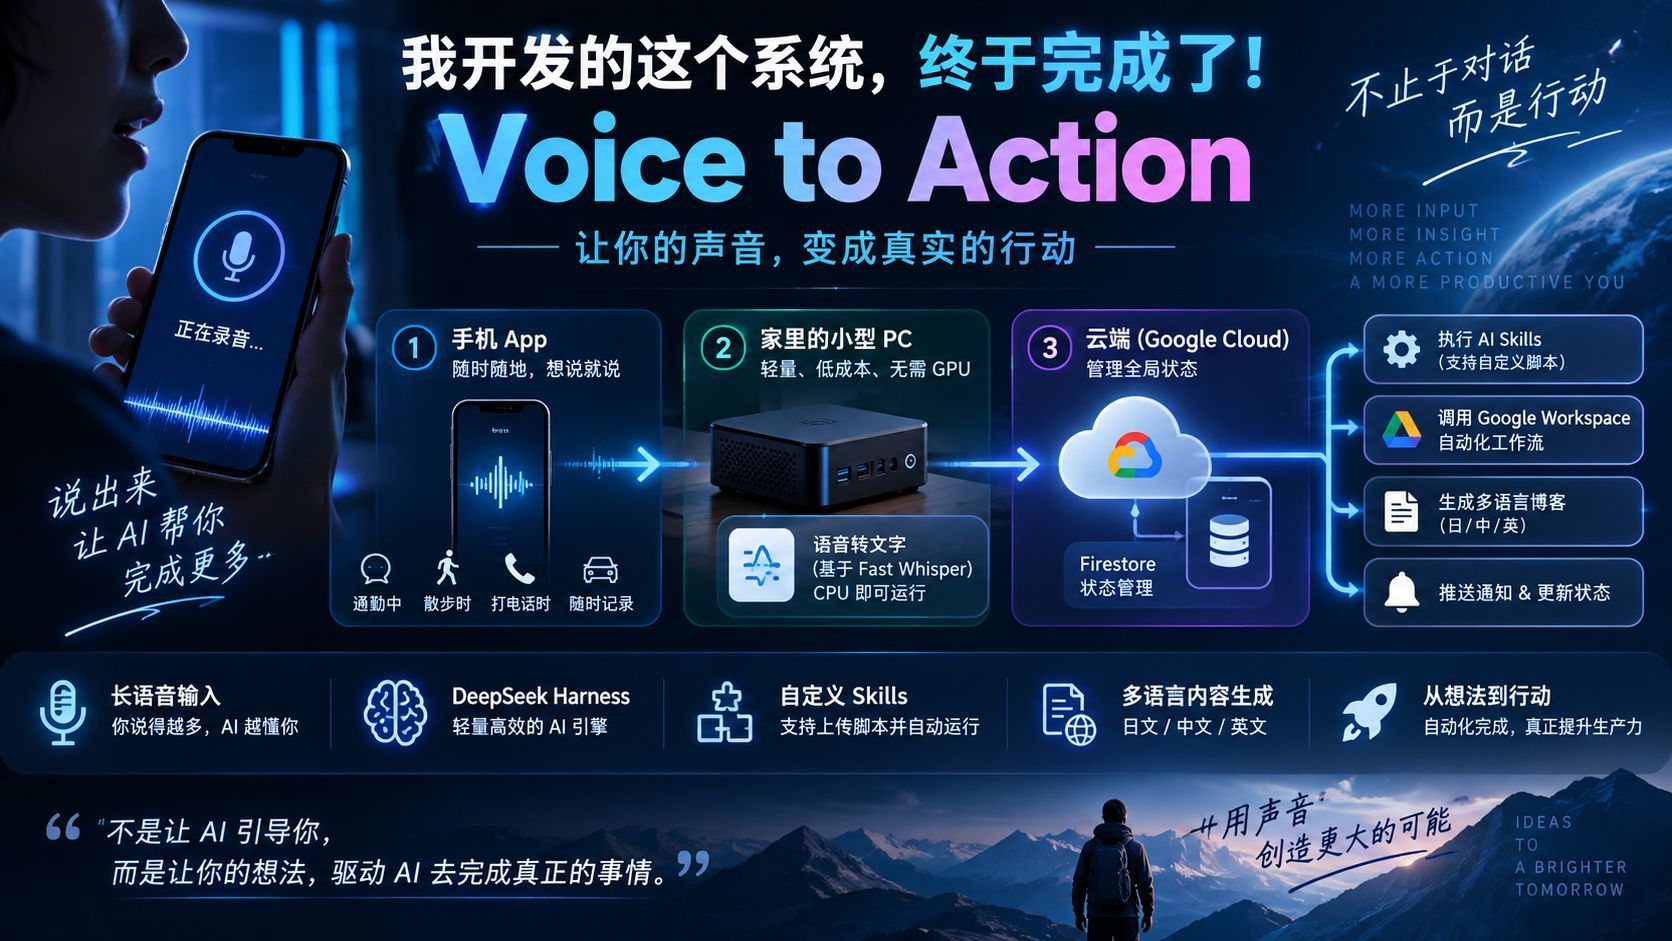
Voice to Action 系统完成:用只有 CPU 的小电脑与 DeepSeek Harness 把录音变成三语博客
以“语音变行动”为理念的 Voice to Action 系统完成。它以家里一台只有 CPU 的小电脑作服务器,配合 App、云端与 Firestore 管理状态,用 Fast Whisper 把语音转成文字;再以 DeepSeek Harness 的 DeepSeek Flash 模型为引擎,执行带 script 的 skills,支持从云端上传并运行。最终实现从录音自动生成日中英三语博客,并通过 API 一键上传。整套方案轻量、不需要 GPU。

我做的这套系统终于完成了:Voice to Action
一、今天,这套系统算是完全做完了
今天,我这套系统算是完全完成了。我给它起的名字叫 Voice to Action(把语音变成行动)。
它由三个部分组成:
- App:手机端的应用;
- 家里的小型电脑:放在家里当服务器;
- 云端:负责维护整个系统的状态。
那么它实现的到底是什么呢?它和以往的聊天式 AI(chat 类 AI)不一样。
二、与聊天式 AI 的本质区别
我这套东西叫 Voice to Action,核心就是「你说话」。
它是一个「说很多话」的东西:你可以一直说、说很多话,然后由这套系统去分析、处理你说的这些话。
这和传统的、像 ChatGPT 那种对话,在概念上、理念上、操作形式上、UX 上都不一样:
- 对话是「你问一句,它答一句」「你问一个,它答一个」;
- 而且你问的内容、它回答的长度和内涵,往往比你问的问题还要多。这就导致一个现象:现在用所谓的(对话式)AI,人们只提一两个词,然后就被 AI 牵着走。
而我的 Voice to Action 是:打电话也好、散步的时候也好,一直跟 AI 说也好,总之就是你说、你一直说一大堆。我这套系统会从人们说的这些话当中,去抽取、提炼出一些信息,再帮你总结成另一个东西。
所以本质的区别在于:以人的意念为主。人首先要能表达、能输入很多东西。这是第一个不同点。
三、第二个开心的地方:做出来一个特别轻量级的东西
我先介绍我的核心——放在家里的那台小电脑,也就是核心 AI 的部分。
1. 硬件:一台二手小电脑,只有 CPU,没有 GPU
这就是一台二手的小型电脑,只有 CPU,连 GPU 都没有。
它就像你家里的一个「AI 管家」,但它不像「小龙虾(OpenClaw)」「爱马仕(Hermes Agent)」那类所谓的 Agent 产品那么复杂。我这套就是做很简单的事。
2. 核心功能一:Speech-to-Text(语音转文字)
系统里一个重大的功能就是 Speech-to-Text:
- 我用的是开源的 Fast Whisper 版本;
- 用 CPU 来做语音转文字(不是文字转语音);
- 通过我的 App 和我的云来处理:把录音文件拿到手,然后就开始转成文字。
3. 本地 UI 监控台与各种小细节
我还配了一个本地的 UI 监控台,里面有很多小细节都是我开发做到的,我也挺开心的。
4. 从 Windows 版 → Mac 版 → 无 GUI 版
最开始是 Windows 版,后来是 Mac 版,现在变成了一个无 GUI(headless)版本。
- 它开机自启;
- 启动之后,它能报出自己的 IP 号:你安装、部署完之后,随便在哪个局域网里都不用担心,只要把它开起来,过一会儿它就会用它这台电脑的 Sound(扬声器)读出自己的 IP 地址,于是你在家里的局域网里就能去看它的处理状态了。
这块是我做的时候的一个小挑战——开机自启动。
5. 音频文件是怎么来的:用 Firestore 做状态管控
这里是一些监控程序。我的音频文件是从哪来的呢?
- 我用谷歌云的 Firestore 做了一个状态的管控程序;
- 手机里处理好的音频文件,我传到谷歌云的 Firebase 之下,然后在 Google Cloud 的 Firebase Firestore 里写一个状态;
- 所有的生命周期、一些硬件设施,都会有这个状态;
- 我本地的程序就去监控这个状态:如果发现有新的东西,就捕捉到,然后把云端的音频下载下来,再转换成文字。
这是第一步,也是第一个功能。
四、第二个核心:把 DeepSeek Harness 重新做了一遍
我这一天还在电脑里开发了一个我觉得特别特别好的核心,也是最近这两天才刚开发的。我基于 DeepSeek Harness 开发了一个 CLI 运行引擎,我个人特别特别兴奋。
1. 只用 DeepSeek Harness 的 DeepSeek Flash 模型做引擎
我的思路是:只用 DeepSeek Harness 的 DeepSeek Flash 模型,来作为运转这套 AI 的引擎。
2. 云端可以上传 skills,而且 skill 里可以带 script
我在云端有一个可以上传 skills 的功能。这和刚才说的「监听云端录音状态」是同一个思路——也就是说,我云端上也有一个我称为 AI Agent 的系统。
用户可以:
- 在云端设置我用哪种分析方法;
- 自己写一个 skill;
- 而且这个 skill 里面可以自己带 script。
这一点就和别人不一样了:到(今年)4、5 月份的时候,包括谷歌的 ADK,都不允许你上传 skills。而我这个是可以上传的——而且不只是那种「不会转」的 skill:一般的 skill 不能写 script,而我这个是可以去执行 script 的。
上传之后,当录音转成文字,就会切换到下一个状态,也就是该用哪一种 AI 去处理。
3. 目前有两种模式 / 两种服务
第一种:Google Workspace Studio。
- 在我的 CMA 里定义:你主要这段文字,想用哪个 Google Workspace Studio 里定义好的工作流来处理;
- 但用过 Google Workspace Studio 的人知道,它其实不是让你定义「一个工作流」,而是当检测到某个文件夹里产生文件时触发;
- 所以我这个 AI server 其中一个功能就是:把转换好的文字,上传到你之前在网页上定义好的那个指定的 Google Drive 文件夹里,去自动触发 Google Workspace Studio。
- 这是 7 月、8 月的事,已经做出来了,而且用得挺好。
第二种:全新的一套。
就是刚才讲的:我在自己电脑里装了 DeepSeek Harness,然后写了一个全局的命令行工具(CLI)。
这个 CLI 做的事情是:
- 你在网上定义了一个 skill,把 skill 的(压缩)文件传上去之后;
- 我先看看本地安装了没有,如果没有安装,我就把它安装下来;
- 然后我通过 CLI 的形式去启动 DeepSeek Harness。
这就很帅了。通常大家都用 Codex 之类的,不都是命令行吗?得自己启动、自己用命令去跑。跑完之后,再在 App 里给我返回、发一个 push 通知。这个我做好了。
以后这里面就是添 skills 就行了:定义 skill、添 skill。这就变成了一个 AI Agent 的引擎。而且你看,在本地一台小破电脑上就能跑,非常轻量级。
如果想上云端的话,也不需要一直启动,可以做成比如基于 Docker 或基于 Cloud Run 的自启动:有服务来的时候就起来,没有服务的时候就让它睡——这种感觉。这一块特别轻量,我觉得很开心。而且不需要 GPU,就很牛的一个玩意儿。
它所有做的事情就是跑 skills。所以 skill 在你本地开发好,通过我云端系统上传,就可以跑。也就是说,别人在市面上卖好几百万、甚至上千万日元的 Agent 系统,我自己就做出来了。
五、今天的另一个成就:把录音变成三语博客的 skill
我今天还有一个成就。我在研究 skill 的时候——skill 是可以写 script 的——我用 DeepSeek V4 Flash 4.1 实现了一个 skill:
- 把我的录音变成博客;
- 而且要翻译成日文、中文、英文;
- 还得写它的摘要(summary)、关键词(keyword)、标题(title),整理成一个完整的发布单元(station);
- 最后上传到我的博客系统里。
我的博客系统有一个 API,上传到这个 API 的是一个 script(一个工具)。也就是说,用我刚才那个 skill 和 AI:生成一些文字之后,还得用 AI 去启动我这个 script,把这四个文件——中文版 MD、英文版 MD、日文版 MD,还有一个各种 information 的 JSON——通过我写好的 API script,一键上传到我的博客系统里。
这个 skill 我就做出来了。
完整链路(结论)
我通过我的 App 录了很长的一段——包括现在这篇文章,我就是这么做的——很长一段语音,然后:
- 通过 App 自动上传;
- 上传到云,云上更改 Firestore 的一个状态;
- 状态更新完之后,我本地的电脑就监测到了这个状态变化;
- 它去把录音文件下载下来;
- 发现我指定的处理是这个 harness、这个名字叫「博客上传」的那个 skill;
- 那么它在我本机里,通过名字自己就开启了 skills;
- 这个 skill 帮我转成日语、英语、中文三种语言的博客;
- 然后自己上传到我的博客系统里;
- 再给我发一个通知,最后把网上的处理状态变成「完成」。
这么一套东西,我做出来了,觉得「哇塞,很牛」。
就是完成了我之前的那个理念:人做一大堆话(说了很多话),然后 AI 去挑它有用的信息,帮去处理。而且不仅处理,还要做 action。所谓 action,就是与机器交互:不是文字了,它有一个动作——它把我的信息存到了我另一台网上的博客系统里。
这就是我构建的这套全新的 AI、AI 与人的系统。所以第一阶段算是做完了,非常开心。
六、接下来的事
接下来,感觉就是之前一直没推进的事——一直处在某种限制当中。
我跳槽了、转职了,虽然还没入职,新公司让我天天去看看。总之,人类社会当中,每个人有每个人的各种复杂心情,这也扰乱了我的心绪,让我自己静下来做自己的事。
还有一点:我一直困扰在 Voice to Action 的下一步——下一步是什么?
这不是第一个 action 吗?当你的 action 增多,你的 engine 怎么来判断哪个是「最好的 action」、怎么自动判断?这块比如说我想用 GraphRAG,或者一些其他的手法去做,但感觉还是应该等一等。
为什么这么说呢?我也不是为了蹭热度。你看就这两天,网上 JV 新型的 AI模型 很火,它就是做分类的。所以说老天爷会来给我递枕头:我首先把轻量级的 AI 做出来了;接下来随着我这种 Voice to Action 的 action skills 增加起来,我接下来要开发的就是一个选择器,而这个选择器接下来就要用 Jev 去做——因为我就去干这事的:有大量的信息,然后去看这些信息到底匹配哪一个功能。这不是 Jev 吗?它是最好的、最新的创新型 AI。这就是赶上了,感觉很开心,也很跃跃欲试。
总之,我感觉我这东西继续发展下去,会成为一个新的改变。我希望它变成一个改变人类社会的、工作增效的东西。
最起码,与其你一点一点地去 prompt、去问 AI,坐在那儿自己去比划,不如说你通过半个小时、一个小时,把你的这些东西用你的嘴说出来,然后再用新型的这种 Voice to Action 的形式,把对人类社会有意义的 action 抽出来,然后去动作。我感觉这才是最好的。