
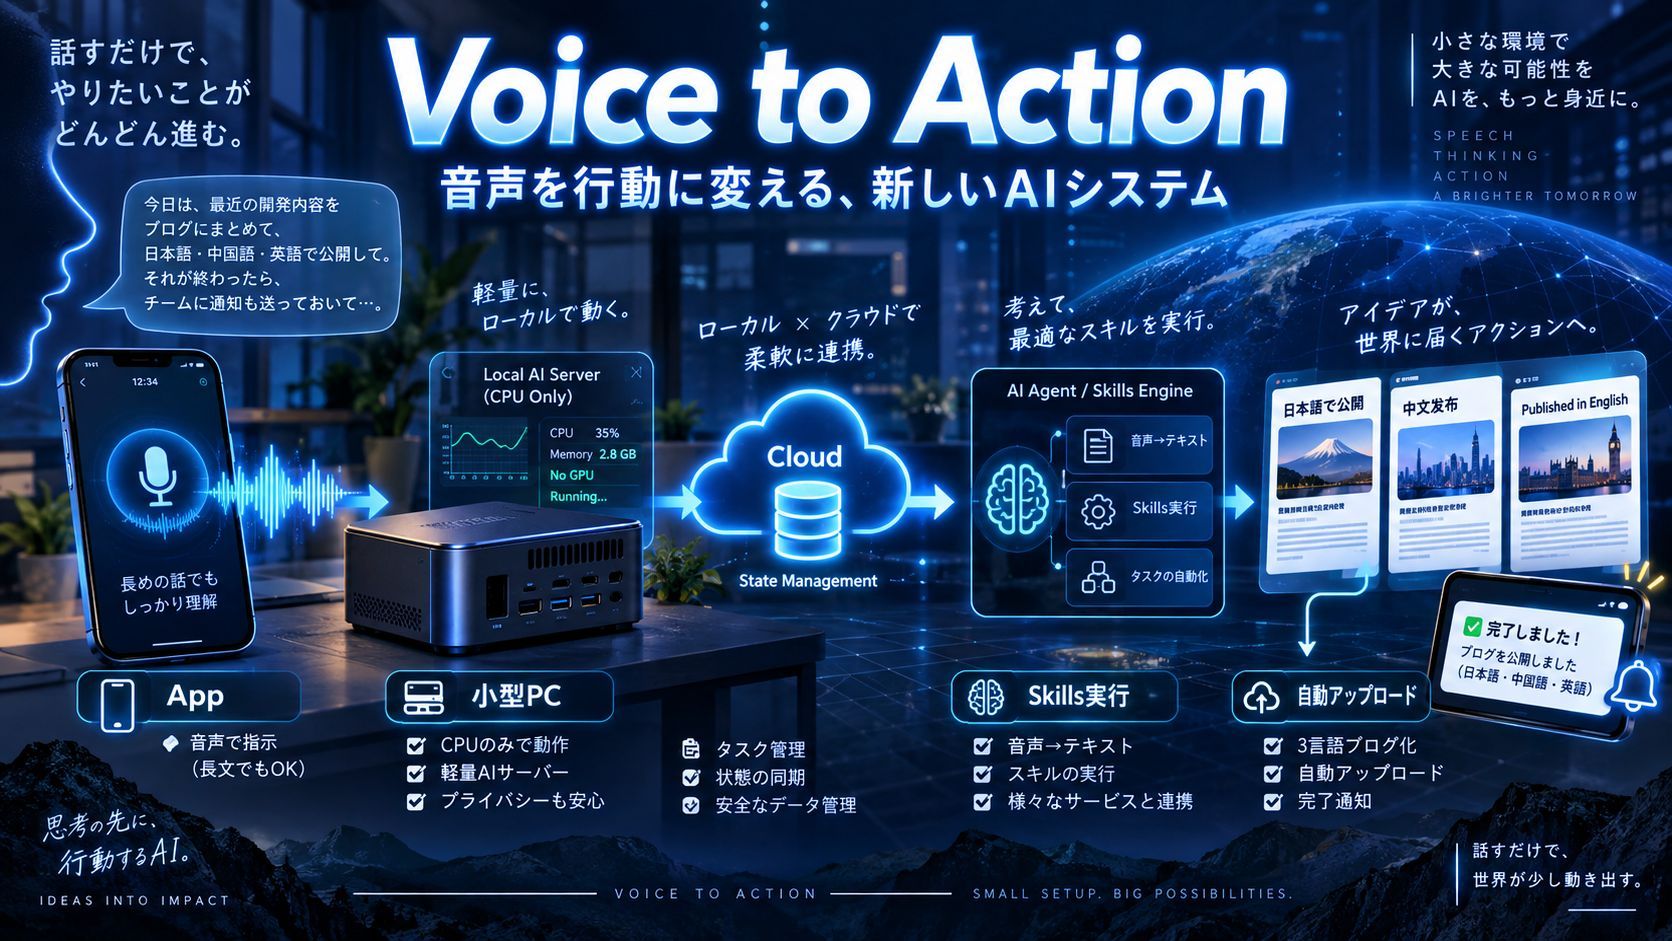
Voice to Action 完成:自宅のCPU小型PCとDeepSeek Harnessで音声を3言語ブログへ
音声を行動に変える「Voice to Action」システムが完成した。自宅のCPUのみの小型PCをサーバーに、Appとクラウド、Firestoreで状態を管理し、Fast Whisperで音声を文字化する。DeepSeek HarnessのDeepSeek Flashモデルをエンジンに、script付きskillsを実行。録音から日・中・英の3言語ブログを生成し、API経由で自動投稿するところまで実現した。軽量でGPU不要な点が特徴。

私が作ったこのシステムがついに完成した:Voice to Action
一、今日、このシステムがついに完成した
今日、このシステムがついに完全に完成しました。私がつけた名前は Voice to Action(音声を行動に変える)です。
これは3つの部分からできています。
- App:スマートフォン側のアプリ;
- 家にある小型PC:自宅に置いてサーバーにする;
- クラウド:システム全体の状態を管理する。
では、これが実現しているのはいったい何なのか。それは従来のチャット型AIとは違います。
二、チャット型AIとの本質的な違い
私のこの仕組みは Voice to Action と呼ばれるもので、核心は「あなたが話す」ことです。
これは「たくさん話す」ためのものです。あなたは話し続けることができ、たくさん話すことができ、その話した内容をこのシステムが分析・処理します。
これは従来の、ChatGPTのような対話とは、概念の上でも、理念の上でも、操作の形の上でも、UXの上でも違います。
- 対話は「あなたが一つ聞けば、相手が一つ答える」「一つ聞けば一つ答える」;
- しかも、あなたが聞いた内容や、相手が答える長さ・内包は、あなたが聞いた質問よりも多いことさえある。ここからある現象が起きます。いわゆる(対話型の)AIでは、人は一つ二つの言葉を投げるだけで、AIに引っ張られてしまうのです。
それに対して私の Voice to Action は、電話でも、散歩中でも、AIとずっと話していても、とにかくあなたが話し、あなたがたくさん話し続ける。私のこのシステムが、人が話した言葉の中から情報を抜き出し、抽出し、別の何かにまとめ直してくれます。
つまり本質的な違いは、人間の意念(意志・意図)を主とすることです。まず人間が表現でき、多くのことを入力できる。これが一つ目の違いです。
三、二つ目に嬉しい点:とにかく軽量なものを作れた
まず私の中核を紹介します。家に置いてあるあの小型PC、つまり中核となるAIの部分です。
1. ハードウェア:中古の小型PC、CPUのみでGPUなし
これは中古の小型PCで、CPUしかなく、GPUは載っていません。
いわばあなたの家にいる「AI執事」のようなものですが、「OpenClaw」や「Hermes Agent」といった、いわゆるAgent系プロダクトのように複雑ではありません。私のこれは、とてもシンプルなことだけをします。
2. 中核機能その1:Speech-to-Text(音声→テキスト)
システムの中でも大きな機能が Speech-to-Text です。
- 私が使っているのはオープンソースの Fast Whisper版;
- CPU で音声をテキストに変換します(テキストを音声にするのではなく、音声をテキストにする);
- 私のAppとクラウドを通して処理します。録音ファイルを手に入れたら、そこからテキストへの変換が始まります。
3. ローカルUI監視コンソールと細かな工夫
さらにローカルのUI監視コンソールも用意しました。その中には私が開発して実現した細かなディテールがたくさんあって、それも嬉しく思っています。
4. Windows版 → Mac版 → GUIなし版へ
最初はWindows版でした。その後Mac版になり、今はGUIなし(headless)版になりました。
- 起動時に自動起動します;
- 起動すると、自分のIPアドレスを教えてくれます。インストールしてデプロイした後、どのLANにいても心配はいりません。電源を入れてしばらくすると、そのPCのSound(スピーカー)で自分のIPアドレスを読み上げてくれるので、家のLANの中からその処理状態を見に行けるのです。
ここは私が作るときの小さな挑戦でした——起動時の自動起動です。
5. 音声ファイルはどこから来るのか:Firestoreで状態管理
ここは監視プログラムの部分です。私の音声ファイルはどこから来るのか。
- 私はGoogle Cloudの Firestore で状態を管理するプログラムを作りました;
- スマートフォン側で処理が終わった音声ファイルを、Google CloudのFirebaseの下にアップロードし、そしてGoogle CloudのFirebase Firestoreに状態を書き込みます;
- ライフサイクルのすべて、いくつかのハードウェア設備が、この状態を持ちます;
- 私のローカルのプログラムがその状態を監視します。新しいものがあると見つけたら、それを捕捉し、クラウド側の音声をダウンロードしてから、テキストに変換します。
これが第一歩であり、一つ目の機能です。
四、二つ目の中核:DeepSeek Harnessを作り直した
私はこの日、PCの中に、これも特別に良いと思う中核をもう一つ開発しました。これもここ最近の二日で作り始めたものです。DeepSeek Harness をベースに、私がCLI化の実行エンジンを作りました。個人的に、これは特別に、特別にワクワクしています。
1. DeepSeek HarnessのDeepSeek Flashモデルだけをエンジンにする
私の考え方はこうです。DeepSeek HarnessのDeepSeek Flashモデルだけを使って、このAIを動かすエンジンにする。
2. クラウドでskillsをアップロードでき、しかもskillにscriptを入れられる
私はクラウドに、skillsをアップロードできる機能を持っています。これは先ほどの「クラウド上の録音状態を監視する」のと同じ考え方です。つまり、私のクラウド上にも、私が AI Agent と呼んでいるシステムがあります。
ユーザーは次のことができます。
- クラウドで、どの分析方法を使うかを設定する;
- 自分でskillを書く;
- しかもそのskillの中に、自分でscriptを入れられる。
この点が他とは違います。(今年の)4月、5月の時点では、GoogleのADKを含め、skillsのアップロードは許されていませんでした。それに対して私のこれはアップロードできます。しかも「変換できない」タイプのskillではありません。一般的なskillはscriptを書けませんが、私のこれはscriptを実行できるのです。
アップロードした後、録音がテキストになると、次の状態に切り替わります。つまり、どのAIで処理するか、です。
3. 現在は2つのモード/2つのサービス
一つ目:Google Workspace Studio。
- 私のCMAの中で定義します。このテキストを、どのGoogle Workspace Studioで定義済みのワークフローで処理したいか;
- ただ、Google Workspace Studioを使ったことのある人なら分かる通り、これは「一つのワークフローを定義する」ものではありません。あるフォルダの中にファイルが生成されたことを検知したときに発火するのです;
- ですから私のこのAI serverの機能の一つは、変換し終えたテキストを、あなたが以前Web上で定義しておいた、あの指定のGoogle Driveフォルダにアップロードし、Google Workspace Studioを自動で発火させることです。
- これは7月、8月の話で、すでに作ってあり、しかもかなり良い感じで使えています。
二つ目:まったく新しいもの。
先ほど話したとおりです。私は自分のPCにDeepSeek Harnessを入れ、そしてグローバルなコマンドラインツール(CLI)を書きました。
このCLIがやることは次のとおりです。
- あなたがネット上でskillを定義し、そのskillの(圧縮)ファイルをアップロードしたら;
- まずローカルにインストールされているかを見ます。インストールされていなければ、それをインストールします;
- そしてCLIの形でDeepSeek Harnessを起動します。
これはもう、かっこいいですよね。普通はみんなCodexなどを使いますが、どれもコマンドラインでしょう?自分で起動し、自分でコマンドで走らせなければならない。それが走り終わったら、さらにAppの中に戻して、push通知を一つ送ってくれる。これを作りました。
これからは、ここにskillsを足していくだけです。skillを定義し、skillを足す。これが AI Agentのエンジンになったわけです。しかも見てください、ローカルの小さなポンコツPCでも動きます。とても軽量です。
クラウドに載せたい場合も、ずっと起動しておく必要はありません。たとえば Docker ベース、あるいは Cloud Run ベースの自動起動にして、サービスがあれば起き、サービスがなければ眠らせておく——そんな感じにできます。この部分は特に軽量で、私はとても嬉しく思っています。しかもGPUは不要です。すごい仕組みです。
やっていることは、すべてskillsを走らせることだけです。ですからskillをローカルで開発し、私のクラウドシステム経由でアップロードすれば、動かせます。つまり、世の中で何百万、下手すれば何千万円で売られている Agentシステムを、私は自分で作ってしまったのです。
五、今日のもう一つの成果:録音を3言語ブログにするskill
今日はもう一つの成果があります。私がskillを研究しているとき——skillにはscriptを書けるのですが——DeepSeek V4 Flash 4.1 を使って一つのskillを実現しました。
- 私の録音をブログにする;
- しかも日本語、中国語、英語に翻訳する;
- さらにその要約(summary)、キーワード(keyword)、タイトル(title)を書き、一つの完成した公開単位(station)にまとめる;
- 最後に私のブログシステムへアップロードする。
私のブログシステムには API があり、このAPIへアップロードするのは script(一つのツール)です。つまり、先ほどのskillとAIで文章を生成した後、さらにAIでこのscriptを起動し、4つのファイル——中国語版MD、英語版MD、日本語版MD、そして各種informationのJSON——を、私が書いたAPI script経由で、ワンクリックで私のブログシステムへアップロードするのです。
このskillを作りました。
全体の流れ(結論)
私はAppでとても長い録音をしました——今のこの記事も、まさにこの方法で作っています。長い音声を録り、そして:
- App経由で自動アップロードする;
- クラウドへアップロードし、クラウド上でFirestoreの状態を変更する;
- 状態が更新されると、私のローカルPCがその状態変化を検知する;
- 録音ファイルをダウンロードする;
- 私が指定した処理が、このharness、つまり「ブログアップロード」という名前のあのskillだと分かる;
- するとそれは私のマシンの中で、名前によって自分でskillsを起動する;
- このskillが、日本語・英語・中国語の3言語のブログに変換してくれる;
- そして自分で私のブログシステムへアップロードする;
- さらに私に通知を送り、最後にネット上の処理状態を「完了」に変える。
こういう一連のものを、私は作りました。「すごい」と思っています。
まさに私の以前の理念を実現しました。人間がたくさん話す(たくさん話した)、そしてAIがその中から役に立つ情報を選び、処理を手伝う。しかも処理するだけでなく、actionもする。いわゆるactionとは、機械とインタラクションすることです。もう文字ではなく、動作がある。それが私の情報を、もう一台のネット上のブログシステムに保存したのです。
これが私が構築した、まったく新しいAI、AIと人間のシステムです。ですから第一段階はひとまず終わった、とても嬉しいです。
六、これからのこと
これからは、以前からずっと進められていなかったこと——ずっと何らかの制限の中にあったことです。
私は転職しました。まだ入社していませんが、新しい会社が毎日見に来るようにと言っています。ともかく、人間社会の中では、誰もがそれぞれの複雑な心情を持っています。それも私の心を乱し、自分自身で静かになって自分のことをするようにさせてくれました。
もう一点。私はずっと Voice to Action の次のステップに悩んでいます。次のステップとは何か。
これは最初のactionですよね?あなたのactionが増えていくと、あなたのengineはどれが「最適なaction」かをどう判断するのか、どう自動判断するのか。この部分では、たとえばGraphRAGや、その他の手法でやろうかと思いましたが、やはりもう少し待つべきだと感じています。
なぜそう言うのか。私も話題に乗りたいわけではありません。見てください、ここ二日で、ネット上でJev新型のAIモデルが話題です。あれは分類をするものです。ですから天が私に枕を差し出してくれている。まず私は軽量なAIを作りました。次に、このVoice to Actionのaction skillsが増えていけば、次に私が開発するのは一つのセレクターです。そしてこのセレクターは、次にJevで作ることになります。なぜなら、まさに私がそれをやるからです。大量の情報があり、その情報がどの機能にマッチするのかを見る。これはJevですよね?それは最高の、最新の革新的なAIです。これはもう、追い風が来た。とても嬉しく、そしてワクワクしています。
ともかく、私のこの仕組みがこのまま発展していけば、新しい変化になると感じています。私はこれが、人類社会を変える、仕事を効率化するものになってほしい。
少なくとも、あなたが一つ一つpromptしてAIに聞き、そこに座って自分であれこれ比べるより、むしろあなたが30分、1時間かけて、あなたのこれらのものを自分の口で話し、そして新しいこのVoice to Actionの形式で、人類社会にとって意味のあるactionを抜き出し、そして動かす。これこそが最高だと私は思います。