
AI動向 DeepSeek Harness 阅读时间 5 分钟
DeepSeek Harness 官方 Desktop 版测评:语音输入插件与 SenseVoice 等 AI 语音核心模型解析
本文介绍了 DeepSeek Harness 官方 Desktop 版的更新亮点,包括继承命令行版本设置与新增的语音输入插件。同时分享了在配置语音功能时发现的 M5Stack AI-8850 硬件扩展卡,并详细解析了 Whisper、MeloTTS、SenseVoice、CosyVoice2 和 3D-Speaker-MT 等 5 个 AI 语音核心模型的功能与特点。

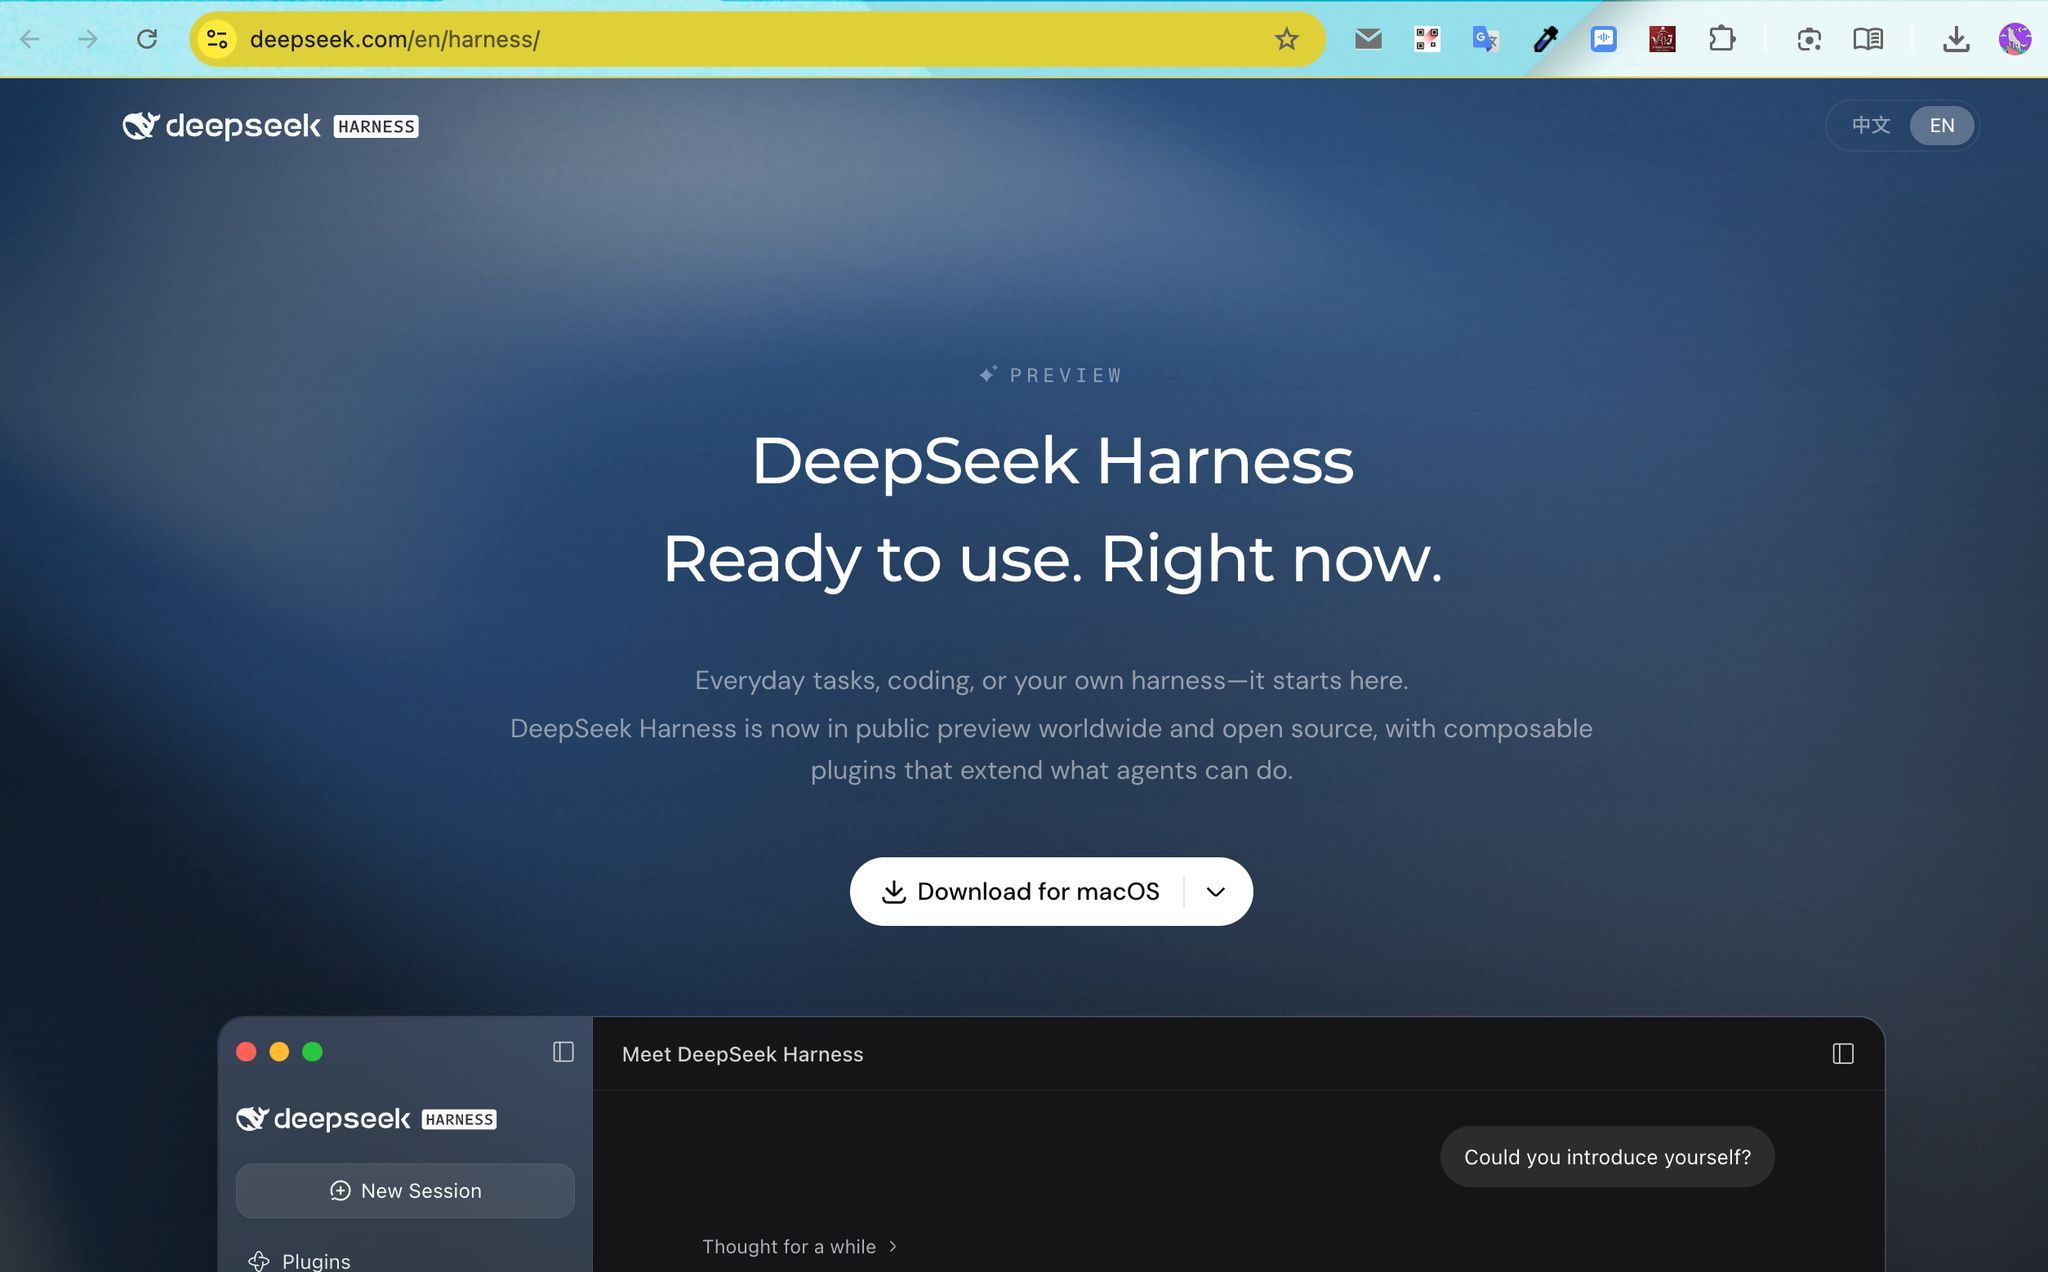
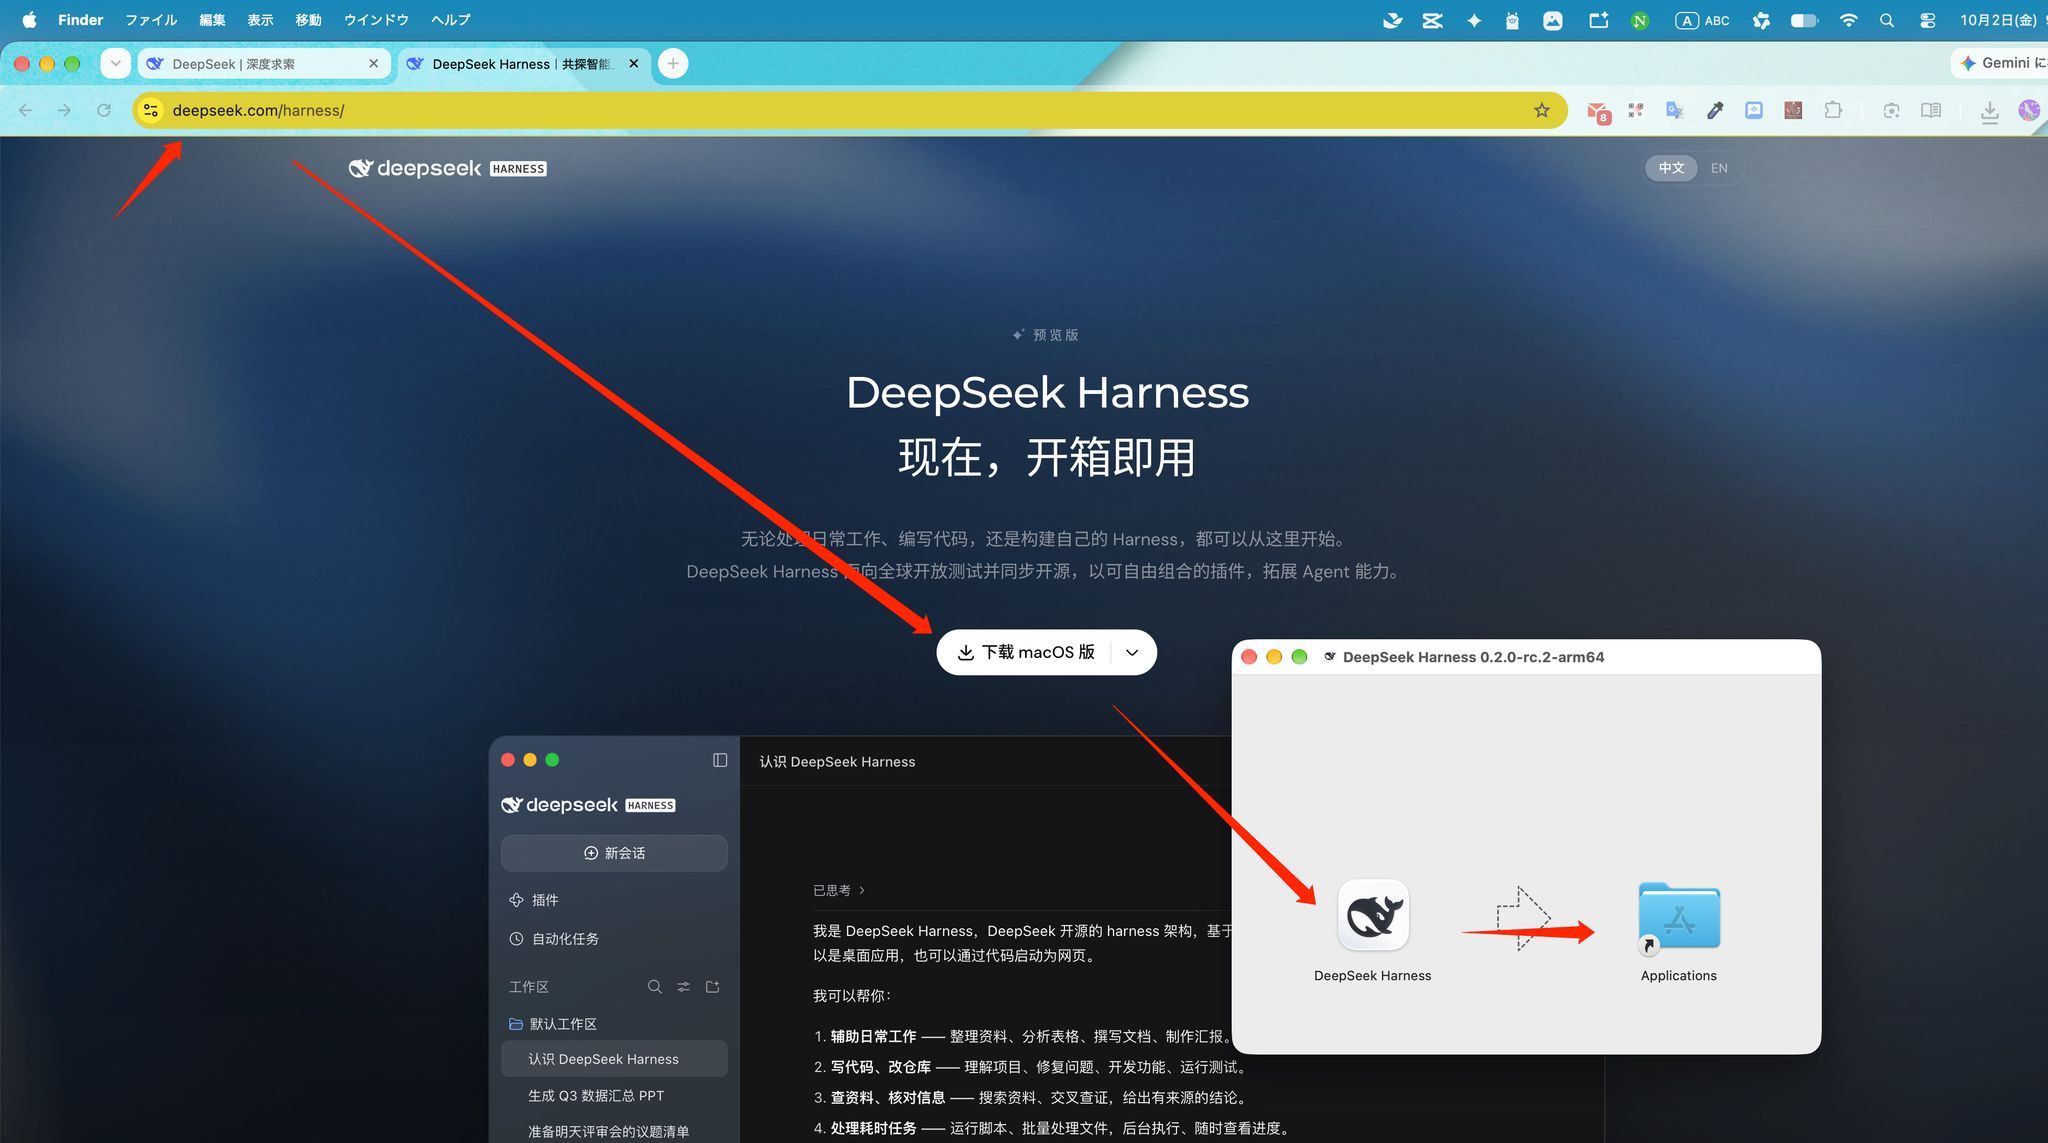
速报!DeepSeek Harness 官方 Desktop 版正式发布!我也在第一时间上手研究体验了一番。
总体来看,这次更新有两个让人非常惊喜的收获:
- 无缝无痛升级:如果你之前一直在使用命令行版本的 DeepSeek Harness,桌面版会自动继承你原来的所有配置和设置,完全不需要重新操作。
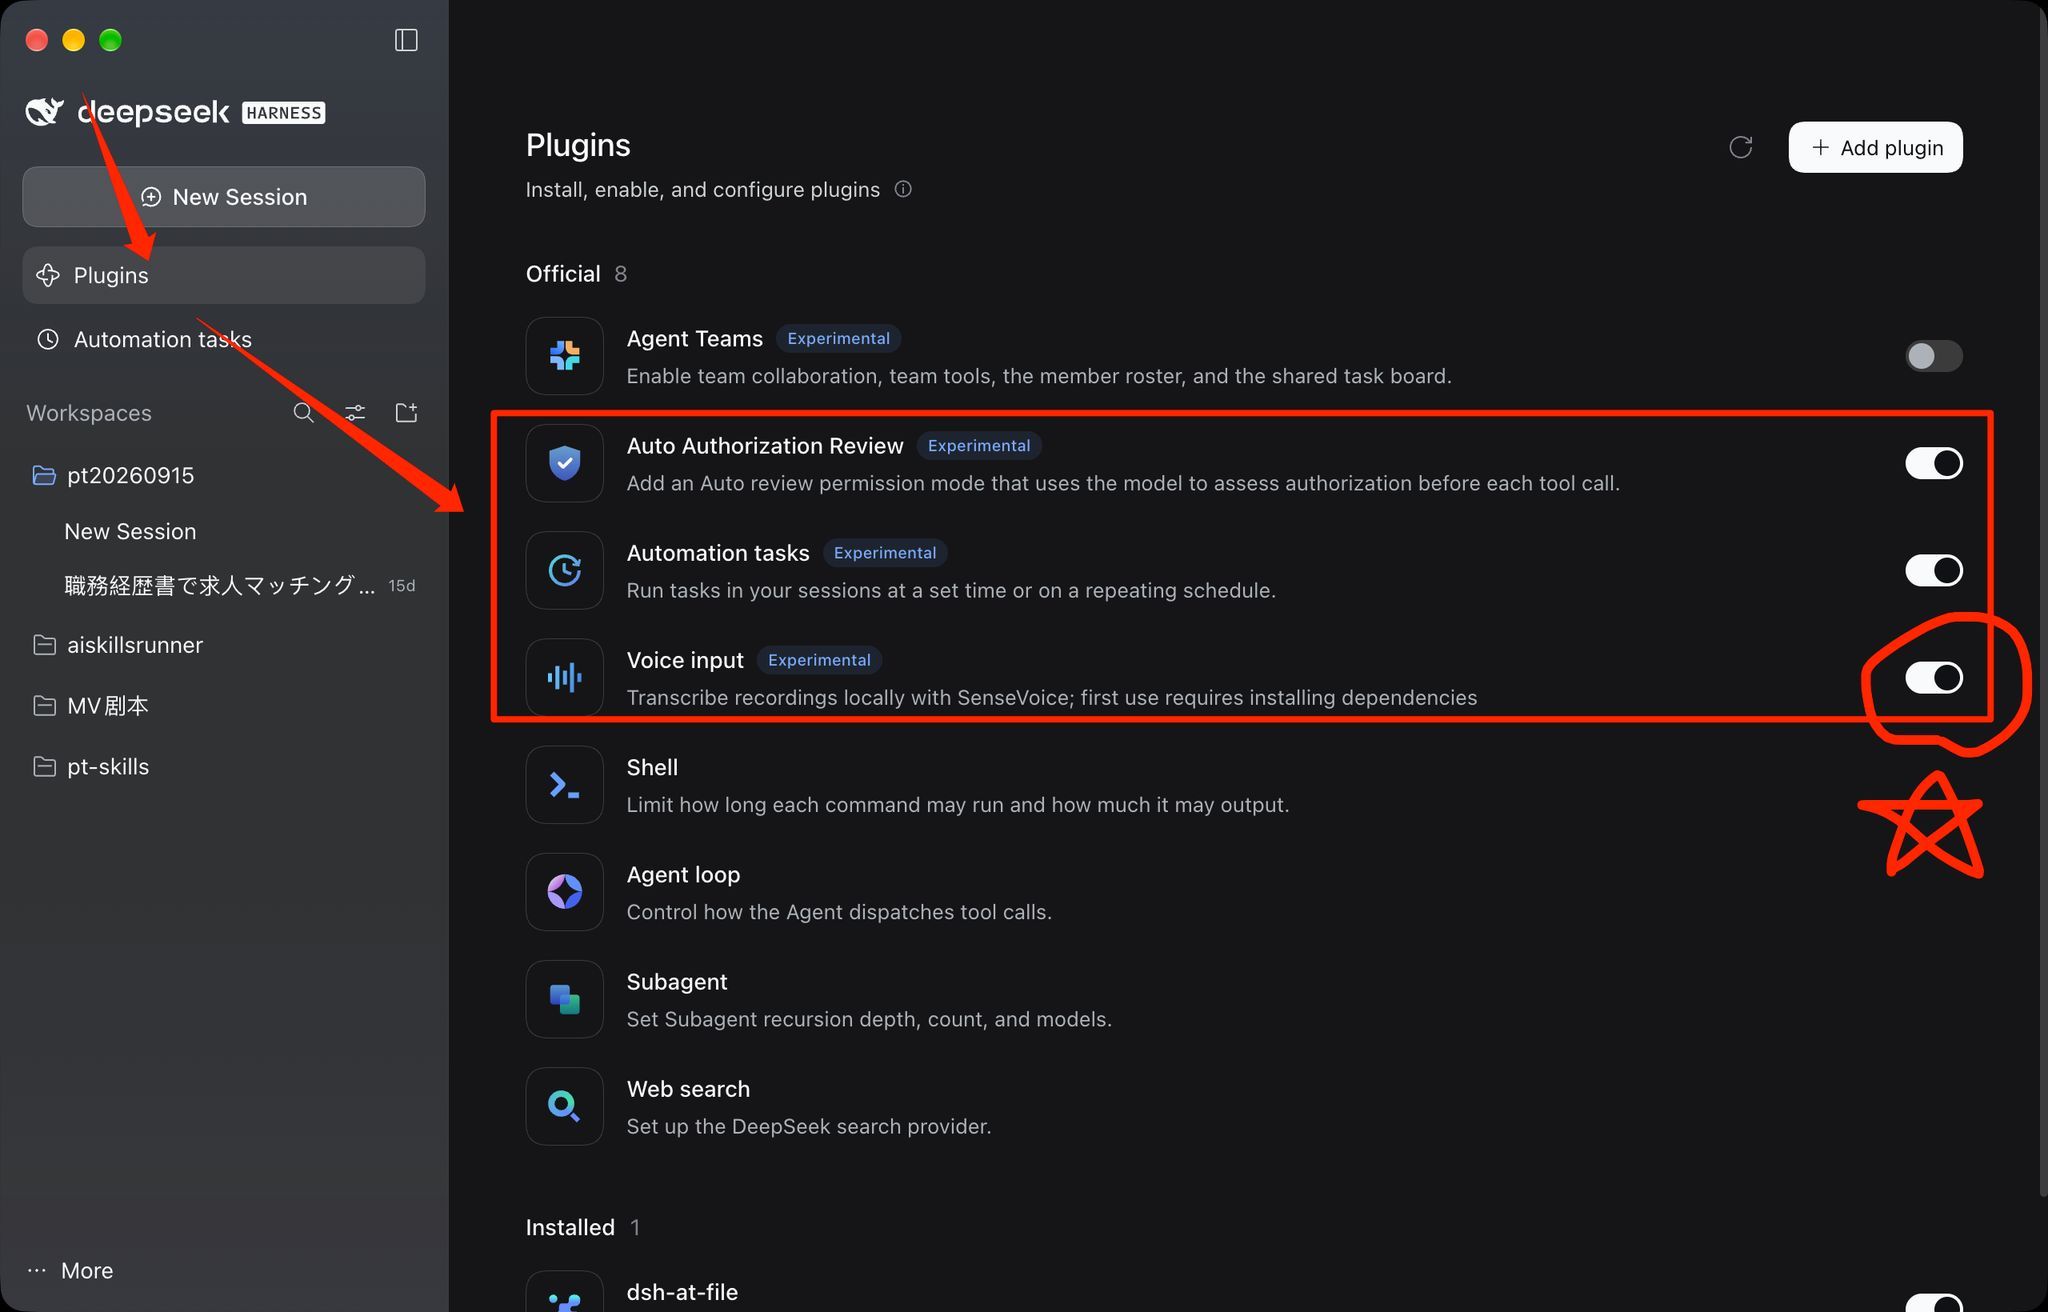
- 全新语音输入:官方贴心地推出了“语音输入”功能(插件),极大提升了日常的交互体验。
现在的 DeepSeek Harness,真的是越来越好用了!
公式サイト:https://www.deepseek.com/harness/
意外之喜:顺藤摸瓜挖到的“硬件宝藏”
在配置 DeepSeek Harness 的语音输入功能时,我注意到它底层使用了 SenseVoice 模型。出于好奇,我深挖了一下这个模型背后的硬件生态,没想到挖出了一款让人眼前一亮的硬件:「M5Stack AI-8850 LLM 驱动 M.2 扩展卡 8GB(AX8850)」。
这张扩展卡直接提供了一整套成熟的 AI 模型本地化部署方案,其中我最感兴趣的 AI 语音相关模型全部包含在内。
说到这里,顺便为大家科普一下目前主流且极具代表性的 5 个 AI 语音核心模型:
1. Whisper
- 开发方:OpenAI
- 核心功能:自动语音识别(ASR),即“语音转文字”。
- 特点:基于 Transformer 架构的端到端多语言语音识别模型。它拥有极强的抗噪能力与零样本学习能力,支持 99 种以上的语言识别与翻译,非常适合会议记录、视频字幕自动生成等场景。
2. MeloTTS
- 开发方:MIT 与 MyShell.ai 联合开发
- 核心功能:文本转语音(TTS),即“文字转语音”。
- 特点:轻量级、高质量的多语言语音合成库。它的核心优势在于对计算资源要求极低,即使在没有 GPU 的普通 CPU 上也能实现实时语音合成,并支持多种语言及口音,极其适合边缘计算设备与低成本部署。
3. SenseVoice
- 开发方:阿里通义实验室(FunAudioLLM 团队)
- 核心功能:多语言音频理解基础模型。
- 特点:除了高精度的语音识别(ASR)外,还能进行语音情感识别(SER)与音频事件检测(AED,如掌声、笑声、咳嗽等)。其 Small 版本采用非自回归架构,推理速度极快(处理 10 秒音频仅需约 70 毫秒,比 Whisper-Large 快 15 倍),非常适合实时交互场景。
4. CosyVoice2
- 开发方:阿里通义实验室
- 核心功能:高保真语音合成与声音克隆(TTS & Voice Cloning)。
- 特点:新一代语音生成大模型。支持超低延迟(150ms)的双向流式合成,以及零样本语音克隆(只需几秒样本音频即可精准复刻音色)。同时支持用自然语言指令直接控制生成声音的情感与韵律,生成自然度极高。
5. 3D-Speaker-MT
- 开发方:阿里通义实验室
- 核心功能:说话人识别与说话人日志(Speaker Verification & Diarization)。
- 特点:多模态说话人识别开源工具包。它不仅能精准验证“是谁在说话”,还能在多人对话场景中准确切分并标注出不同发言人的时间段。此外还支持语种识别与重叠语音检测,常用于智能会议纪要、法庭记录等场景。
总结
简而言之,从“听觉”到“表达”再到“辨识”,一个高级 AI 语音交互系统的全貌已经非常清晰:
- Whisper & SenseVoice 负责 “听懂”(高精度语音识别与情感理解);
- MeloTTS & CosyVoice2 负责 “表达”(轻量部署与高保真语音合成克隆);
- 3D-Speaker 负责 “辨人”(区分发言人与角色分离)。
软硬件结合的本地化 AI 语音生态正在快速成熟,未来无论是边缘设备还是桌面端交互,体验都将迈上一个全新的台阶!