
DeepSeek Harness公式Desktop版レビュー
DeepSeek Harness公式Desktop版のリリースに伴い、CLI版からの設定継承や新機能の音声入力プラグインについてレビューします。さらに音声入力のバックエンドに使われているSenseVoiceをきっかけに見つけた「M5Stack AI-8850」と、そこで活用される5つのAI音声モデル(Whisper、MeloTTS、CosyVoice2、3D-Speaker-MTなど)の機能と特徴を解説します。

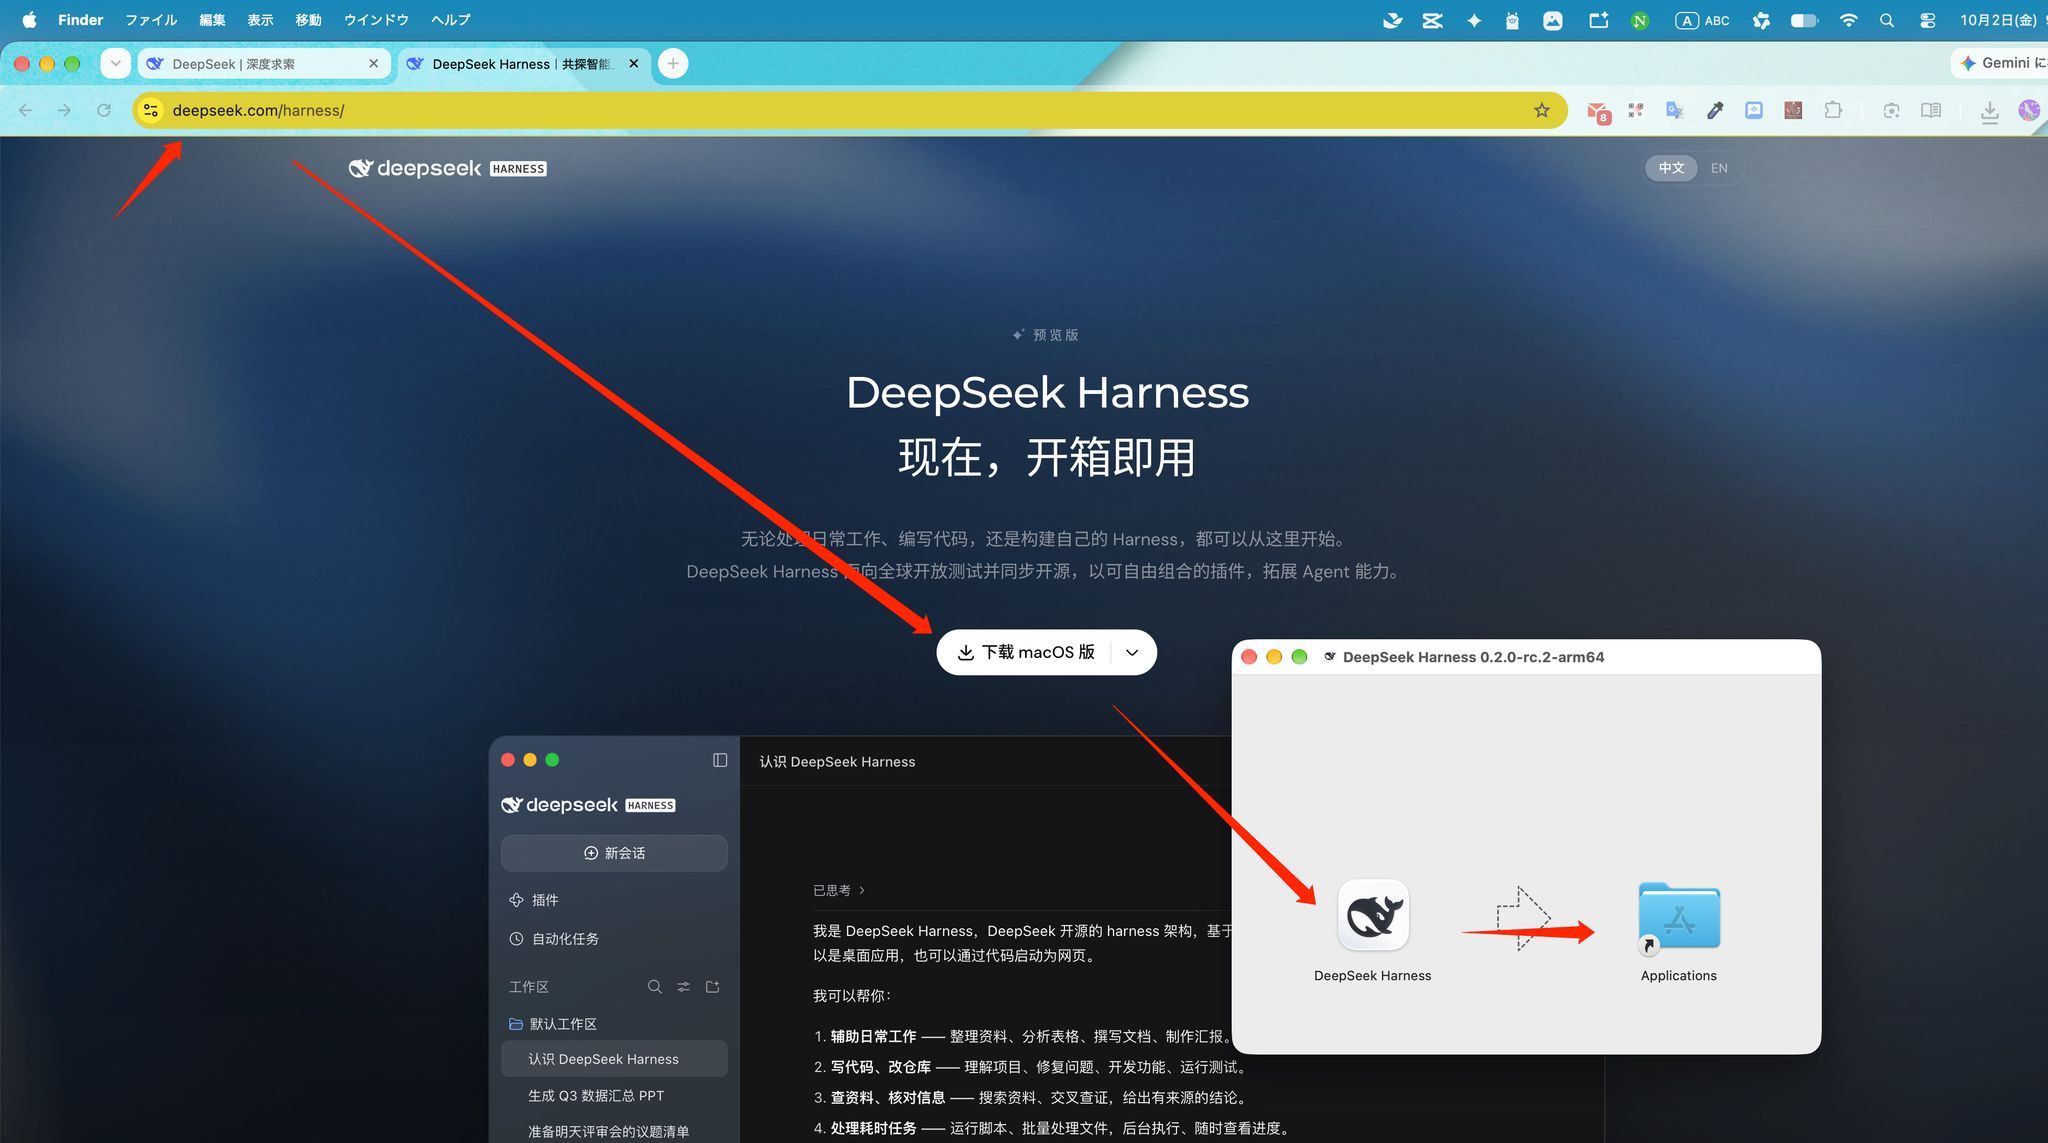
速報!DeepSeek Harness 官方 Desktop 版が正式にリリースされました!さっそく試してみたので、ファーストインプレッションをお届けします。
実際に触ってみて、特に大きなメリットだと感じたポイントは以下の2点です。
- 環境の引き継ぎが超スムーズ:これまで CLI(コマンドライン)版の DeepSeek Harness を使っていた場合、既存の全設定が自動的にデスクトップ版へ継承されます。再設定の手間は一切ありません。
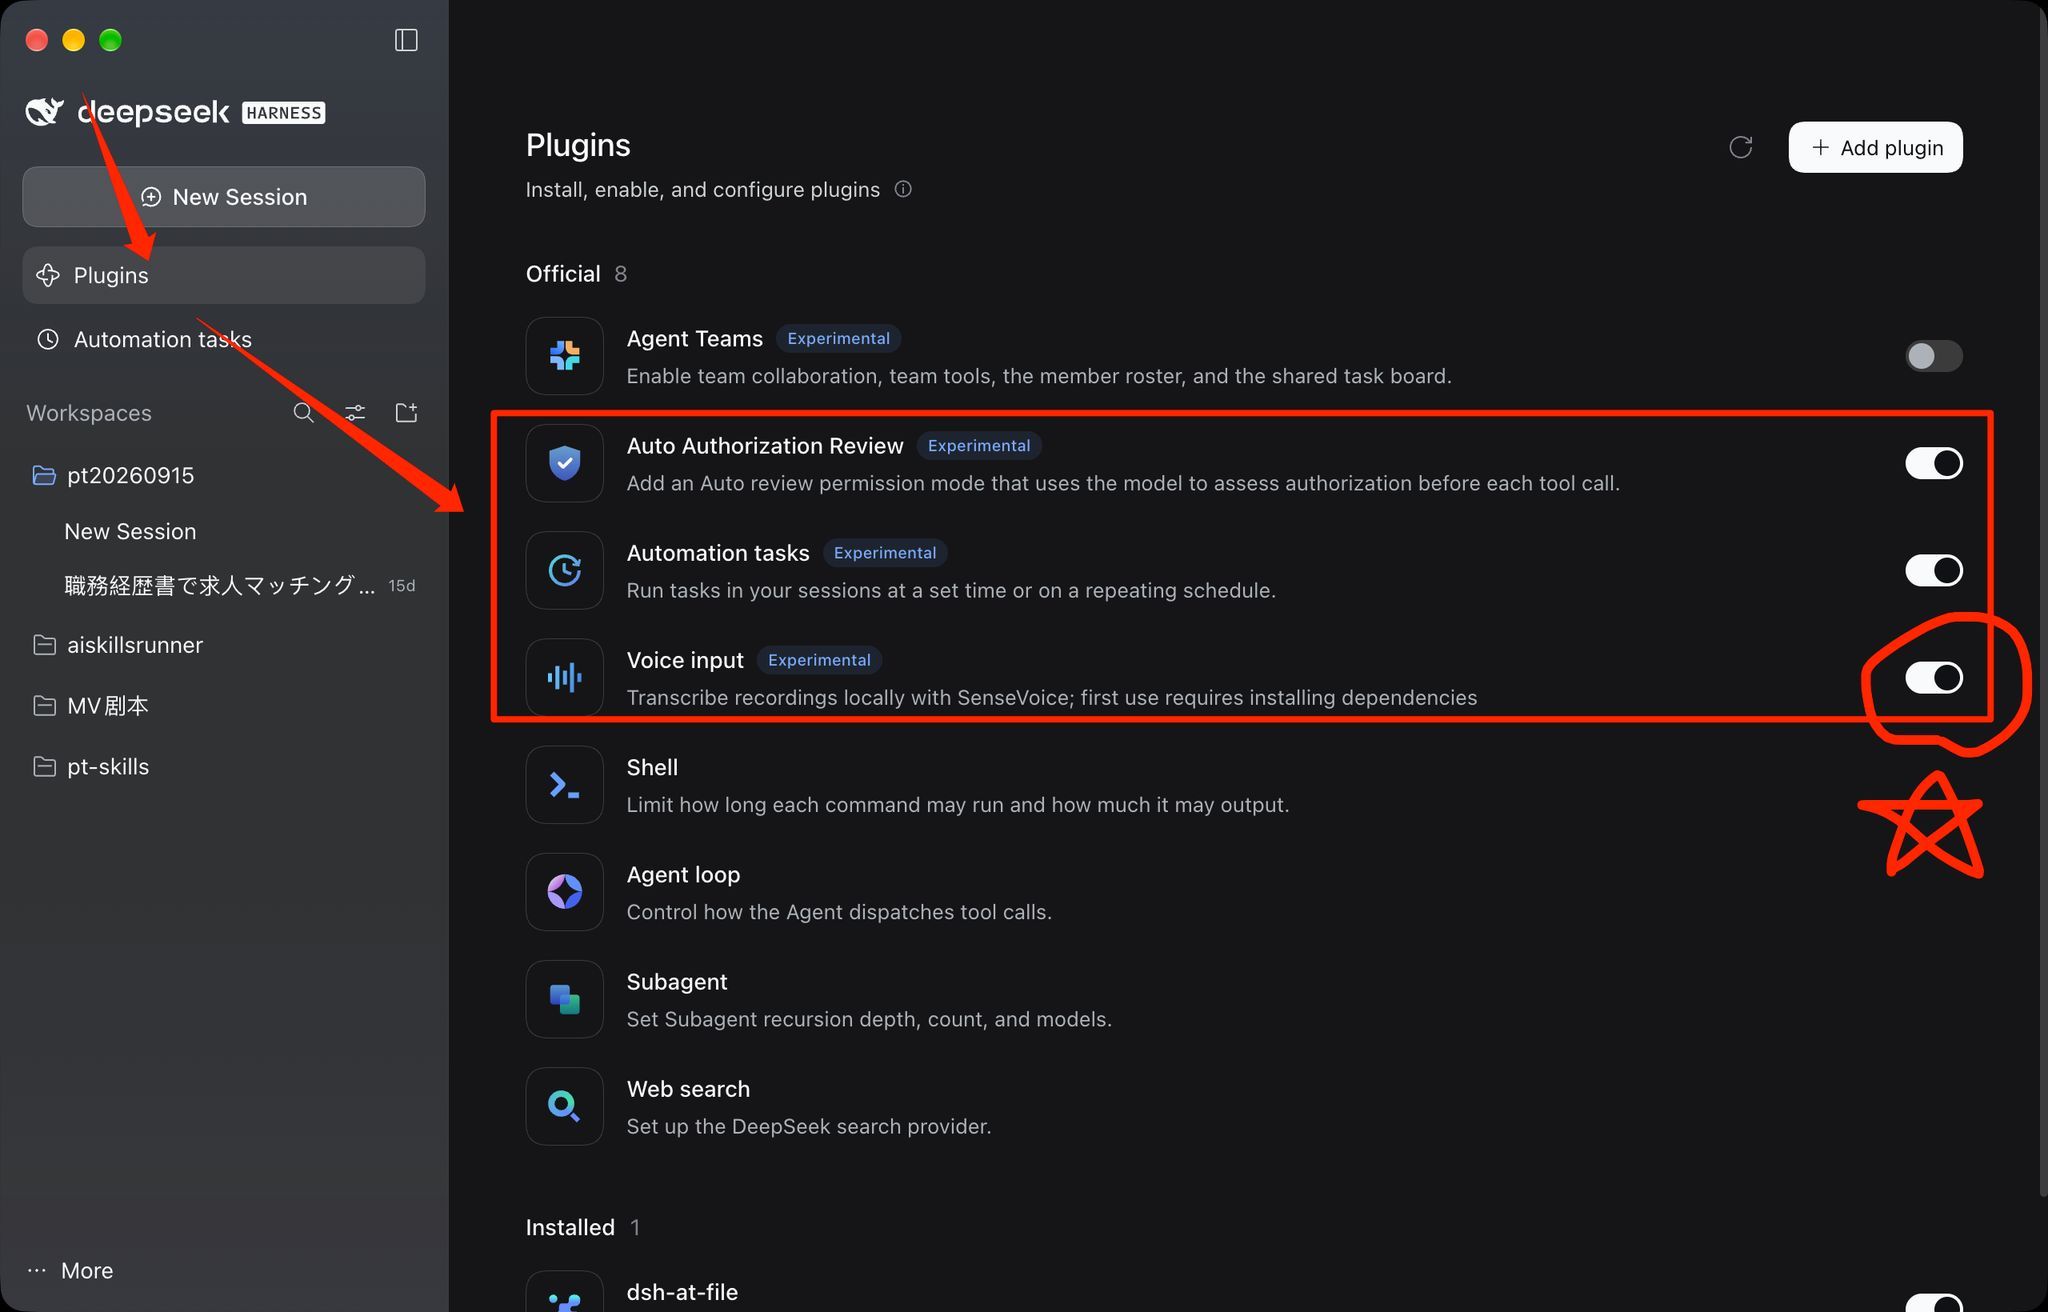
- 音声入力機能の搭載:待望の「音声入力」プラグインが公式に追加され、日々の操作感ややり取りの効率が格段に向上しました。
進化を続ける DeepSeek Harness、ますます手放せないツールになってきています!
公式サイト:https://www.deepseek.com/harness/
意外な発見:音声入力の設定から見つけた「ハードウェアの掘り出し物」
DeepSeek Harness の音声入力機能をセットアップしている際、バックエンドで SenseVoice というモデルが使われていることに気づきました。気になってその周辺のハードウェア環境を深掘りしてみたところ、非常に魅力的なプロダクトにたどり着きました。
それが、「M5Stack AI-8850 LLMアクセラレーション M.2キット 8GB(AX8850)」 です。
このキットはオンデバイスで動作するAIモデル環境をワンストップで提供しており、特に個人的に関心の高いAI音声関連モデルもフルサポートされています。
せっかくなので、ここで採用されている代表的な 5 つの AI 音声モデルについて簡単に解説します。
1. Whisper
- 開発:OpenAI
- 核心機能:自動音声認識(ASR/文字起こし)
- 特徴:Transformer 構文をベースとした多言語対応の端対端(End-to-End)音声認識モデル。高いノイズ耐性とゼロショット学習能力を持ち、99 以上の言語に対応。議事録作成や動画字幕の自動生成などに最適です。
2. MeloTTS
- 開発:MIT(マサチューセッツ工科大学)& MyShell.ai
- 核心機能:音声合成(TTS/テキスト読み上げ)
- 特徴:軽量かつ高品質な多言語音声合成ライブラリ。最大の特徴は計算リソースの負荷が極めて低い点で、GPU のない通常の CPU 環境でもリアルタイム音声合成が可能です。エッジデバイスや低コストでの運用に適しています。
3. SenseVoice
- 開発:Alibaba 通義ラボ(FunAudioLLM チーム)
- 核心機能:多言語音声理解基礎モデル
- 特徴:高精度な音声認識(ASR)に加え、感情認識(SER)や環境音検知(AED:拍手、笑い声、咳など)にも対応。Small バージョンは非自責型アーキテクチャを採用しており、10 秒の音声を約 70 ミリ秒(Whisper-Large の約 15 倍のスピード)で処理できるため、リアルタイム対話に最適です。
4. CosyVoice2
- 開発:Alibaba 通義ラボ
- 核心機能:高音質音声合成&ボイスコーニング(TTS & Voice Cloning)
- 特徴:次世代の音声生成大規模モデル。150ms という超低遅延な双方向ストリーミング合成と、わずか数秒のサンプル音声から声質を再現するゼロショット・ボイスクローニングに対応。自然言語の指示で感情や抑揚をコントロールでき、人間と見分けがつかないレベルの自然な音声を生成します。
5. 3D-Speaker-MT
- 開発:Alibaba 通義ラボ
- 核心機能:話者識別&話者分離(Speaker Verification & Diarization)
- 特徴:マルチモーダル対応の話者識別オープンソースツールキット。「誰が話しているか」の特定だけでなく、複数人の会話から発言者ごとにタイムラインを正確に切り分けて記録できます。重ね合わせ音声の検知や唇の動き(視覚情報)を組み合わせた認識にも対応し、スマート会議録や裁判記録などに活用されています。
まとめ
高度な AI 音声システムを構築するためのパーツは、以下のように役割が綺麗に整理されています。
- Whisper & SenseVoice = 「聞き取る」(高精度な文字起こしと感情・文脈の理解)
- MeloTTS & CosyVoice2 = 「話す」(軽量運用から高精度の音声合成・声質再現まで)
- 3D-Speaker = 「見分ける」(誰の発言かを正確に識別・分離)
ソフトとハードの融合によるローカル AI 音声エコシステムは急速に成熟しており、今後はデスク環境だけでなくエッジデバイスでの体験も大きく変わっていきそうです!