
用一套「App + Server」,把长语音自动变成多语言博客
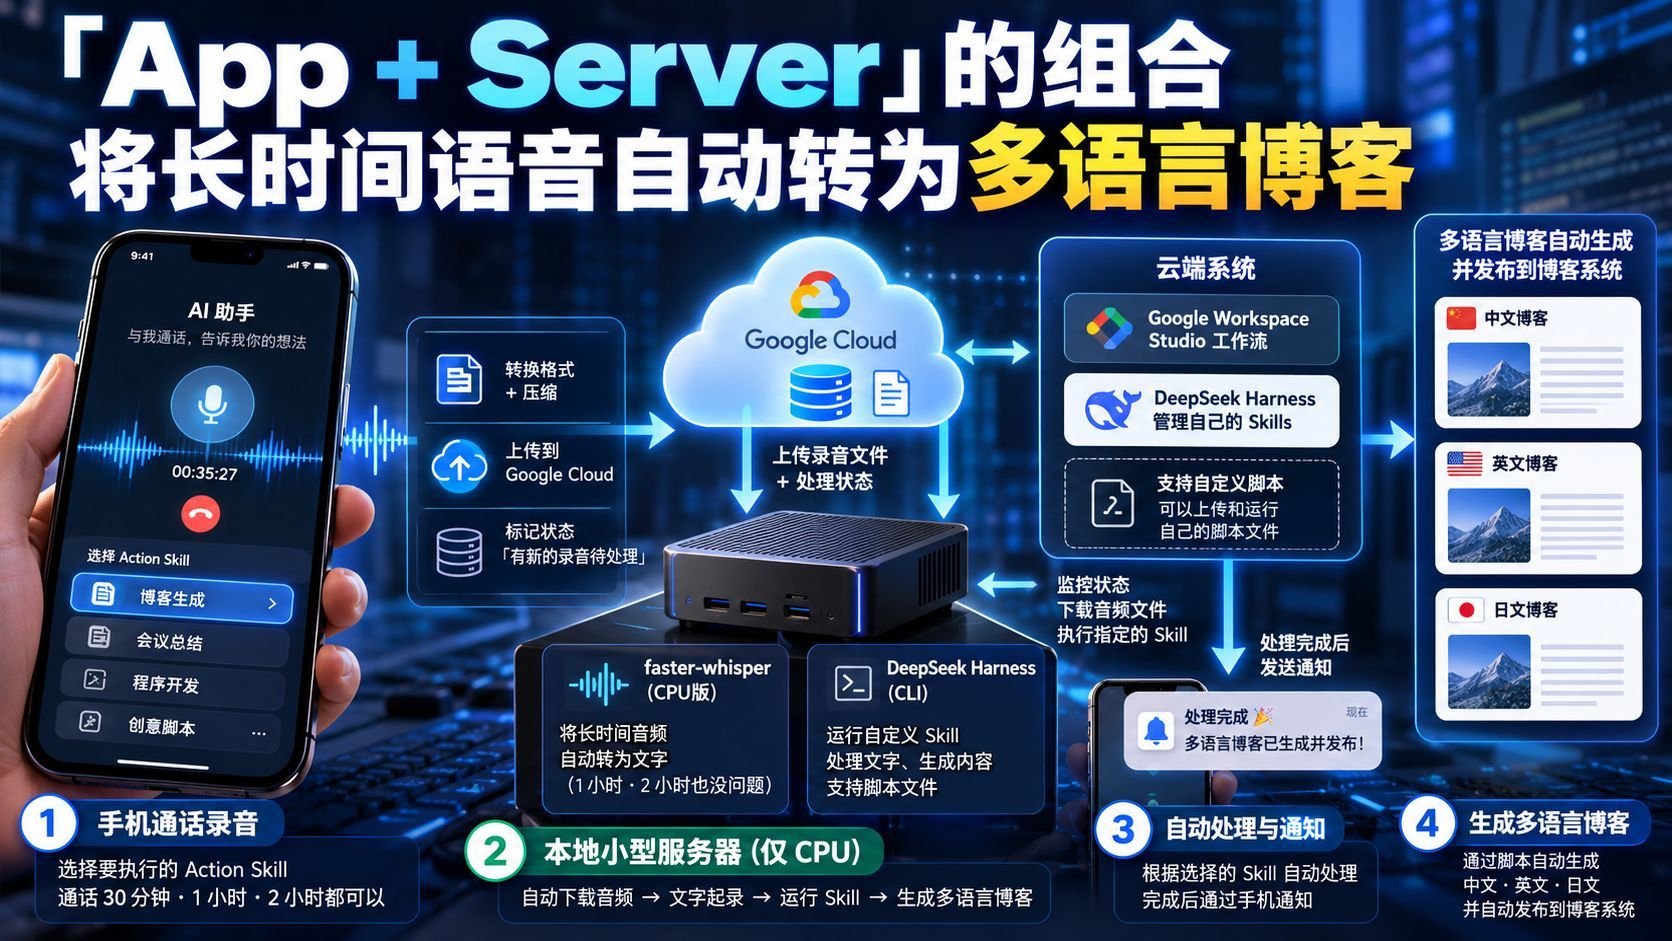
介绍我 9 月做的一套 App 加服务器语音处理系统。长时间的通话录音被压缩上传到谷歌云,再由一台只有 CPU、没有 GPU 的电脑轮询获取,用 faster-whisper 完成长音频转写,并通过 CLI 启动 DeepSeek Harness 运行 skill。云端系统支持上传自己的 skills 和脚本文件,处理完成后通过手机通知;脚本还能把内容转成三种语言并自动发布到博客。它在核心功能上接近 MUSE 和 Dota,但长语音转写只用 CPU、成本很低。下一步计划加入自动判断引擎,让系统自行决定执行哪些 Action Skills 以及执行顺序。

用一套「App + Server」,把长语音自动变成多语言博客
开场:9 月做出来的一个东西
哈喽,大家好呀。我偶尔会录一些科技相关的视频。9 月份,我做出了一个 App 加一组 Server 的程序,这里跟大家分享一下。
这个 App 没有复杂的功能,非常 simple,只有一个功能:把你的语音转换为你想要的 action(动作)。
手机端:打电话、说话、上传
具体来说,它就是一个长时间通话的 App。我打电话,并指定打给哪一个「处理部门」——这种部门可以有很多。比如打给它,然后我就开始说:说半个小时、一个小时、两个小时都可以。说完之后,我确认上传,然后就开始处理。
这个 App 做的事情,就是把你电话里的声音转换成其他格式并压缩,然后上传到我的谷歌云上(比如说那个存储,就是谷歌云),把我的声音文件就传上去了。同时在云端留了一个状态:有一个录音还没处理。
本地后台:一台只有 CPU 的小电脑
然后,我在我那台只有 CPU 的小电脑上做了一个后台。我这台机器没有 GPU,只有 CPU。这台电脑一直监视那个云:当云端有一个状态被触发的时候,这台 CPU 机器就去获取这个状态;同时这里还有一个语音文件,这台电脑就自己把那语音文件下载下来,让它在这边处理。
它先是去……我在我这个小电脑里开发了两个工具:
- 一个是自动地把语音转成文字,用的是 faster-whisper 的 CPU 版本。它能够把长文本转好,比如说一个小时、两个小时都没问题。
- 转完以后,我又开发了一个工具,把 DeepSeek Harness 重新封装,让它变成一个 CLI 命令。
云端系统:可以登录自己的 skills
然后我这边……这边这个画面,是我放在云上的一个系统。我这里可以去登录我指定的 skills。现在有两种状态:一个是你可以登录 Google Workspace Studio 的工作流;另一个是你可以使用 DeepSeek Harness,自己上传你的 skills。
而我觉得挺厉害的一点是:它能够往里面自己传你的脚本文件。很多这种服务其实是不支持脚本文件的,而我可以去支持脚本文件。
完整链路:从手机选 skill 到通知
当你传上去之后——我不是文字转换处理完了吗?处理完之后,我刚开始是在手机上选:我用哪个去处理。我选了一个,我不是选的……可以那个 DSH Blog 吗?这个后台不是有个 DSH Blog 吗?
我可以登录我自己的这个 skills 应用,然后发现要用这个 skill 处理,那我本地电脑就看我本机里有没有这个 skill:如果没有,我就去云上把这个 skill 下载、安装到我这里。然后我通过 CLI——我做了个 CLI 工具——通过 CLI 在后台自动去启动 DSH harness,把这个 skill 跑起来。
跑完以后,处理完事之后,给我的手机发一个通知,比如说长这样:这个通知,那个处理完了。
最妙的一步:脚本转三语 + 自动上传博客
这一套工具,有趣的是:这个 skill 里面可以写脚本,可以写 script,对吧。我这里加了一个脚本,干什么呢?我通过一个脚本程序,把这个语音说的这些内容去转换成三种语言,并且通过这个脚本上传到我的博客系统当中。大概是做了这么一个东西。
和 MUSE / Dota 的相似之处
其实我也不是说在这个节点上去讲那个流量啊,就是说:懂行的人一下就看出来,这个和前两天 Facebook 发布的 MUSE,或者 OpenAI 发布的 Dota,是不是挺像?其实核心上是能实现一样功能的。
而且我这个主要是打长语音,你录个一个小时、两个小时都没有问题。而且就是说,最费流量的语言转文字这一块,是由只有 CPU 的电脑来做的,也不费钱。所以说我做出了这一个和 MUSE、OpenAI 的 Dota 算是一样的功能。
关于「voice to action」的判断
其实感觉也是巧了,或者自己押题押对了。在几个月前我就一直强调:接下来会有一个叫做 voice to action 的大潮流到来。就是说,大家只是说一些东西,剩下的话通过我刚才介绍的这种模式,AI 自动去捕捉你的意图,然后执行一种 action,把这个 action 执行出来,尽可能贴近你真实生活里的一些事——这会成为一个潮流。
所以我也是同一件事情做的,感觉也像押对了题,挺开心的。
而且像刚才介绍的,代码我就不给大家提供了。因为其实知道原理之后,会 vibecoding 的话,按照这个思路,自己也很轻松地能搓出来这套系统。
下一步:自动判断该执行哪个 Action Skill
接下来我想的下一步是做什么呢?
刚才你看到那个手机,是我录音之前要先选:我要哪一个——我管它称为叫 Action Skills——哪个 Action Skill 去给我操作。
而我接下来,想在我这一套应用里再加一个最近挺火的 Jev,就是说一个自动判断的引擎,我想试试那个。然后的话,我再多去做几个 Action Skills。
是想做成什么样的呢?就是说:我说一大堆话,然后我这套程序自己判断,我的 action skills 哪个能去执行,哪个应该执行,按照什么顺序去执行;也就是每个环节执行的时候,会留哪些结果给下一个 action skill,让它去处理。这一套中间流程,我想十月份的时候尝试几个,看看能不能把这个做出来。
如果这个做了之后的话,以后就未来可期。就是说,我就随随便便地吐槽,吐个半小时槽,然后我自己能做的这些动作,比如说给博客写东西、做程序、做动画,反正我这套系统自动判断我应该按哪一种顺序去执行,然后用这些 action 去触发。这个做出来,又迈向了一个智能的阶段。
反正就努力,我也在这玩一玩,做一做新东西。如果有感兴趣的话,就是和我联系,我把代码也给大家写一下,到时候大家一起研究。
感谢大家!