
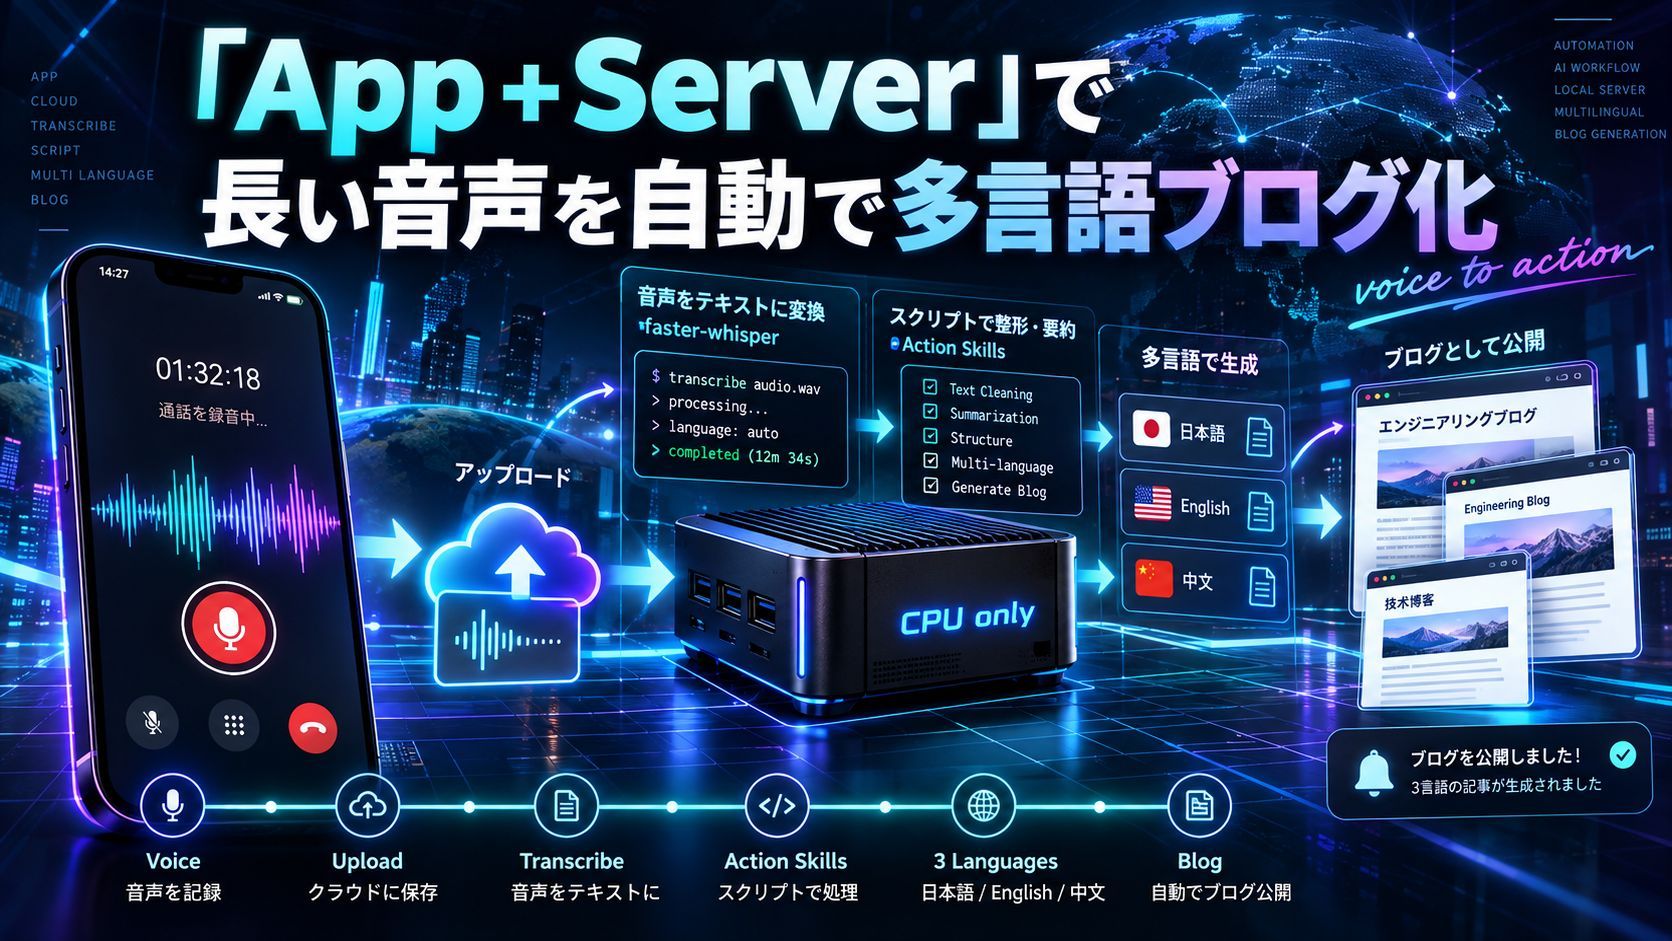
「App + Server」で長い音声を自動で多言語ブログ化する仕組み
Appとサーバーで作った音声処理システムの紹介。長時間の通話音声をGoogle Cloudに上げ、CPUのみのPCでfaster-whisperによる文字起こしとDeepSeek HarnessのCLI実行を行う。クラウドのskillsにはスクリプトも登録でき、処理後はスマホに通知。音声を3言語化してブログへ自動投稿し、MUSEやDotaに近い機能を低コストで実現。次はAction Skillsの自動判断と順序制御を目指す。

「App + Server」の組み合わせで、長い音声を自動的に多言語ブログ化する
はじめに:9月に作ったもの
ハロー、みなさん。私はときどきテクノロジー系の動画を録っています。9月に、1つのAppと1組のServerからなるプログラムを作ったので、ここで共有したいと思います。
このAppに複雑な機能はありません。とてもシンプルで、機能はただ1つ。あなたの音声を、あなたが望む action(アクション)に変換する、それだけです。
モバイル側:電話して、話して、アップロードする
具体的には、これは長時間通話のためのAppです。私は電話をかけ、どの「処理部門」にかけるかを指定します。この部門はいくつも用意できます。たとえばそちらにかけて、それから話し始めます。30分でも、1時間でも、2時間でも構いません。話し終えたらアップロードを確定して、そこから処理が始まります。
このAppがやっていることは、電話の音声を別のフォーマットに変換して圧縮し、それを私のGoogle Cloudにアップロードする(たとえばあのストレージ、つまりGoogle Cloudですね)、というものです。私の音声ファイルがそこにアップされます。同時に、クラウド側に1つのステータスを残します。「まだ処理されていない録音がある」という状態です。
ローカルのバックエンド:CPUしか積んでいない小さなPC
次に、私はCPUしか積んでいない小さなPCの上にバックエンドを作りました。このマシンにはGPUがなく、CPUだけです。このPCは常にクラウドを監視していて、クラウド側でステータスがトリガーされると、このCPUマシンがそのステータスを取得します。同時にここには音声ファイルもあるので、このPCが自分でその音声ファイルをダウンロードしてきて、こちら側で処理させます。
まず最初に……私はこの小さなPCの中に2つのツールを開発しました。
- 1つは、音声を自動でテキストに変換するツールで、faster-whisper のCPU版を使っています。長いテキストでも、たとえば1時間、2時間でも問題なく文字起こしできます。
- 文字起こしが終わったあと、もう1つツールを開発し、DeepSeek Harness をラップし直して、CLIコマンドにしました。
クラウド側のシステム:自分のskillsにログインできる
そしてこちらの……この画面は、私がクラウド上に置いているシステムです。ここでは、自分が指定したskillsにログインできます。今は2つの状態があります。1つは Google Workspace Studio のワークフローにログインする方法。もう1つは DeepSeek Harness を使い、自分のskillsをアップロードする方法です。
私がすごいと思っているのは、スクリプトファイルを自分で中に入れられるという点です。こうしたサービスの多くは、実はスクリプトファイルに対応していません。私はそれに対応させることができました。
全体の流れ:スマホでskillを選んでから通知まで
アップロードしたあと——そう、私は文字変換の処理が終わっているわけですよね。処理が終わったあと、最初はスマホ側で選んでいました。どれで処理するか、です。私は1つ選びました。選んだというか……あのDSH Blogでいいのかな?このバックエンドにDSH Blogがあるじゃないですか。
私は自分自身のこのskillsアプリにログインできて、それからこのskillで処理したいと分かると、ローカルのPCが「自分のマシンにこのskillがあるか」を確認します。なければ、クラウドからこのskillをダウンロードして、ここにインストールします。そして私はCLI経由で——CLIツールも作りました——CLIを通じてバックエンドで自動的にDSH harnessを起動し、このskillを走らせます。
走り終わって、処理が完了したあと、私のスマホに通知を送ります。たとえばこんな感じです。この通知で、「あれは処理し終わったよ」と分かります。
一番うまいところ:スクリプトで3言語化 + ブログへ自動アップロード
この一連のツールで面白いのは、このskillの中にスクリプトが書ける、scriptが書ける、ということですよね。私はここに1つスクリプトを追加しました。何をするかというと、スクリプトプログラムを通じて、この音声で話した内容を3つの言語に変換し、さらにこのスクリプトを通じて私のブログシステムへアップロードします。だいたい、そういうものを作りました。
MUSE / Dota との似ている点
実は私は、このタイミングでアクセス数の話をしたいわけではありません。つまり、分かる人ならすぐに気づくと思いますが、これは先日 Facebook が発表した MUSE、あるいは OpenAI が発表した Dota と、かなり似ているのではないでしょうか。核心的な部分では、同じ機能を実現できています。
しかも私のものは主に長い音声向けで、1時間でも2時間でも録って問題ありません。さらに、最も流量を食う音声の文字起こしの部分は、CPUしかないPCで行っているので、お金もかかりません。だからこそ、私はこれを作り、MUSE や OpenAI の Dota とほぼ同じ機能を実現したわけです。
「voice to action」という判断について
実は、偶然が重なったのか、それとも自分の読みが当たったのか。数か月前から私はずっと強調していました。これからは voice to action という大きな潮流が来る、と。つまり、みんなはただ何かを話すだけで、あとは今説明したような仕組みを通じて、AIが自動的に意図を捉え、ある種のactionを実行する。そのactionを実行し、できるだけ自分の実生活に近い事柄をこなす——これが潮流になる、ということです。
ですから私も同じことをやっていて、読みが当たったような気がして、とても嬉しいです。
それに、今紹介したように、コードは皆さんには提供しません。というのも、原理さえ分かってしまえば、vibecodingができる人なら、この考え方に沿って、自分でも簡単にこのシステムを組めるからです。
次のステップ:どのAction Skillを実行すべきか自動で判断する
次にやりたいことは何かというと、こうです。
さっきスマホで見えていたのは、私が録音する前に選ぶもの、つまり「どれにするか」でした。私はこれを Action Skills と呼んでいます。どのAction Skillに操作してもらうか、ということです。
そしてこれから、この一連のアプリに、最近話題の Jev を追加したいと思っています。つまり自動判断のエンジンで、それを試してみたいのです。そのうえで、Action Skillsをもっと何個か作ります。
どんなふうにしたいかというと、こうです。私がたくさん話すと、このプログラムが自分で判断し、私のaction skillsのどれを実行できるのか、どれを実行すべきなのか、どの順番で実行するのかを決めます。つまり、各段階を実行するときに、どの結果を次のaction skillに残して処理させるのか、ということを決めるわけです。この中間の流れを、10月にいくつか試して、作れるかどうか見てみたいと思っています。
これができたら、もう未来は明るいです。つまり、私は気ままに文句や雑談を30分ほど話すだけで、自分ができるこれらの動作、たとえばブログに何かを書く、プログラムを作る、アニメーションを作る、といったことを、このシステムが自動的に判断して、どの順番で実行すべきかを決め、それらのactionでトリガーする。これができあがると、また1つ賢い段階に進んだことになります。
とにかく努力して、私もここで遊びながら、新しいものを作っていきます。もし興味がある人がいれば、私に連絡してください。コードも皆さんのために書きますので、そのときにみんなで一緒に研究しましょう。
ありがとうございました!