

RAG、GraphRAG、LLM Wiki、オントロジー:4つの知識ベース技術の選び方
4つの技術は、4種類の問いに対応する
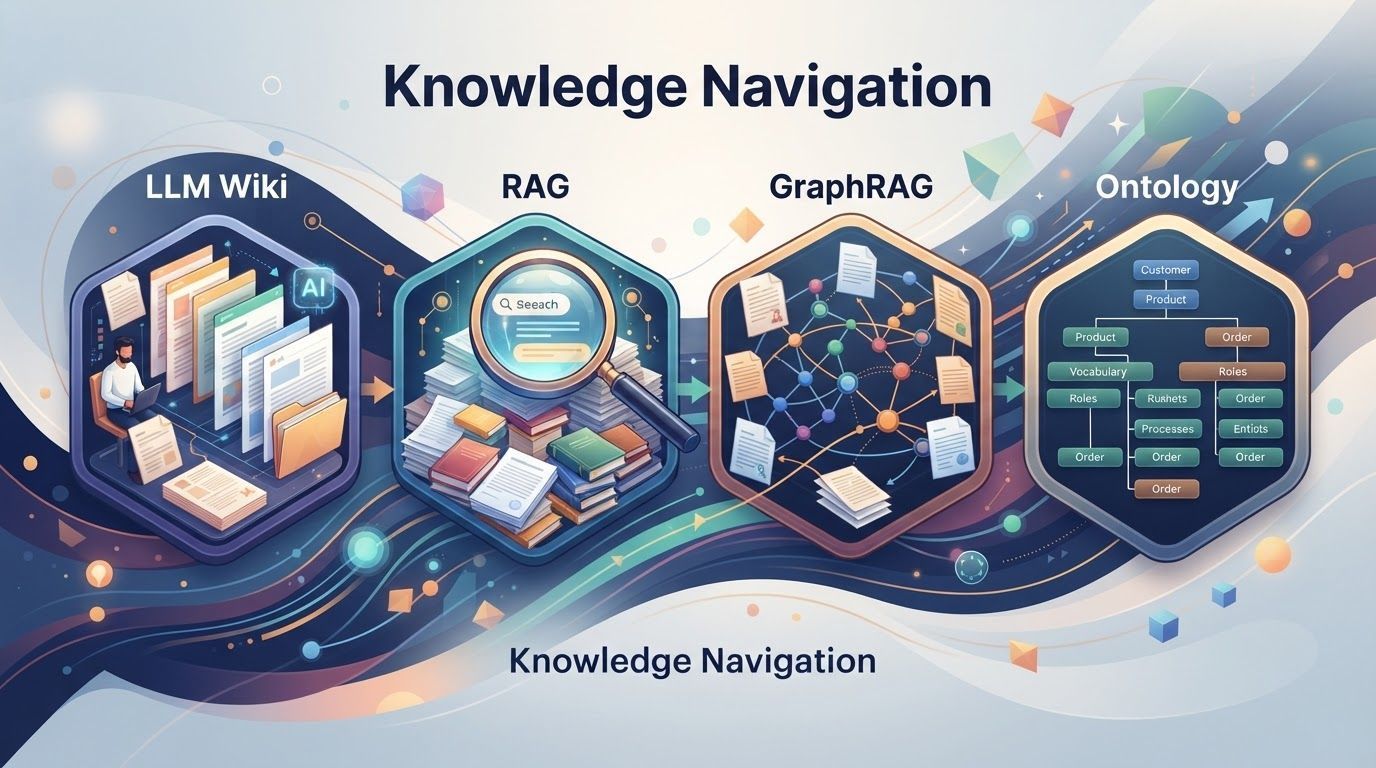
AI の知識ベースを作っていると、RAG、GraphRAG、LLM Wiki、オントロジーという4つの名前を並べて比較する場面がよくあります。どれも AI に資料を使わせる技術ですが、解いている問題は同じではありません。資料を保守しやすい知識ページに整理するもの、大量の文書から関連する断片を探すもの、散らばった実体と関係をつなぐもの、複数の業務システムに同じ語彙を持たせるもの——役割はそれぞれ違います。選定の鍵は、どれが新しいかではなく、自分のデータがどんな形をしていて、AI にどんな質問を答えさせたいかを先に決めることです。
4つの知識ベース技術の役割分担
| 技術 | 中心となる操作 | 向いている問い | 典型的な場面 |
|---|---|---|---|
| LLM Wiki | ルールに従って原材料を相互リンクした知識ページに整理する | 個人のメモやプロジェクト経験を継続的に蓄積したい | 個人の知識ベース、小規模チームの経験庫 |
| RAG | 文書を分割・ベクトル化し、質問時に関連する断片を検索して生成する | 答えが少数の文書の中にある | 社内規程のQA、製品ドキュメントのアシスタント |
| GraphRAG | 実体と関係を抽出してグラフを作り、関係をたどって検索する | 複数の文書にまたがる実体、依存、担当者をつなぎたい | 文書をまたぐ関係追跡、複雑な業務関連の分析 |
| Ontology | オブジェクト、属性、関係を定義し、各システムのデータを統一モデルにマッピングする | 複数システムで同じ業務概念の理解が揃っていない | 顧客・注文・商品の意味統一とルール検証 |
まずは大まかな対応を覚えておくとよいでしょう。個人の知識管理なら LLM Wiki、企業の文書QAなら RAG、文書をまたぐ関係なら GraphRAG、複数システムの業務語彙ならオントロジーです。4つは互いを置き換える代替版ではなく、異なる層を担う道具であり、実際のプロジェクトでは組み合わせて使うことが少なくありません。
個人の知識管理:LLM Wiki は散らばった資料をリンクされた知識ページにする
まず個人の場面から見ましょう。保存した記事、書いたメモ、プロジェクトで踏んだ落とし穴は、たいてい別々のフォルダに散らばっています。時間が経つと、あの経験がどこに書いたか分からなくなり、新しい AI との会話のたびに背景を説明し直すことになります。LLM Wiki が解こうとしているのは、まさにこの問題です。AI に一定のルールで資料を整理させ、継続的に保守できる知識ベースにする仕組みです。
- 原材料:集めた記事、文書、プロジェクトの記録を raw ディレクトリに置き、元の出典を残します。
- 整理ルール:AGENTS.md に、AI がどう分類し、どう関連づけ、重複や矛盾をどう扱うかを書きます。
- 知識ページ:AI がルールに従って原材料を Markdown のページにまとめ、ページ同士をリンクさせます。 4
知識ページは孤立した要約ではありません。あるメモが概念に触れていれば、AI はその箇所に関連ページへのリンクを張れます。検索するときは、目の前の1ページだけでなく、リンクをたどって関連する知識にも到達できます。資料が増えるほど、ページ同士の関係網が育っていきます。
LLM Wiki は何に向き、何に向かない? 個人の知識ベース、小規模チームの経験蓄積、内容を直接読んで直したい場面に向いています。すべて Markdown ファイルなので開いてすぐ編集でき、保守の負担が小さいのが利点です。強みは「整理と接続」であり、数千件の規程文書から高い再現率で検索することではありません。原文の段落を厳密に引用する必要があるなら、RAG と組み合わせます。ここで言う LLM Wiki は特定製品ではなく、一つの作り方です。
企業文書のQA:RAG は検索してから生成する
次は企業の場面です。社内には数千件の規程、マニュアル、製品ドキュメントがあり、社員は経費精算の基準やある技術仕様を知りたいとします。RAG(検索拡張生成)の発想は一言でいえば、「まず資料を探し、その資料に基づいて大規模言語モデルに答えさせる」です。 1
RAG の2つの段階
取り込み段階では、文書を解析・分割・ベクトル化してベクトルデータベースに保存します。質問段階では、質問もベクトル化し、最も関連する断片を検索して、質問と一緒に LLM に渡し、回答を生成します。
flowchart LR
    docs["Excel / Word / PDF"] --> parse["解析と分割"]
    parse --> embed["ベクトル化"]
    embed --> vdb[("ベクトルDB")]
    q["ユーザーの質問"] --> qembed["質問のベクトル化"]
    qembed --> search["類似度検索"]
    vdb --> search
    search --> context["関連する断片"]
    context --> llm["LLMが回答を生成"]
    q --> llm
たとえば社員が「出張旅費の精算基準は?」と聞くと、システムは就業規則や経費マニュアルから該当する規定を探し、その原文を LLM に渡して回答を組み立てます。引用元を一緒に返すこともできます。根拠がたどれるので、モデルが事実をでっち上げる余地も小さくなります。
通常の RAG の強みは、技術が成熟していて検索が速く、大量の文書を扱えることです。実装もしやすいため、社内アシスタントや製品ドキュメントのQAの多くはこの方式で作られています。
限界が見えるのは、問いが「ある文書に何が書いてあるか」ではなく、「複数の文書の情報をつなぐ」ものになったときです。たとえば、プロジェクトAが検索サービスを使っていて、その検索サービスをデータチームが保守しているとします。「プロジェクトAが使うサービスは誰が保守しているか」と聞くと、単純なテキスト類似度では2つの文書を別々に見つけても、それらを接続できないことがあります。そこで GraphRAG の出番です。
文書をまたぐ関係:GraphRAG は RAG にグラフの層を足す
GraphRAG と通常の RAG の最大の違いは、知識グラフという層が加わることです。まず文書から実体と関係を抽出し、それをグラフとして組織します。実体とは業務に現れる名詞のようなもので、プロジェクト、人、サービス、ベンダーなどです。関係はそれらのつながりで、誰がどのサービスを使い、誰が保守し、何が何に依存しているか、といったものです。実装によって方法は異なり、グラフをコミュニティに分けて要約するものもあります。共通するのは、実体と関係を抽出し、検索時にグラフ構造を利用する点です。 2
再びプロジェクトAの例です。1つ目の文書に「プロジェクトAは検索サービスを使う」、2つ目に「検索サービスはデータチームが保守する」と書かれているとします。通常の RAG は2つの文書を別々に探し、生成時に情報を組み合わせます。GraphRAG は前もって「プロジェクトA → 利用 → 検索サービス」「検索サービス → 保守 → データチーム」という2つの関係を抽出します。質問時にはプロジェクトAから出発し、関係をたどって検索サービス、さらにデータチームへと進めるので、答えに至る経路が生まれます。
実体の関係をたどって文書をまたぐ問いに答える
グラフは2つの文書の事実を1本の経路につなぎます。プロジェクトAは検索サービスを使い、検索サービスはデータチームが保守している。したがって、プロジェクトAが使うサービスはデータチームが保守していることになります。最終的な答えは、元の文書の根拠に戻って確認します。
flowchart LR
    a["プロジェクトA"] -->|"利用"| s["検索サービス"]
    s -->|"保守"| t["データチーム"]
    d1["文書1:プロジェクトAは検索サービスを使う"] -.-> a
    d2["文書2:検索サービスはデータチームが保守する"] -.-> s
注意したいのは、グラフが与えるのは関係の手がかりであり、最終的な答えではないという点です。生成時には元の文書の根拠に戻り、その関係がどの資料に基づくのかを示す必要があります。抽出を誤ると、その誤りが経路に沿って伝播します。
GraphRAG のコストは明確です。実体抽出、関係識別、グラフ構築の追加作業が必要で、データ更新のたびにグラフを保守しなければなりません。実体や関係の抽出を誤れば、検索の経路全体に影響します。単純な文書QAに最初から持ち出す必要はありません。向いているのは、文書をまたぐ検索、多層の関係追跡、複雑な業務関連の分析です。
業務語彙の統一:オントロジーは複数システムに同じ言葉を持たせる
LLM Wiki は主に知識の整理を、GraphRAG は主に文書間の関係検索を解決します。企業にはさらに複雑な要件があります。異なる業務システムの AI に、同じ業務関係を理解させることです。これがオントロジー(ontology)の役割です。 3
オントロジーの中心にあるのは、オブジェクト、属性、関係の3つです。オブジェクトは業務の実体で、顧客、注文、商品などです。属性はオブジェクトを説明するもので、顧客名、年齢、注文金額、注文日時などがあります。関係はオブジェクト同士のつながりで、顧客が注文する、注文が商品を含む、といったものです。これらを定義し、各業務システムのデータを対応づけると、統一された業務モデルができます。
顧客・注文・商品の簡略化したオントロジー
| オブジェクト | 属性 | 他のオブジェクトとの関係 |
|---|---|---|
| 顧客 | 顧客名、年齢、統一ID | 注文する → 注文 |
| 注文 | 注文金額、注文日時、状態 | 属する → 顧客;含む → 商品 |
| 商品 | 商品名、仕様、価格 | 含まれる → 注文 |
システムをまたぐ例を挙げます。顧客システム、注文システム、商品システムがあり、同じ顧客がシステムごとに違う名前やIDを持つとします。顧客が何を買ったかは注文システムが持ち、商品の詳細は商品システムが持っていますが、これらのデータがそのまま対応するとは限りません。オントロジーは散らばった業務概念を統一し、各システムのデータを同じオブジェクトと関係に対応づけます。すると AI は「ある顧客が買った商品は何か」と聞かれたとき、各システムのフィールドの意味を推測せずに、統一された業務定義で顧客、注文、商品をつなげられます。
オントロジーは検索のためだけのものではありません。モデルに業務ルールを定義し、既存データとルールに基づいて推論や検証を行えます。たとえば、注文状態の遷移が妥当か、顧客ランクが特定の優待条件を満たすか、といったことです。単にデータ同士を関連づけるだけでなく、同じ業務に対して異なるシステムが同じ理解を持つことに意味があります。
Agent がオントロジーを使う方法は、通常 function call(ツール呼び出し)です。「オントロジーを検索する」「注文を読む」「顧客を調べる」をそれぞれツールとして包み、名前、引数、用途を明確にして Agent に渡します。ユーザーが質問すると、Agent は質問とツールの説明からどれを呼ぶか判断します。配送状況だけなら配送照会ツール、顧客・注文・商品の複雑な関係ならオントロジー検索ツールです。結果が返ったら、それを LLM が文章にまとめます。
役割分担は明確です。オントロジーが業務の概念と関係を定義し、Agent がユーザーの意図を理解してツールを選び、検索処理を完了します。オントロジーがなければ、Agent は複数システムの前でフィールドを推測するしかありません。Agent がなければ、オントロジーを自然言語から直接使うのは難しくなります。
2種類の「グラフ」は別物です
ここに混同しやすい点があります。LLM Wiki も GraphRAG も「グラフ」を作りますが、同じものではありません。
2種類の「グラフ」の違い
| 観点 | LLM Wiki | GraphRAG |
|---|---|---|
| グラフの由来 | AI が資料を整理するときに知識ページ間のリンクを張る | 元の文書から実体と関係を抽出する |
| ノード | 1つの知識ページ、または概念 | プロジェクト、人、サービスなどの実体 |
| エッジ | ページ間の参照と関連 | 利用、保守、依存など、実体間の具体的な関係 |
| 主な用途 | 個人の知識を整理・閲覧し、リンクをたどって読み広げる | 文書をまたぐ関係検索と経路追跡 |
| 更新方法 | Markdown を編集し、AI に再整理させる | 実体と関係を抽出し直し、グラフを保守する |
一文でまとめれば、LLM Wiki は知識をつなぐもの、GraphRAG は実体と関係を組織するものです。前者はメモと概念を結んだ地図、後者は検索に使える業務関係図に近いといえます。両者は併存できますが、互いを置き換えることはできません。
選び方:データを見てから、問いを見る
4つを並べたうえで、選定は問いから逆算すると考えやすくなります。まず「AI に何を答えさせたいか」、次に「データがどこにあり、どんな形か」を問い、最後に必要な技術を決めます。
問いから技術を選ぶ
| あなたの問い | まず検討する技術 | 理由 |
|---|---|---|
| AI に個人のメモを整理させ、プロジェクト経験を蓄積したい | LLM Wiki | 継続的に保守でき、読んで直せる知識ページが必要 |
| 社内文書が多く、社員が正確な答えをすぐに知りたい | RAG | 答えが少数の文書断片にあり、検索技術も成熟して低コスト |
| 複数の文書をまたいで実体、依存、担当者を追いたい | GraphRAG | 実体の関係に沿って散らばった事実をつなぐ必要がある |
| 複数の業務システムで同じ業務概念の理解が揃っていない | Ontology | オブジェクト、属性、関係を統一し、ルール検証も行いたい |
| 文書検索も、システム間の関連や複雑な関係分析も必要 | 組み合わせ | 文書検索、関係追跡、業務語彙を1つで全部はカバーできない |
よくある組み合わせ構成
データベースはリアルタイムの業務データを保持し、RAG は規程や製品文書を検索し、GraphRAG は複雑な関係を扱い、オントロジーは中核の業務語彙を統一します。Agent はユーザーの問いに応じて異なる能力を呼び出し、最後に LLM が回答をまとめます。
flowchart TB
    user["ユーザーの質問"] --> agent["Agent"]
    db[("業務データベース")] --> agent
    rag["RAG:規程・製品文書"] --> agent
    grag["GraphRAG:文書間の関係"] --> agent
    onto["Ontology:業務語彙の統一"] --> agent
    agent --> llm["LLMが回答を構成"]
知識ベースの選定で重要なのは、どれが新しくて話題かではなく、次の2点を先に明らかにすることです。自分のデータがどんな形か、AI に何を答えさせたいか。個人のメモなら LLM Wiki、大量の非構造文書なら RAG、文書間に明確な実体関係があるなら GraphRAG、複数システムと語彙統一の要件があるならオントロジーです。順序を逆にすると、新しい技術を使うために使い道のないグラフを作ってしまいがちです。
GraphRAG やオントロジーを使わないほうがよいのはどんなとき? 数件の文書から規定を1つ見つけるだけなら、通常の RAG が最も費用対効果に優れます。GraphRAG は抽出、グラフ構築、保守の追加作業が必要で、抽出ミスは経路に沿って伝播します。オントロジーは業務側が一緒に概念を定義し、写像を継続的に管理する必要があり、前者2つより投入が大きくなります。まず簡単な方法で、本当に関係推論が必要かを確かめてから、アップグレードを検討しましょう。