VibeCoding Japan 文章归档
Article archive

文章归档

支持对已公开的 133 篇文章进行关键词模糊搜索、分类与标签筛选。

# AI動向 · 共 64 篇文章

清除条件
杂谈 7 分钟

商业模型为何在 1990 年代成为关键词:从戴尔、PlayStation 到丰田与软银

商业模型这个词是怎么流行起来的?本文从日本经济媒体的最早用例讲起:1995 年前后《日本经济新闻》围绕戴尔的报道、1997 年关于 PlayStation 否定任天堂商业模型的专题,以及半导体产业被美台追击的语境。之后回到丰田,梳理 Just-in-Time 与「自働化」两根支柱、推式生产的问题与拉式方式的由来,以及福特量产方式为何在日本过剩。最后介绍孙正义的「时光机经营」,并说明看商业模型没有唯一正确的切口。
行业新闻 7 分钟

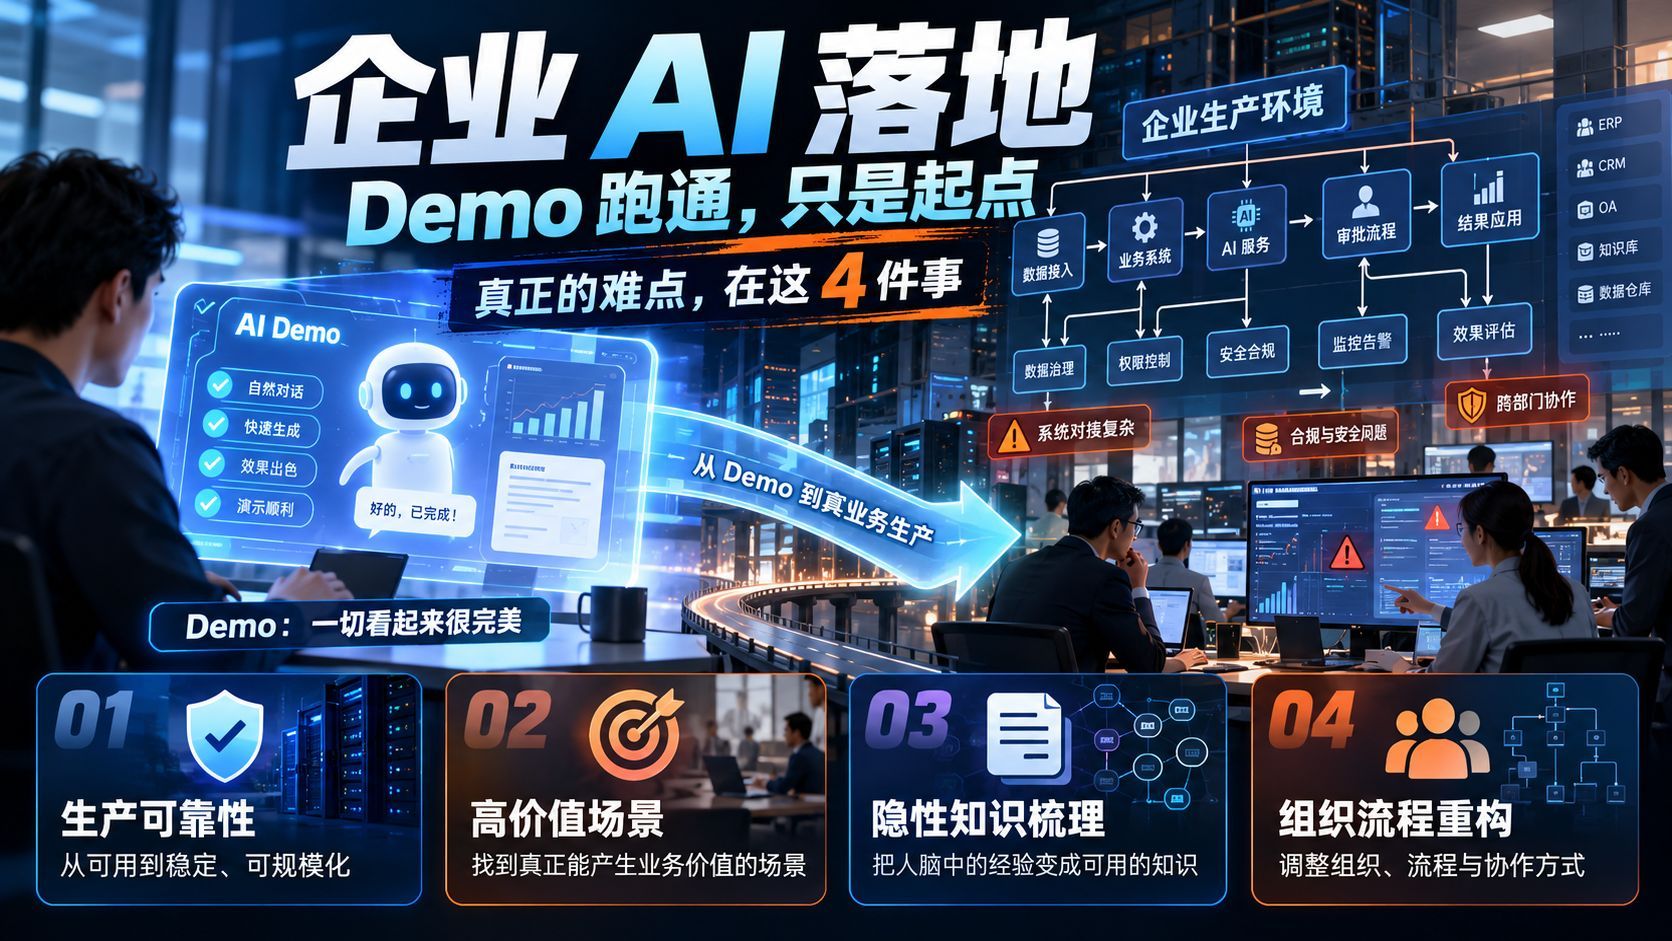
企业 AI 落地:Demo 跑通只是起点,真正的难点在这四件事

借腾讯研究院的 FDE 报告,梳理企业 AI 落地中反复出现的四个问题:把 Demo 跑通当成产品能上线、能做 AI 应用却没选对高价值场景、员工会做的事 AI 未必做得更好、个人提效不等于组织提效。文章结合智能客服与 ERP 的案例,说明 Demo 与生产之间的落差、隐性知识转化为上下文的必要性,并给出三点改进:不要用 Demo 速度推算落地周期、围绕高价值场景组织业务与技术共同负责的小团队、涉及流程职责与考核时高层必须亲自推动。

AI 动向 6 分钟

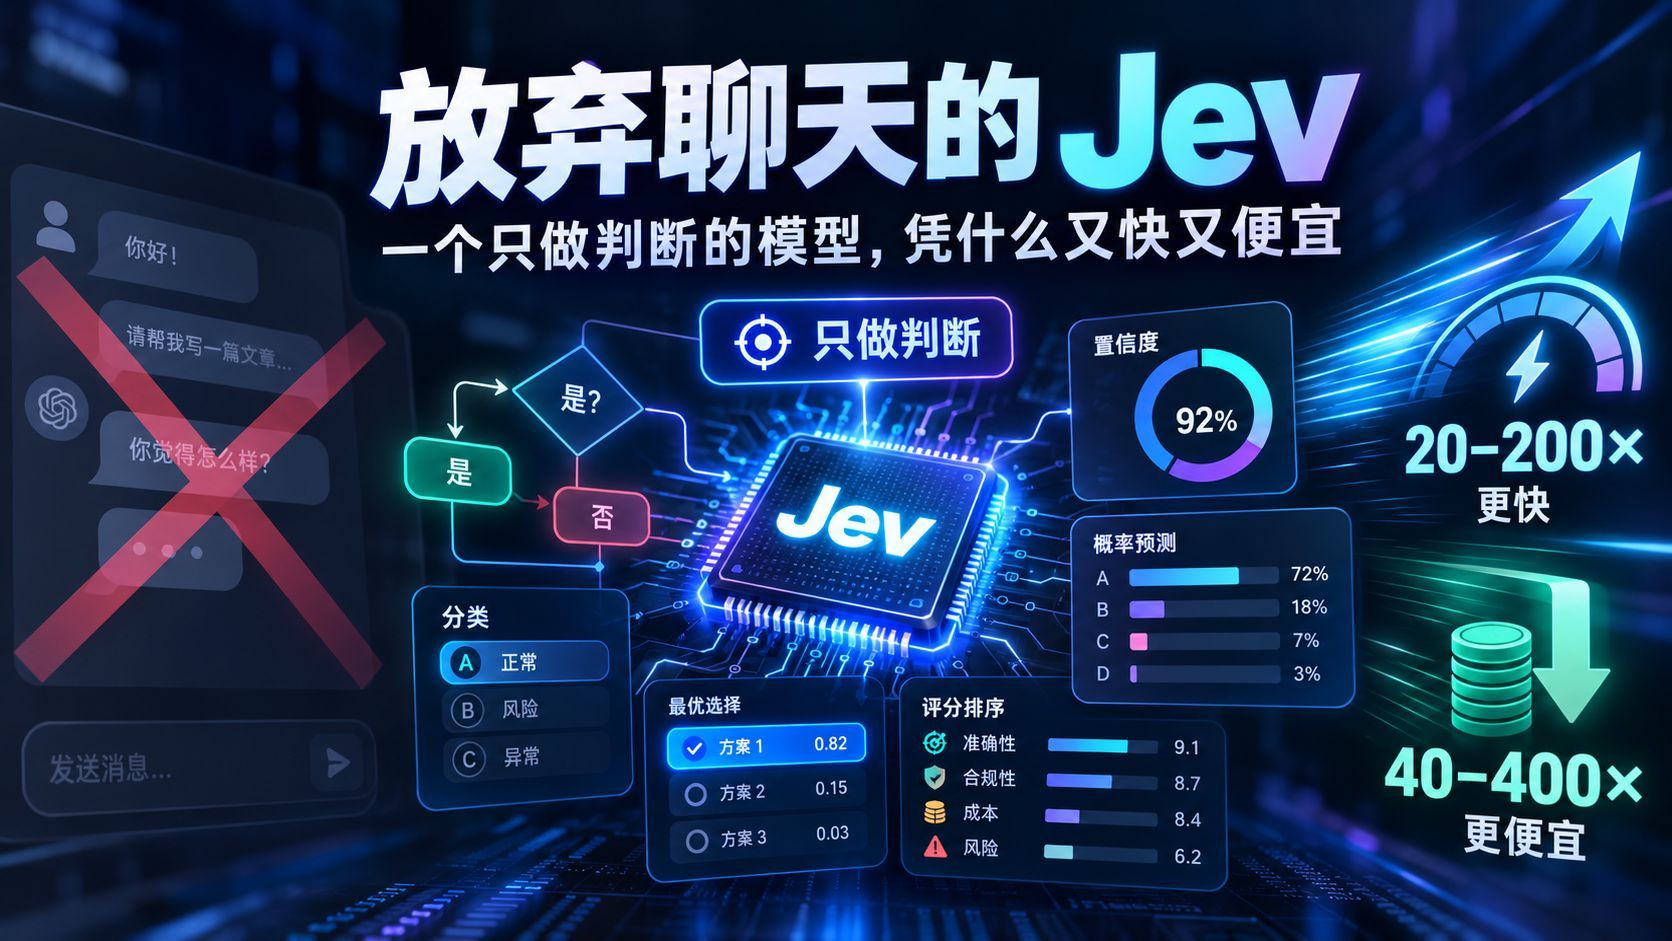
放弃聊天的 Jev:一个只做判断的模型,凭什么又快又便宜

TypeSafe AI 的新模型 Jev 不写文章,只返回判断和概率:官方测试中速度最高约为通用大模型的 193.6 倍,成本约为其 1/444.6,每百万输入 token 仅 0.042 美元,输出免费。它用 state 和 question 调用,以 Noul、Choice、Score 三种形式输出结果,并采用 RLCD 让概率直接用于自动分流,体现了判断、生成、执行的分工。

行业新闻 7 分钟

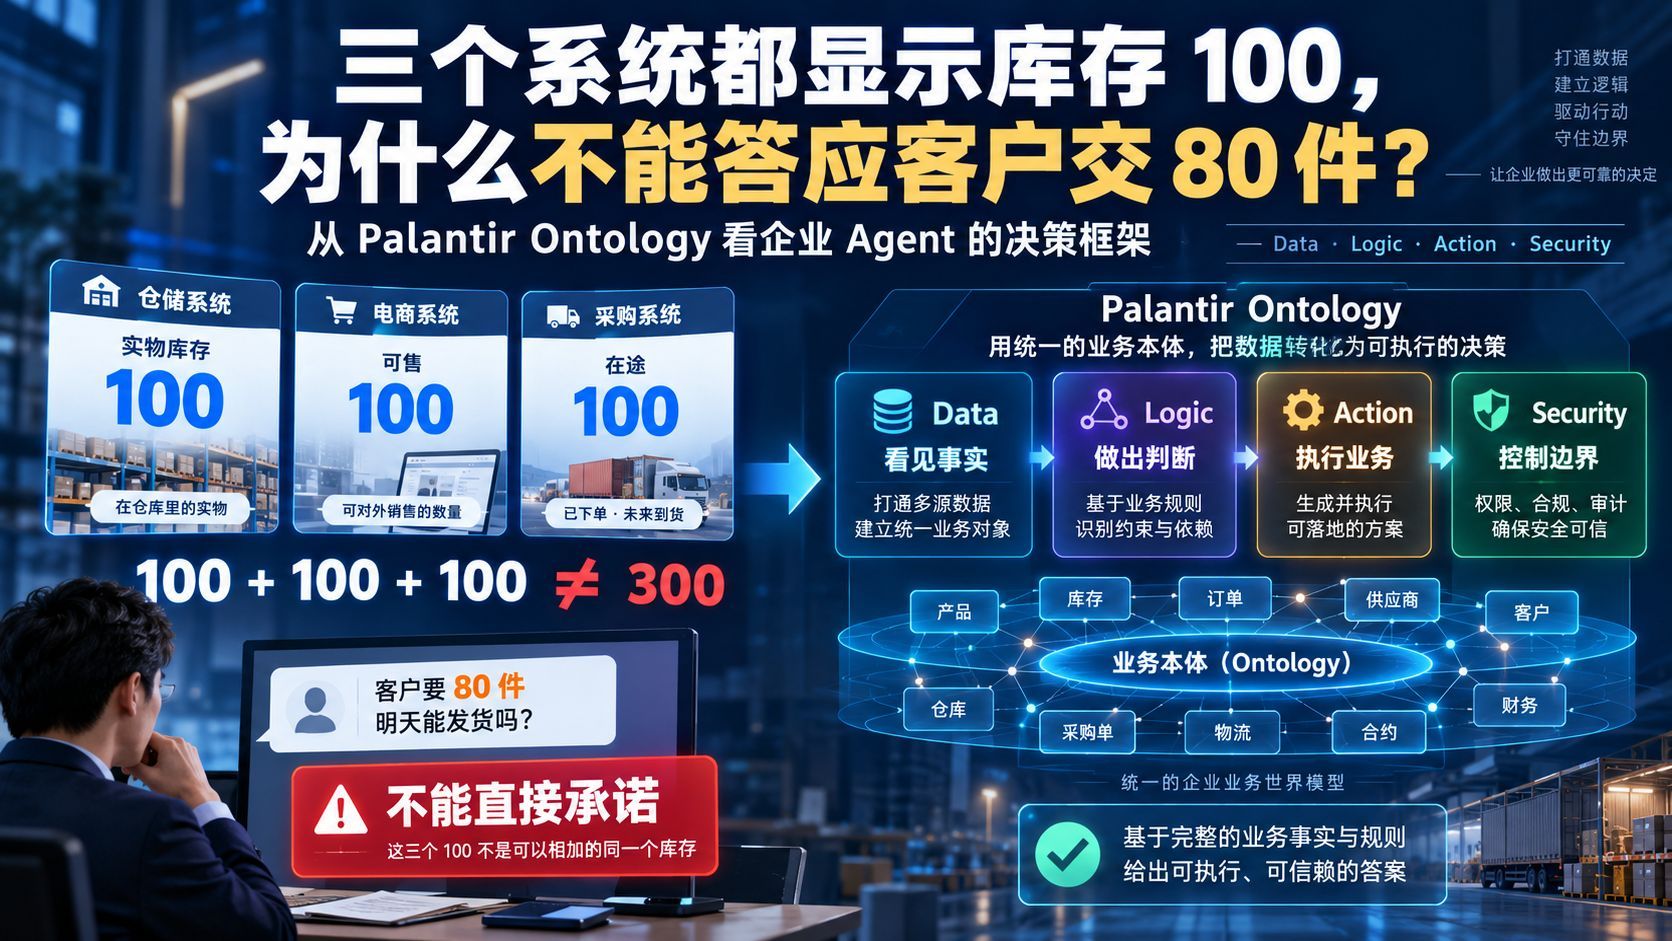
三个系统都显示库存100,为什么不能承诺交80件?——从 Palantir Ontology 看 Agent 时代的企业 AI

仓储、电商、采购三个系统各显示库存 100,加起来却不等于能交 300。Palantir 把真实业务决策拆成 Data、Logic、Action、Security 四部分,用 Object、Property、Link 描述业务世界,并让 AI 真正执行且受权限约束。本文用库存案例讲清 Ontology 的核心,并讨论大模型时代如何用 skills 与 MCP 复现这套理念:先做 Agent,再让 Ontology 随复杂度长出来。

开发事例 8 分钟

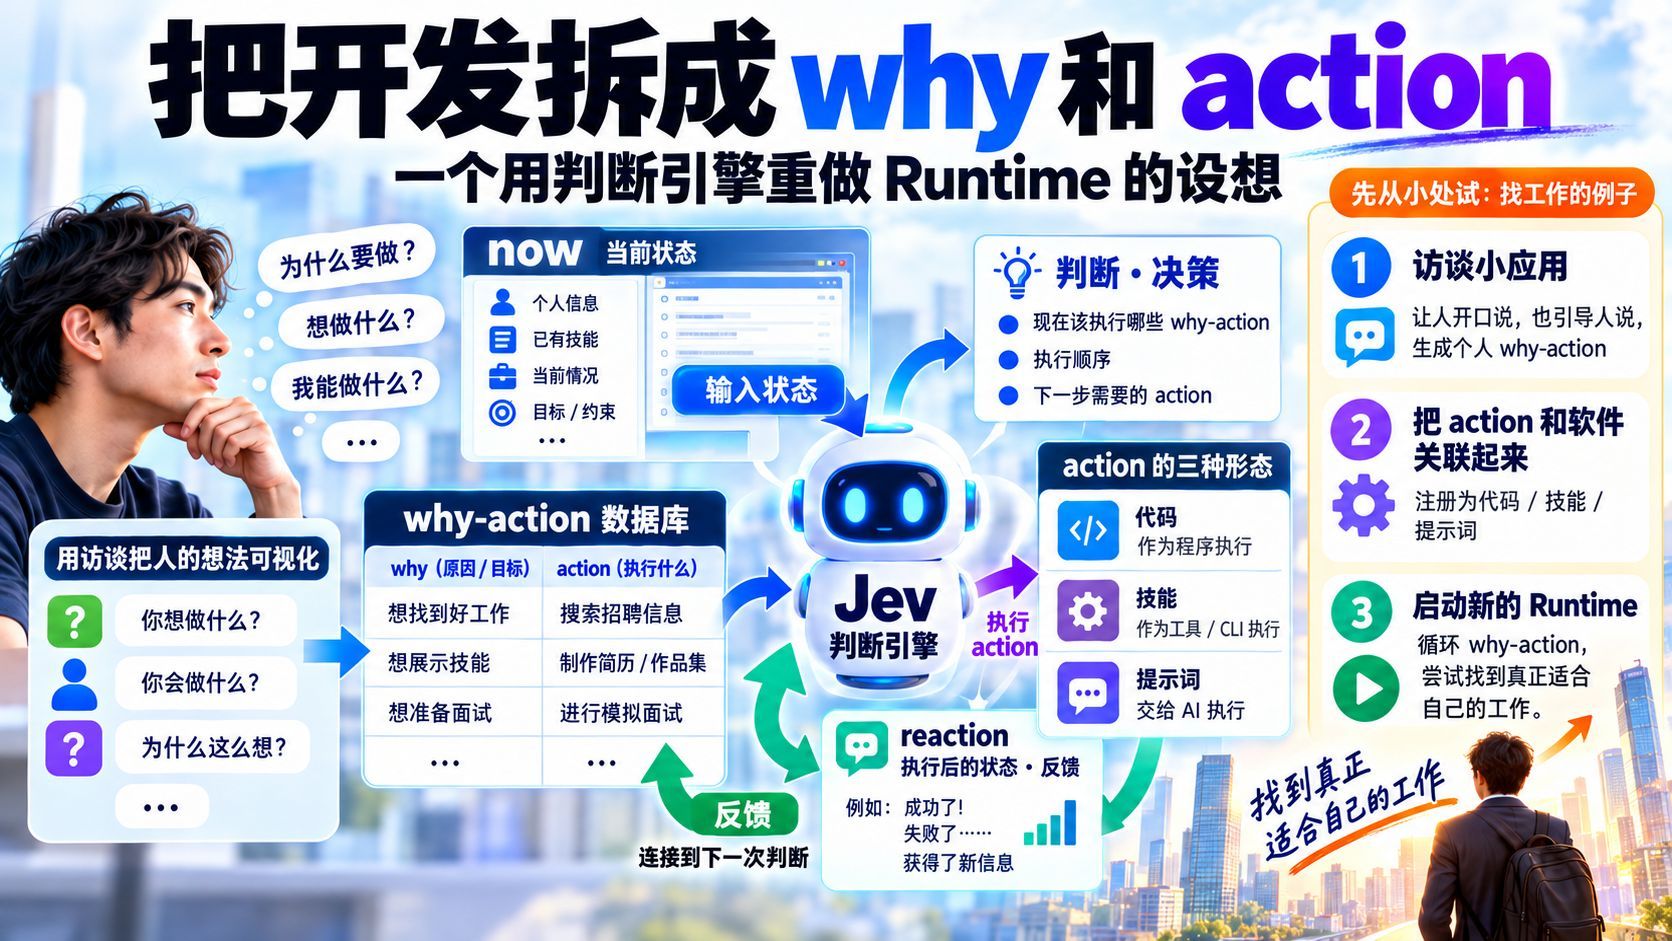
把开发拆成 why 和 action:用判断引擎重做 Runtime 的设想

从 2026 年出现的判断引擎 JVE 出发,把开发抽象成 why 与 action 的 key-value,设想一套由 now 状态驱动的新 runtime:输入当前状态,判断该优先执行哪些 why-action、按什么顺序执行。再把 action 之后的 reaction 作为新输入触发下一个 Y,用类似 browser use 的方式监听 now,并借 interview 帮人建立自己的 why-action 数据库。最后把范围缩小到「帮你找工作」,拆成 interview 应用、action 与软件关联、runtime 循环三步来试。

AI 动向 6 分钟

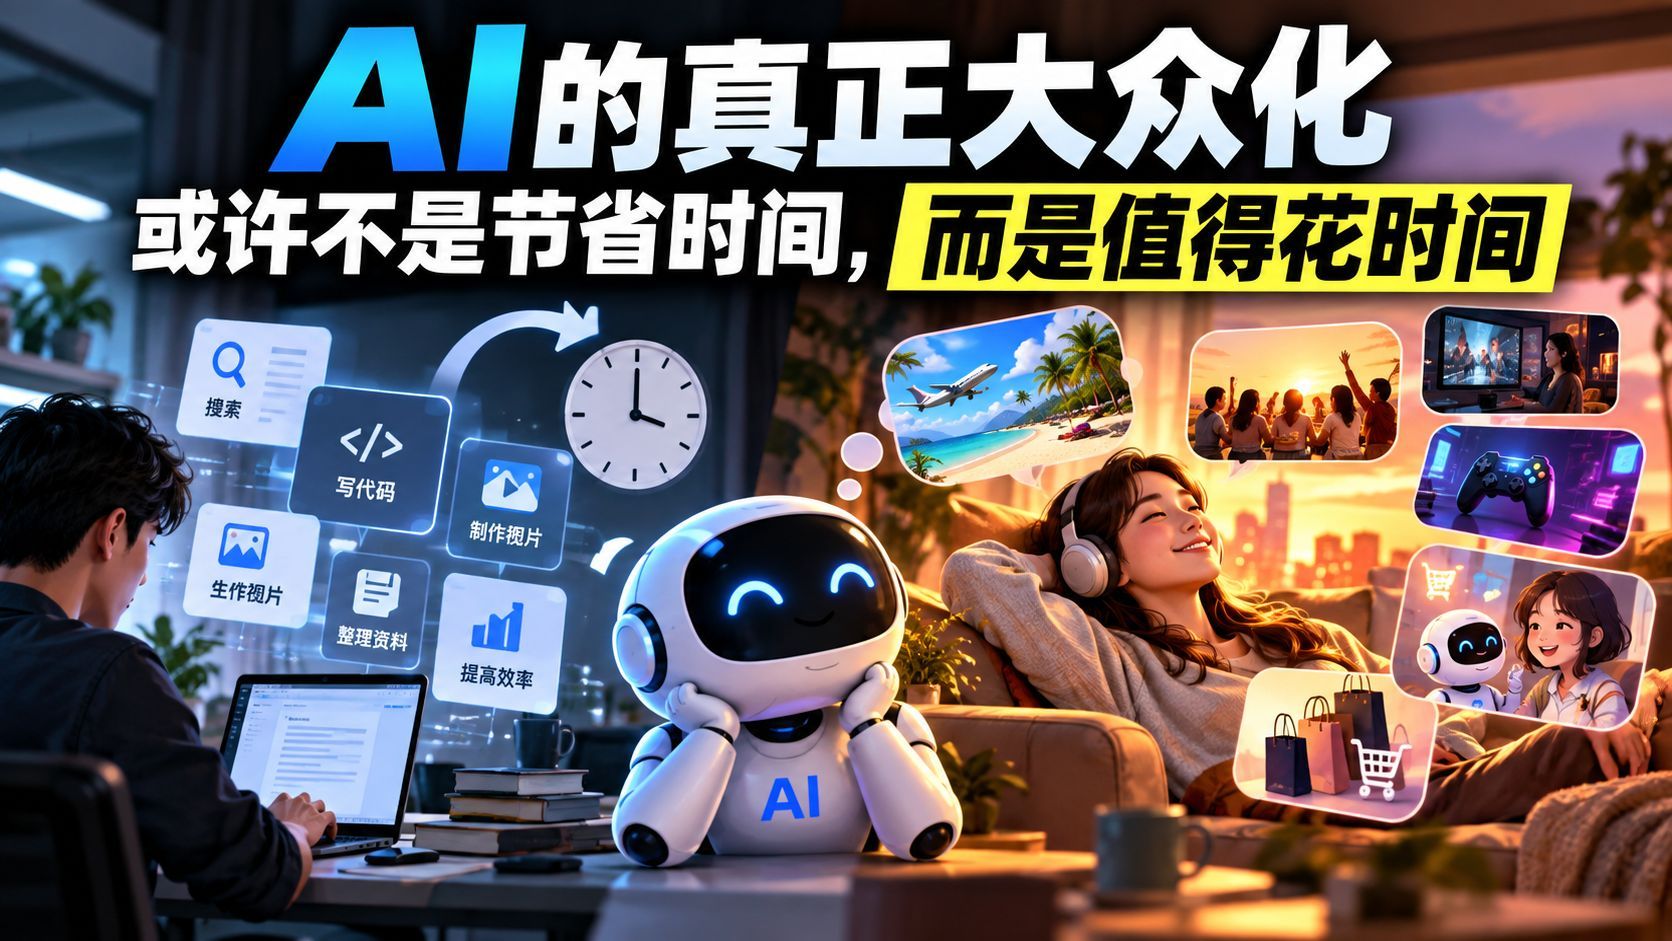
AI 真正的大众化,可能根本不是省时间

a16z 第七版报告呈现一组矛盾数据:美国近半数消费者用过 AI,但每天使用的只有约四分之一,持续为 ChatGPT、Gemini 或 Claude 付费的仅 4.5%;而付费用户顶部 1% 月均花费 903 美元。过去三年,AI 被当作节省时间的生产力工具来理解,但真正覆盖几十亿人的消费产品,靠的是让人愿意把时间留在里面。文章顺着个人智能体与订阅模式的演变,讨论消费级 AI 为何需要从效率走向体验。

行业新闻 7 分钟

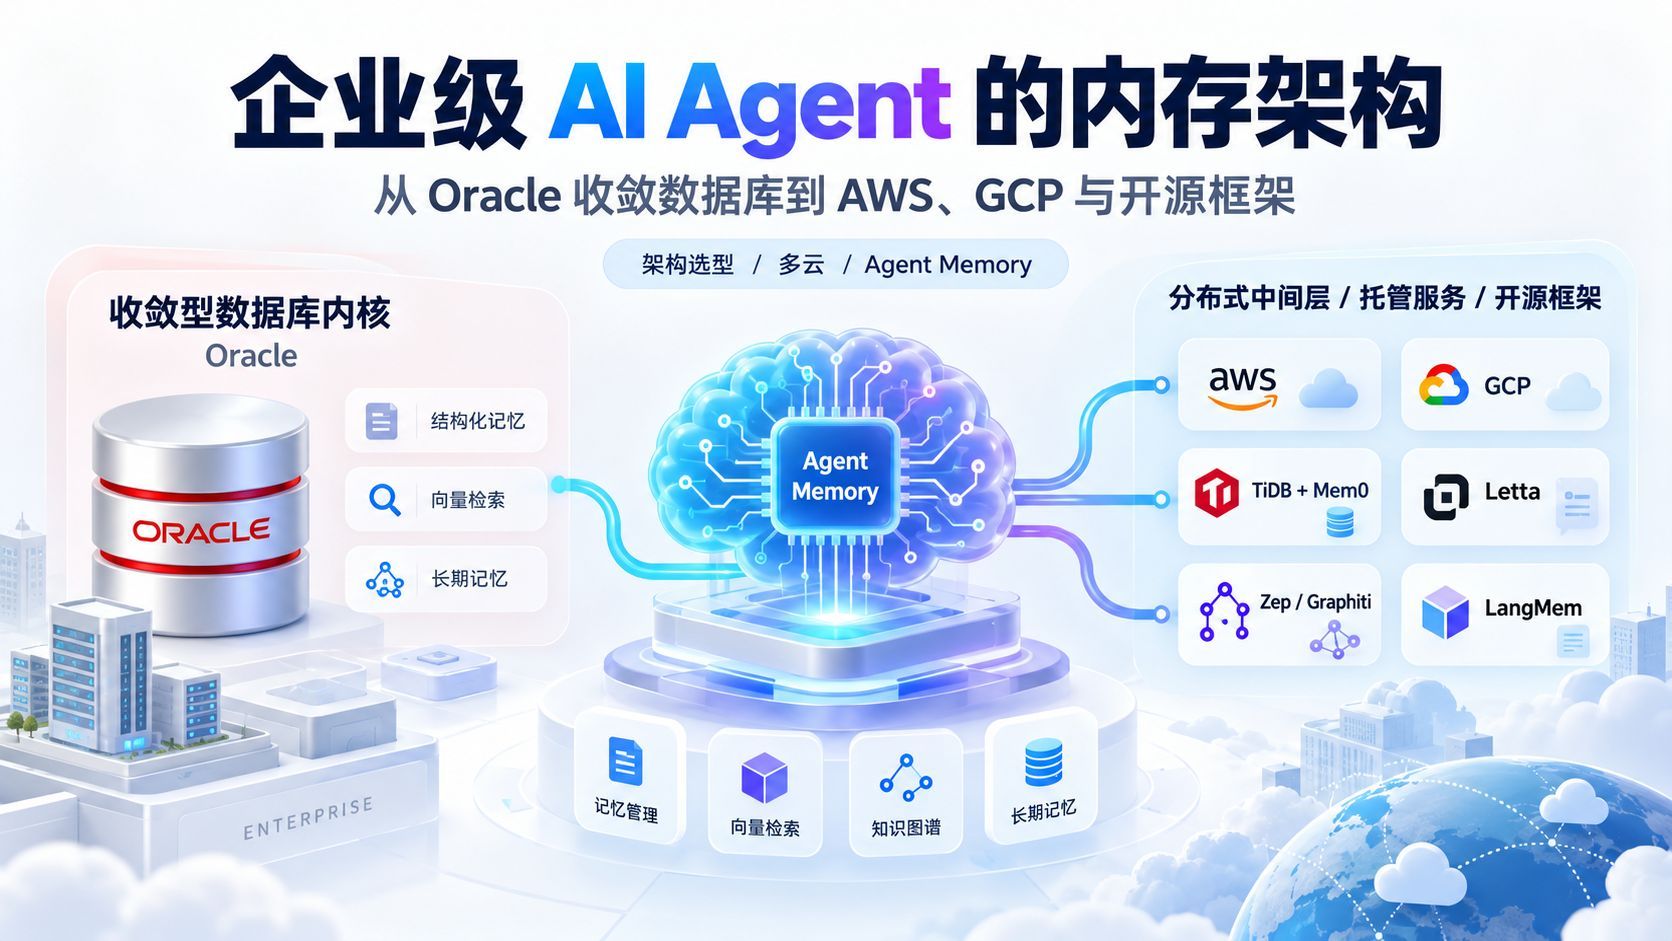
企业级 AI Agent 内存架构:Oracle、AWS、GCP 与开源方案的选型地图

当 AI Agent 开始承担跨天、跨周的长周期任务,内存便成为基础设施。本文梳理 Oracle AI Agent Memory 的收敛型数据库路线、TiDB Vector 加 Mem0 的分布式 HTAP 路线、AWS Bedrock AgentCore Memory 与 GCP Memory Bank 两套托管服务,并对比 Mem0、Letta、Zep/Graphiti、LangMem 四种开源框架,最后给出金融医疗、云原生、多租户 SaaS、强时序四类场景的选型参考与未来趋势。

杂谈 5 分钟

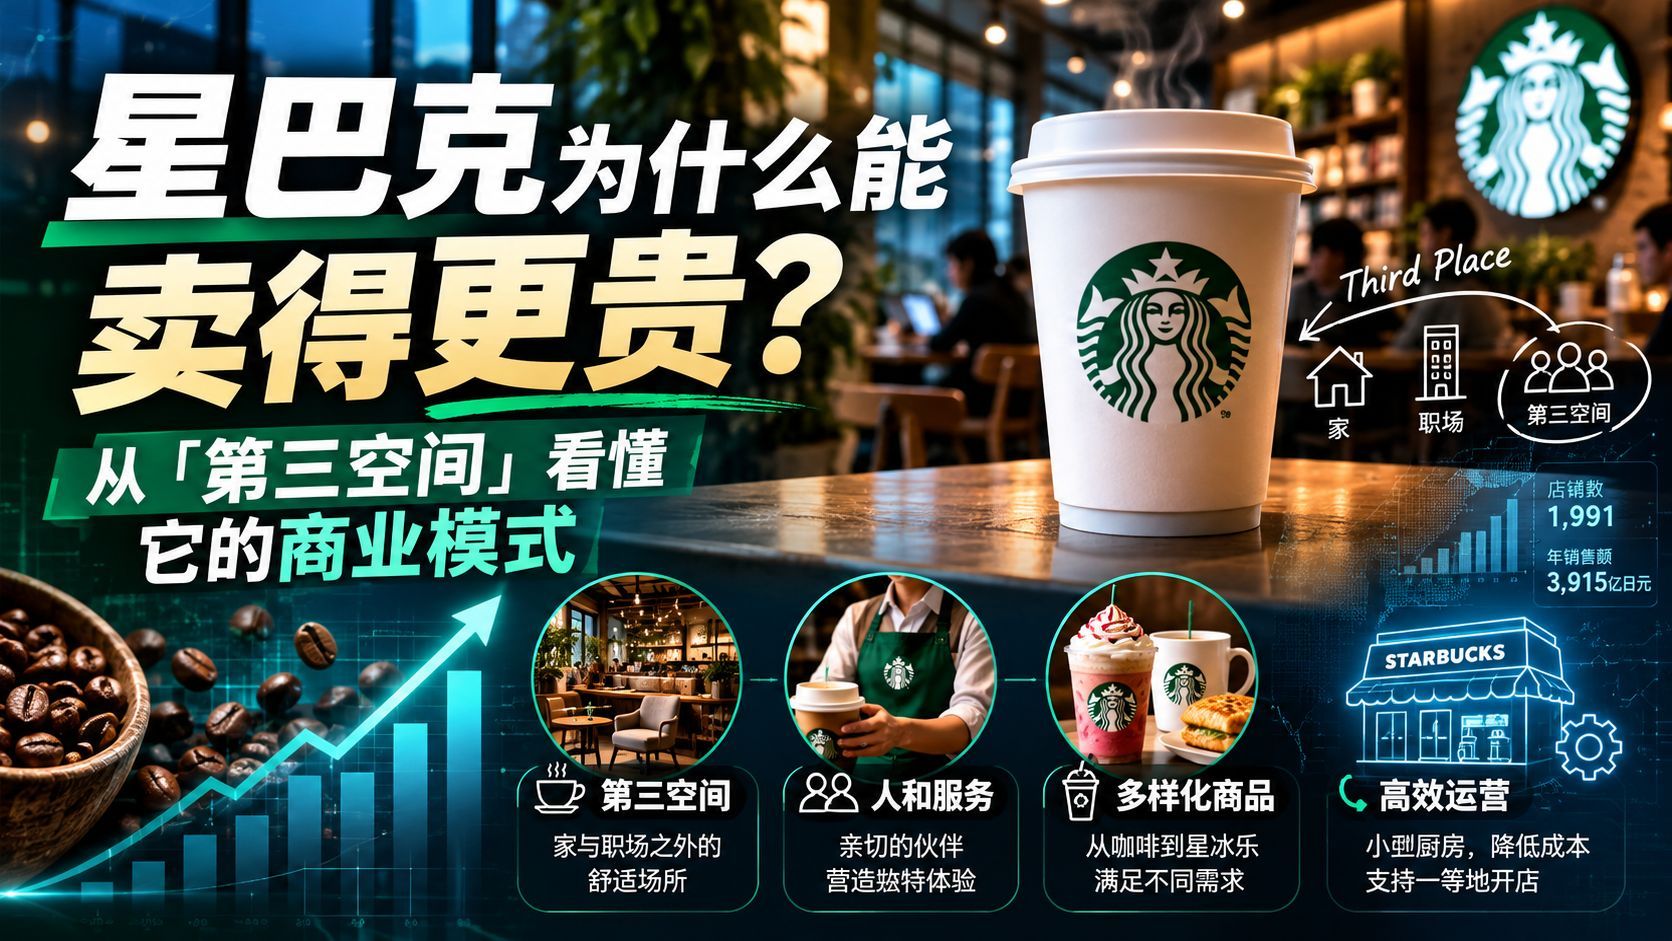
星巴克凭什么卖得更贵?从「第三空间」读懂什么是商业模式

星巴克的滴滤咖啡一杯380到510日元,比多特尔和 Tully's 都贵,却依然是日本最大的咖啡连锁。本文以星巴克为例,梳理它成功背后的第三空间、店员服务、商品战略与门店设计,进而区分商业模式的狭义定义与广义定义,并介绍战略分析、顾客洞察、模式适配三种构建路径及其利弊。

开发事例 8 分钟

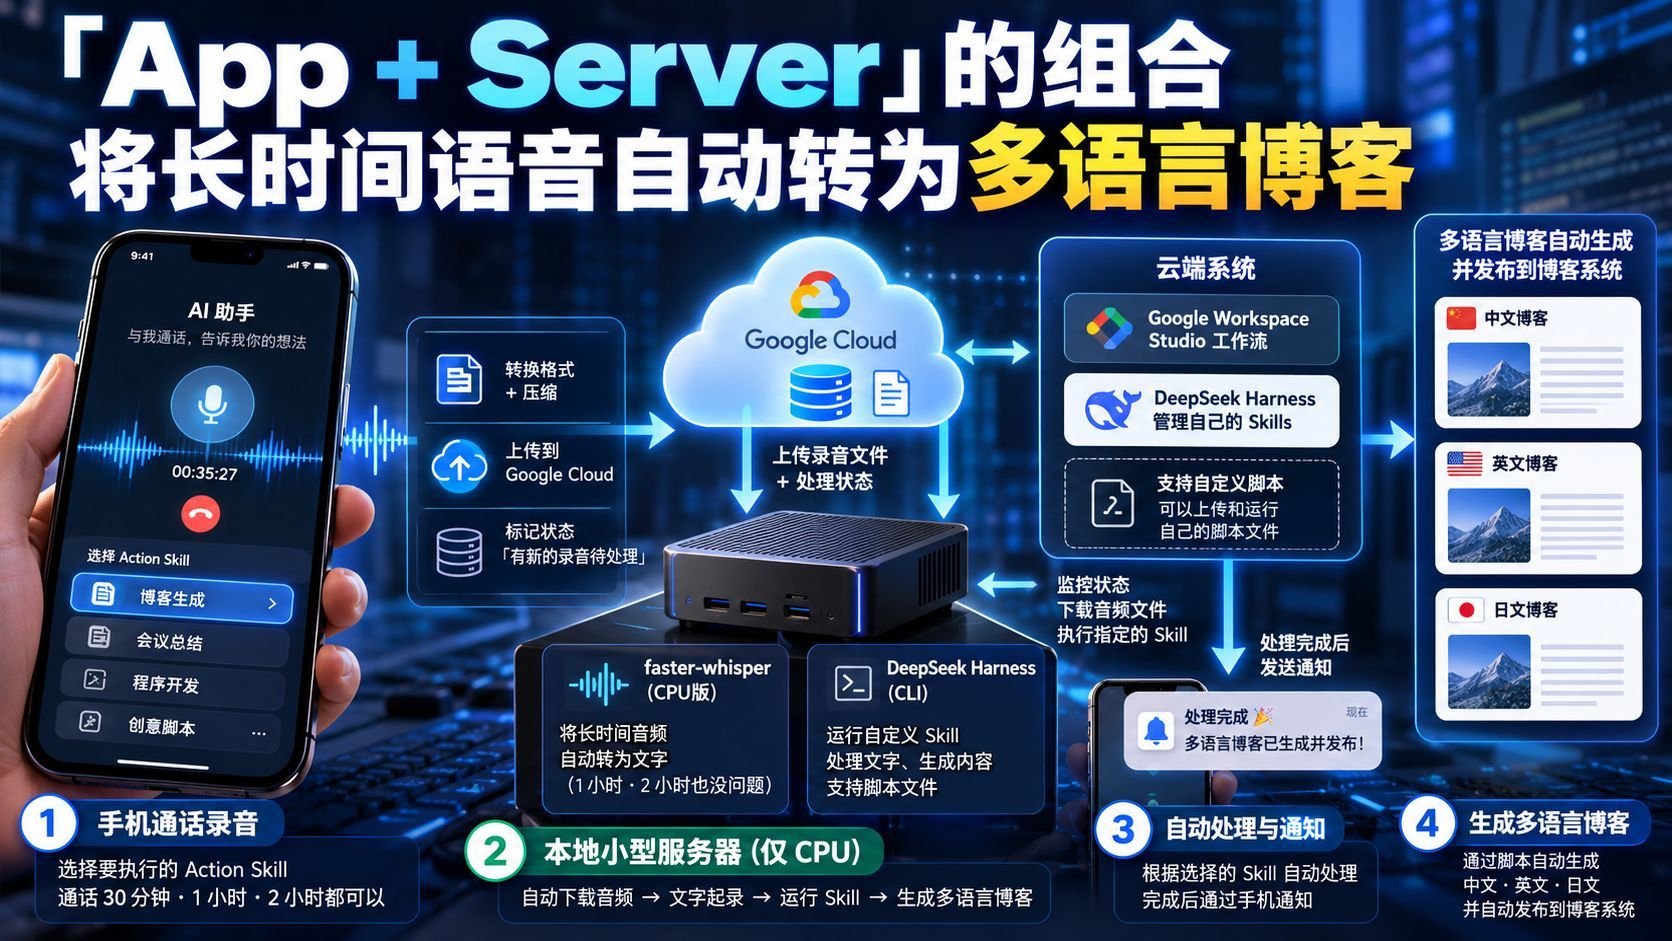
用一套「App + Server」,把长语音自动变成多语言博客

介绍我 9 月做的一套 App 加服务器语音处理系统。长时间的通话录音被压缩上传到谷歌云,再由一台只有 CPU、没有 GPU 的电脑轮询获取,用 faster-whisper 完成长音频转写,并通过 CLI 启动 DeepSeek Harness 运行 skill。云端系统支持上传自己的 skills 和脚本文件,处理完成后通过手机通知;脚本还能把内容转成三种语言并自动发布到博客。它在核心功能上接近 MUSE 和 Dota,但长语音转写只用 CPU、成本很低。下一步计划加入自动判断引擎,让系统自行决定执行哪些 Action Skills 以及执行顺序。

开发事例 7 分钟

AI Film Hackathon in Tokyo 参会记录:两小时用 Magnific 做出一部 AI 短片

我在东京参加了 AI Film 黑客松,会场位于富士通川崎塔,并首次使用了 AI 动画工具 Magnific。它内置 MiniMax H3 系列模型和 Google Flash 3.8 TTS,AI Agent 能自动操纵画布搭建 Base,约五小时的活动我不到两小时就完成了十七八段音频驱动视频,合计近两分钟,为宠物 App 制作的宣传 CM 还拿了奖。我也感到 coding agent 正让位于更有表现力的 AI 产品。

开发事例 7 分钟

Voice to Action 系统完成:用只有 CPU 的小电脑与 DeepSeek Harness 把录音变成三语博客

以“语音变行动”为理念的 Voice to Action 系统完成。它以家里一台只有 CPU 的小电脑作服务器,配合 App、云端与 Firestore 管理状态,用 Fast Whisper 把语音转成文字;再以 DeepSeek Harness 的 DeepSeek Flash 模型为引擎,执行带 script 的 skills,支持从云端上传并运行。最终实现从录音自动生成日中英三语博客,并通过 API 一键上传。整套方案轻量、不需要 GPU。